Как работает машинное обучение
Основная идея машинного обучения (ML) — позволить компьютерамучиться на данныхи выводить из них закономерности или регулярности, не полагаясь на явно написанные правила или код.
Простыми словами, рабочий процесс машинного обучения заключается в том, чтобы позволить машинам автоматически улучшать свои возможности принятия решений и прогнозирования на основе исторических данных.
Рабочий процесс машинного обучения можно упростить до следующих шагов:
- Сбор данных: Подготовьте данные, содержащие признаки и метки.
- Выбор модели: Выберите подходящий алгоритм машинного обучения в соответствии с задачей.
- Обучение модели: Позвольте модели изучать закономерности в данных и минимизировать ошибку.
- Оценка и валидация: Оцените производительность модели с помощью тестового набора и оптимизируйте её.
- Разверните модель: Примените обученную модель к реальным сценариям для прогнозирования.
- Непрерывное улучшение: По мере появления новых данных модель необходимо регулярно обновлять и оптимизировать.
Этот процесс позволяет компьютерам автоматически учиться на опыте и делать всё более точные прогнозы в различных задачах.
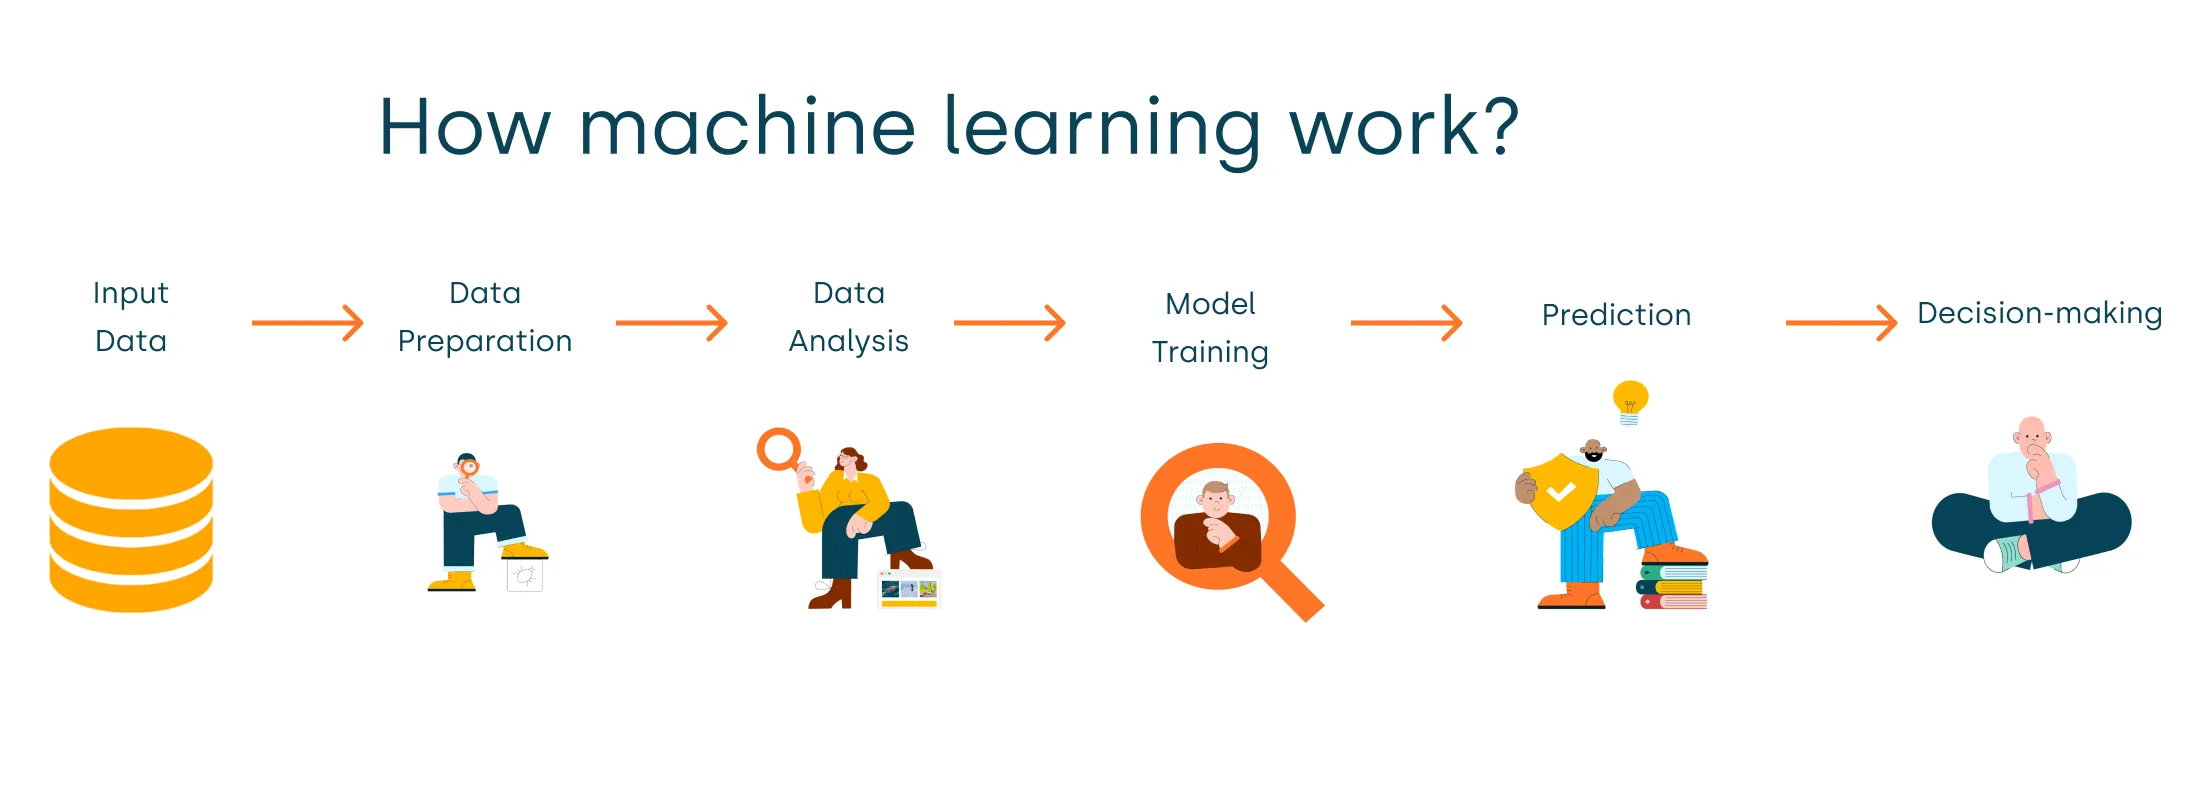
Мы можем понять, как работает машинное обучение, из следующих аспектов:
1. Ввод данных: данные — основа обучения
Первый шаг в машинном обучении — сбор данных. Без данных модель машинного обучения не может быть обучена. Данные обычно включают «входные признаки» и «метки»:
-
Входные признаки:Это фрагменты информации, которые модель использует для прогнозирования или классификации. Например, в задаче прогнозирования цены дома входными признаками могут быть площадь дома, местоположение, количество спален и т. д.
-
Метки:Метка — это результат, который мы хотим предсказать или классифицировать, обычно число или категория. Например, в задаче прогнозирования цены дома меткой является цена дома.
Цель модели машинного обучения — найти взаимосвязь между входными признаками и метками в данных и делать прогнозы на основе этих взаимосвязей.
2. Выбор модели: выберите подходящий алгоритм обучения
Модели машинного обучения (также называемые алгоритмами) — это инструменты, которые помогают компьютерам учиться на данных и делать прогнозы. В зависимости от характера данных и задачи распространённые модели машинного обучения включают:
-
Модели обучения с учителем:Имея размеченные данные, модель делает прогнозы, изучая взаимосвязь между входными данными и метками. Например,Линейная регрессия、Логистическая регрессия、Машина опорных векторов (SVM)иДерево решений。
-
Модели обучения без учителя:Без размеченных данных модель учится, исследуя структуру или закономерности в данных. Например,Кластеризация K-средних、Метод главных компонент (PCA)。
-
Модели обучения с подкреплением:Модель учится оптимальному поведению через награды и наказания во время взаимодействия со средой. Например,Q-обучение、Глубокое обучение с подкреплением(Deep Q-Networks, DQN)。
3. Процесс обучения: пусть модель учится на данных
На этапе обучения модель «учится» устанавливать связь между входными данными и метками на основе исторических данных, обычно путём минимизации функции потерь для оптимизации параметров модели. Процесс обучения можно кратко описать следующими шагами:
-
Начальное состояние:Модель начинает со случайных значений. Например, веса нейронной сети инициализируются случайным образом.
-
Вычисление предсказаний:Для каждого входного примера модель делает предсказание. Это делается путём передачи входных данных в модель и вычисления выходного значения.
-
Вычисление ошибки (потерь):Ошибка — это разница между предсказанным выходом модели и фактической меткой. Например, для задач регрессии ошибку можно измерить с помощью среднеквадратичной ошибки (MSE).
-
Оптимизация модели:Используя алгоритмы оптимизации, такие как обратное распространение (в нейронных сетях) или градиентный спуск, параметры модели (например, веса нейронной сети) непрерывно корректируются, чтобы минимизировать ошибку. Этот процесс называетсяобучением, пока модель не сможет делать относительно точные предсказания на обучающих данных.
4. Валидация и оценка: проверка производительности модели
После завершения процесса обучения нам нужно оценить производительность модели. Чтобы избежать переобучения модели на обучающих данных, мы разделяем данные наобучающую выборкуитестовую выборку, где:
- Обучающая выборка:Часть данных, используемая для обучения модели.
- Тестовая выборка:Часть данных, используемая для оценки качества модели; обычно не участвует в процессе обучения.
К распространённым метрикам оценки относятся:
- Accuracy:Доля правильных классификаций в задаче классификации.
- Mean Squared Error (MSE):Среднее квадратов разностей между предсказанными и истинными значениями в задачах регрессии.
- Precision и Recall:Используются в задачах бинарной классификации, особенно при несбалансированных классах.
- F1 Score:Среднее гармоническое точности и полноты, комплексно учитывающее качество классификатора.
5. Оптимизация и настройка: повышение точности модели
Если качество модели на тестовой выборке неудовлетворительно, может потребоваться дальнейшая оптимизация. Обычно это включает:
-
Настройка гиперпараметров:Например, скорость обучения, коэффициент регуляризации, глубина дерева и т. д. Эти гиперпараметры влияют на способность модели к обучению.
-
Выбор модели и ансамблирование:Попробуйте разные модели или ансамбли моделей (например, методы ансамблевого обучения, такие как Random Forest, XGBoost и т. д.), чтобы повысить точность.
-
Аугментация данных:Расширьте обучающий набор данных, например выполняя операции вроде поворота и отражения изображений, чтобы помочь модели улучшить обобщение.
6. Развёртывание модели и прогнозирование: применение в реальном мире
После того как модель показывает хорошие результаты на обучающих и тестовых данных, её можно развернуть в реальных приложениях:
-
Развёртывание модели:Встраивание обученной модели в такие системы, как приложения, веб-сайты, серверы и т. д., для использования пользователями.
-
Прогнозирование в реальном времени:В реальных средах новые данные подаются в модель, и модель выполняет прогнозирование или классификацию в реальном времени на основе ранее изученных закономерностей.
7. Непрерывное обучение и обновление модели:
Системы машинного обучения обычно не создаются за один раз. В реальных приложениях со временем постоянно появляются новые данные, поэтому модель необходимо регулярно обновлять и переобучать, чтобы поддерживать её способность к прогнозированию. Это можно реализовать с помощьюонлайн-обучения、трансферного обученияи других методов.
Другие расширения