Метрики классификации
В мире машинного обучения построение модели классификации — это лишь первый шаг. Как врач не может судить о болезни только по интуиции, нам также нужен набор научныхметрик проверки состояния, чтобы оценить здоровье модели. Эти метрики —метрики классификации, которые могут рассказать нам, насколько точны прогнозы модели, что она делает хорошо, а где она не дотягивает.
Сегодня мы вместе познакомимся с этими важнейшими инструментами оценки.
Зачем нам нужны метрики классификации?
Представьте, что вы обучили модель определять, является ли письмо спамом. Модель сделала прогнозы по 100 письмам, и вы можете спросить:
- "Сколько она предсказала правильно?" -> Это ведёт кточности。
- "Сколько из настоящих спам-писем она нашла?" -> Это ведёт кполноте。
- "Из писем, которые были названы спамом, сколько на самом деле являются спамом?" -> Это приводит кточности。
Если мы судим только по тому, сколько было правильных, это как оценивать студента только по общему баллу за экзамен, игнорируя много важной информации. В разных бизнес-сценариях разные приоритеты:
- Диагностика заболеваний: Мы больше заботимся о том, чтобы не пропустить ни одного пациента (высокая полнота), даже если это означает обследование большего числа здоровых людей (в ущерб некоторой точности).
- Фильтрация спама: Мы больше заботимся о том, чтобы не отправить важные письма в папку со спамом (высокая точность), даже если это означает пропуск некоторых спам-писем (в ущерб некоторой полноте).
Поэтому нам нужен ряд метрик, чтобы всесторонне оценить качество модели с разных точек зрения.
Ключевая концепция: матрица ошибок
Почти все метрики классификации происходят из мощного инструмента —матрицы ошибок.Это "панорамная карта" для понимания результатов предсказаний модели.
Что такое матрица ошибок?
Это таблица, которая показывает все четыре возможные ситуации между предсказанными результатами модели и истинными метками.
Пример
from sklearn.metrics import confusion_matrix
import seaborn as sns
import matplotlib.pyplot as plt
# Предположим, у нас есть истинные метки и предсказанные метки
y_true = [1, 0, 1, 1, 0, 0, 1, 0, 0, 1] # 1 обозначает спам, 0 обозначает обычное электронное письмо
y_pred = [1, 0, 0, 1, 0, 0, 1, 1, 0, 1] # Предсказания модели
# Вычислить матрицу ошибок
cm = confusion_matrix(y_true, y_pred)
print("Матрица ошибок:")
print(cm)
# Вывод может быть таким:
# [[4 1] # Истинное значение 0 (обычное), 4 предсказано как 0 (TN), 1 предсказано как 1 (FP)
# [1 4]] # Истинное значение 1 (спам), 1 предсказано как 0 (FN), 4 предсказано как 1 (TP)
Чтобы лучше понять это, давайте визуализируем:
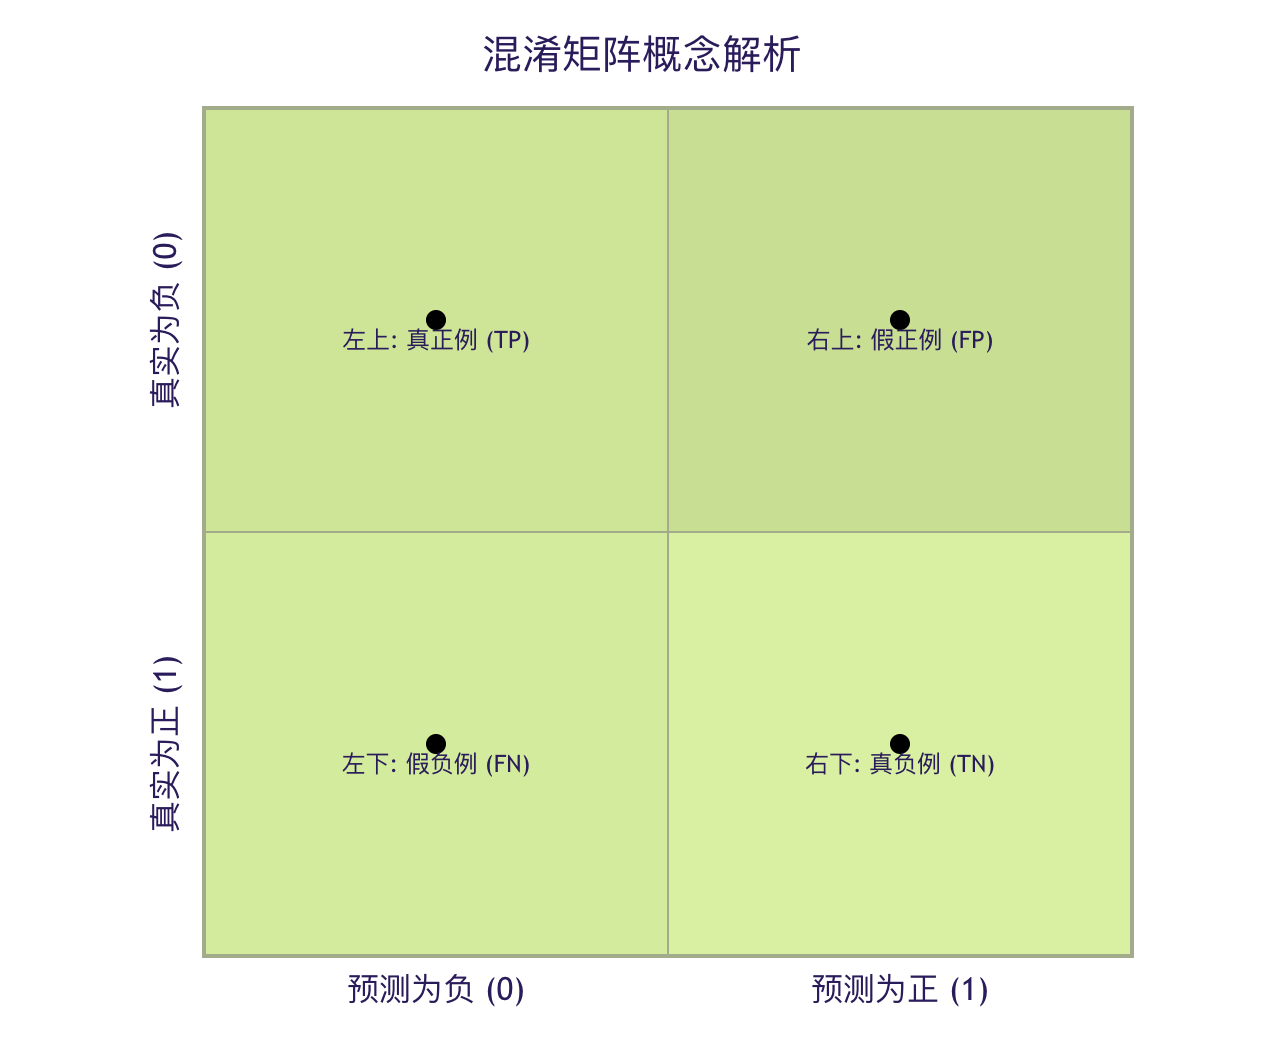
Разберём эти четыре основных термина:
| Термин | Сокращение | Значение | Объяснение на примере спама |
|---|---|---|---|
| Истинно положительный | TP | Модель предсказала какположительный, и фактическое значение такжеположительное。 | Правильно идентифицированные модельюспам-письма。 |
| Ложноположительный | FP | Модель предсказала какположительный, но фактическое значениеотрицательное。 | Модельошибочно классифицируеткак спамобычные письма。 (Ошибка I рода) |
| Истинно отрицательный | TN | Модель предсказала какотрицательный, и фактическое значение такжеотрицательное。 | Правильно идентифицированные модельюобычные письма。 |
| Ложноотрицательный | FN | Модель предсказала какотрицательный, но фактическиверно。 | Модельпропустилаизспам-писем。 (Ошибка II рода) |
Совет для запоминания:
- Верно/Неверноуказывает нато, верен ли прогноз。
- Положительный/Отрицательныйотносится крезультату прогноза модели。
3. Подробное объяснение основных метрик классификации
С помощью матрицы ошибок можно вывести различные метрики оценки так же, как при вычислении по формулам.
1. Accuracy - самая интуитивная метрика
Accuracyизмеряет долю правильно предсказанных образцов из общего числа образцов.
\[ \text{Accuracy} = \frac{TP + TN}{TP + TN + FP + FN} \]
Пример
точность = accuracy_score(y_true, y_pred)
print(f"Точность: {accuracy:.2f}") # Вывод: 0.80 (8/10)
Характеристики и ограничения:
- Преимущества: Очень интуитивно понятна и проста в понимании.
- Недостатки: Нанесбалансированных данных,это может вводить в заблуждение. Например, если 99% писем являются обычными, "глупая модель", которая предсказывает все письма как обычные, может также достичь точности 99%, но не сможет поймать ни одного спам-письма.
2. Точность — метрика «качество важнее количества»
Точностьпоказывает, сколько из предсказанных модельюположительных примеровдействительно являются истинно положительными. Она измеряетнадёжностьрезультатов предсказания илии точность.。
\[ \text{Precision} = \frac{TP}{TP + FP} \]
Вопрос: Среди писем, которые мы предсказали как спам, сколько на самом деле являются спамом?Высокая точность означает: Когда модель говорит "это спам", достоверность очень высока.
Пример
precision = precision_score(y_true, y_pred)
print(f"Точность: {precision:.2f}") # Вывод: 0.80 (TP=4, TP+FP=5)
3. Полнота — метрика «Лучше накинуть широкую сеть»
Полнотафокусируется на всех фактическихположительных примерахсколько из них было найдено моделью. Она измеряетспособность модели обнаруживать положительные примеры.。
\[ \text{Полнота} = \frac{TP}{TP + FN} \]
Вопрос: Из всех реальных спам-писем, сколько мы нашли?Высокая полнота означает: модель редко пропускает реальные спам-письма.
Пример
recall = recall_score(y_true, y_pred)
print(f"Полнота: {recall:.2f}") # Вывод: 0.80 (TP=4, TP+FN=5)
4. F1-мера — среднее гармоническое точности и полноты
Точность и полнота обычно находятся в противоречии (улучшение одной часто снижает другую).F1-мера— это среднее гармоническое этих двух, нацеленное на поиск баланса.
\[ \text{F1-мера} = 2 \times \frac{\text{Точность} \times \text{Полнота}}{\text{Точность} + \text{Полнота}} \]
Особенности среднего гармонического: оно склонно штрафовать экстремальные значения. Только когда и точность, и полнота высоки, F1-мера будет высокой.
Пример
f1 = f1_score(y_true, y_pred)
print(f"F1-мера: {f1:.2f}") # Вывод: 0.80
Руководство по сравнению и выбору метрик
| Метрика | Формула | Фокус | Примеры сценариев применения |
|---|---|---|---|
| Точность | (TP+TN)/Total | Общая точность прогнозирования | Сценарии, в которых классы сбалансированы, а затраты от FP и FN сопоставимы. |
| Precision | TP/(TP+FP) | Предсказаны как положительные:точность этих образцов. | Высокая стоимость FP.Например, фильтрация спама (боязнь удалить важные письма), рекомендательные системы (боязнь рекомендовать некачественные товары). |
| Полнота | TP/(TP+FN) | Фактически положительныеДоля образцов, которые были обнаружены | Стоимость FN высокаНапример, скрининг заболеваний (страх пропустить диагноз), обнаружение мошенничества (страх пропустить мошеннические транзакции). |
| F1-мера | 2PR/(P+R) | Баланс точности и полноты | Сценарии, требующие всестороннего рассмотрения без явного смещения; лучше, чем accuracy, когда классы несбалансированы. |
4. Продвинутые метрики: ROC-кривая и AUC
Когда результат предсказания модели является вероятностным значением (например, вероятность того, что письмо — спам, равна 0.8), нам нужно установитьпорог(например, 0.5), чтобы определить окончательную классификацию. ROC-кривая помогает оценить общую эффективность модели при различных порогах.
1. Доля истинно положительных и доля ложноположительных
- Доля истинно положительных (TPR): фактически являетсяполнотой。TPR = TP / (TP + FN)
- Доля ложноположительных (FPR): Доля всех фактически отрицательных образцов, которые ошибочно предсказаны как положительные. FPR = FP / (FP + TN)
2. ROC-кривая
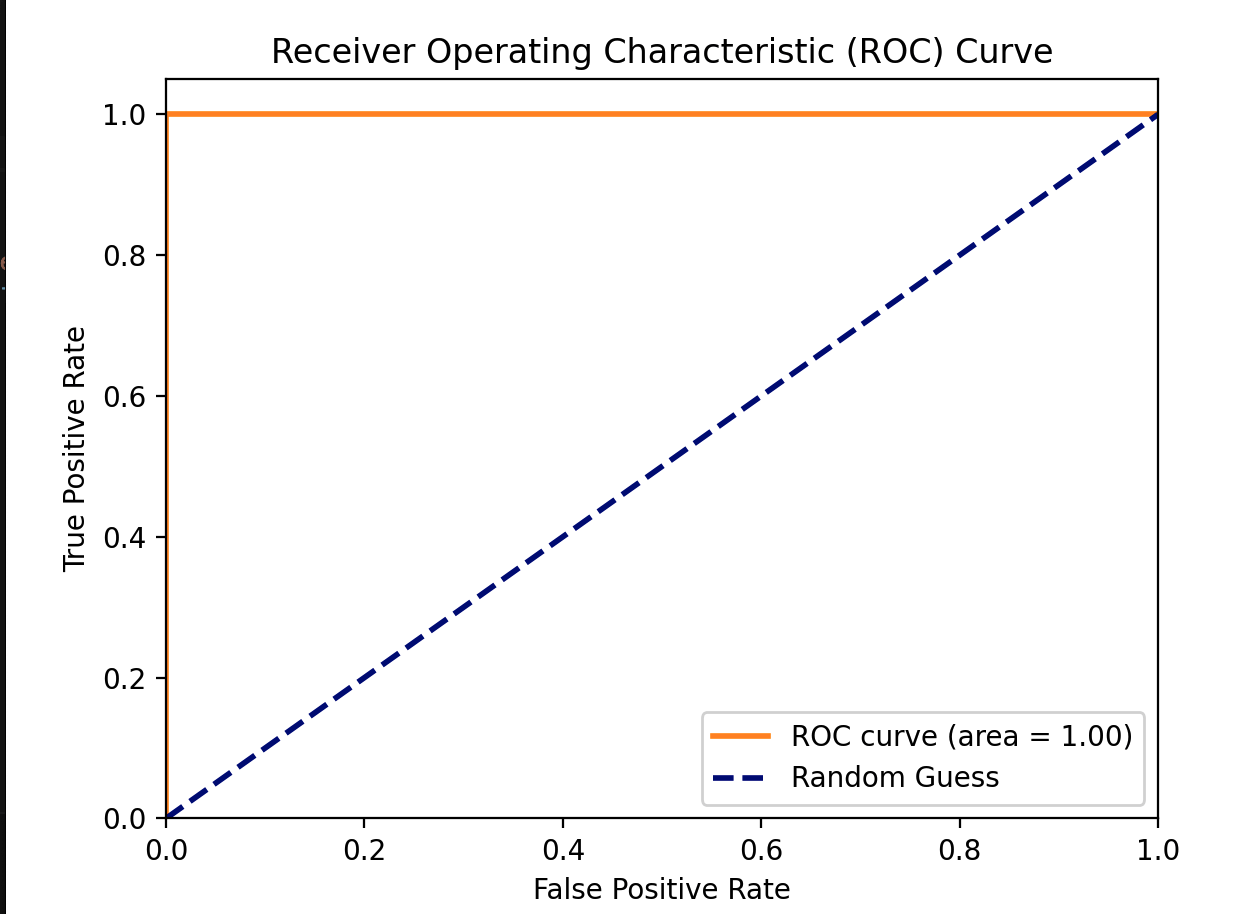
ROC-кривая используетFPR в качестве горизонтальной оси,TPR в качестве вертикальной оси. Каждая точка на кривой соответствует определённому порогу классификации.
- Идеальная точка: верхний левый угол (0, 1), т.е. FPR=0 (нет ложноположительных срабатываний), TPR=1 (все положительные распознаны).
- Случайная линия: диагональ от (0,0) до (1,1), отражающая качество модели случайного угадывания.
3. Значение AUC
AUC — это площадь под ROC-кривой.
- AUC = 1: идеальная модель.
- AUC = 0.5: модель не обладает дискриминирующей способностью, эквивалентно случайному угадыванию.
- 0.5 < AUC < 1: модель обладает некоторой предсказательной способностью; чем больше значение, тем лучше.
- AUC < 0.5: модель хуже случайного угадывания, обычно это означает, что направление предсказания инвертировано.
Преимущество AUC в том, что онанечувствительна к дисбалансу классов, и оценивает общую способность модели к ранжированию (способность ранжировать положительные примеры выше отрицательных).
Пример
import numpy as np
import matplotlib.pyplot as plt
# Предположим, у нас есть некоторые предсказанные вероятности (здесь сымитированы случайными числами)
y_true = [1, 0, 1, 0, 1]
y_scores = [0.9, 0.4, 0.6, 0.3, 0.8] # Вероятность того, что модель предскажет положительный пример
fpr, tpr, thresholds = roc_curve(y_true, y_scores)
roc_auc = auc(fpr, tpr)
print(f"Значение AUC: {roc_auc:.2f}")
# Построение ROC-кривой (необязательно, требует matplotlib)
plt.figure()
plt.plot(fpr, tpr, color='darkorange', lw=2, label=f'ROC-кривая (площадь = {roc_auc:.2f})')
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--', label='Случайное угадывание')
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('Доля ложноположительных результатов')
plt.ylabel('Доля истинно положительных результатов')
plt.title('Кривая рабочей характеристики приёмника (ROC)')
plt.legend(loc="lower right")
plt.show()
Вывод:
AUC 值: 1.00
Метрики для задач многоклассовой классификации
Когда классов больше двух (например, распознавание кошек, собак, кроликов), приведённые выше метрики можно расширить следующими способами:
- Макроусреднение: Сначала вычислите метрику для каждого класса (например, precision), затем возьмите среднее арифметическое метрик по всем классам.Все классы учитываются одинаково。
- Микроусреднение: Сначала агрегируйте TP, FP и т. д. по всем классам, затем используйте агрегированные значения для вычисления глобальной метрики.Каждый образец учитывается одинаково, при этом большее влияние оказывают классы с большим числом примеров.
В Scikit-learn можно указать с помощьюaverageпараметров:
Пример
# y_true и y_pred теперь являются многоклассовыми метками, например, [0, 1, 2, 0, 1]
precision_macro = precision_score(y_true, y_pred, average='macro') # Макро-усреднение
precision_micro = precision_score(y_true, y_pred, average='micro') # Микро-усреднение
6. Практическое упражнение: Комплексная оценка модели классификации
Теперь давайте попрактикуемся с реальным набором данных. Мы будем использовать знаменитый набор данных Iris.
Пример
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix, accuracy_score
# 1. Загрузить данные
iris = load_iris()
X = iris.data
y = iris.target
target_names = iris.target_names
# 2. Разделить на обучающую и тестовую выборки
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# 3. Обучить простую модель логистической регрессии
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# 4. Сделать предсказания на тестовом наборе
y_pred = model.predict(X_test)
y_pred_proba = model.predict_proba(X_test) # Получить предсказанные вероятности для AUC
# 5. Вычислить и вывести различные метрики
print("=== Матрица ошибок ===")
print(confusion_matrix(y_test, y_test))
# Примечание: матрица ошибок для многоклассовой классификации имеет размер N x N
print("\n=== Отчёт о классификации (включая precision, recall, F1) ===")
print(classification_report(y_test, y_pred, target_names=target_names))
# classification_report — очень удобная функция, которая выводит сразу несколько метрик.
print(f"\n=== Точность ===")
print(f"{accuracy_score(y_test, y_pred):.4f}")
# 6. Для многоклассового AUC обычно вычисляют AUC по стратегии "один против остальных" для каждого класса относительно остальных классов, затем берут среднее.
from sklearn.metrics import roc_auc_score
# Примечание: roc_auc_score требует указать multi_class='ovr' (один против всех) и average для многоклассовой классификации
try:
auc_ovr = roc_auc_score(y_test, y_pred_proba, multi_class='ovr', average='macro')
print(f"\n=== Средняя AUC (макро, OvR) ===")
print(f"{auc_ovr:.4f}")
except Exception as e:
print(f"\nОшибка вычисления AUC (некоторые классы могут отсутствовать в тестовом наборе): {e}")
Запустите этот код, и вы увидите полный отчёт об оценке модели. Попробуйте изменить параметры модели или использовать другую модель (напримерsklearn.tree.DecisionTreeClassifier) и понаблюдайте, как изменятся эти метрики.
=== 混淆矩阵 ===
[[19  0  0]
 [ 0 13  0]
 [ 0  0 13]]

=== 分类报告(包含精确率、召回率、F1)===
              precision    recall  f1-score   support

      setosa       1.00      1.00      1.00        19
  versicolor       1.00      1.00      1.00        13
   virginica       1.00      1.00      1.00        13

    accuracy                           1.00        45
   macro avg       1.00      1.00      1.00        45
weighted avg       1.00      1.00      1.00        45


=== 准确率 ===
1.0000

=== 宏平均 AUC (OvR) ===
1.0000
Другие расширения