Базовый фреймворк обучения с подкреплением
Представьте, что вы учите щенка команде "сидеть". Вы не стали бы напрямую объяснять ему, как должна двигаться каждая мышца при сидении; вместо этого вы бы сделали следующее:
- Вы даёте команду «сидеть».
- Щенок пробует какое-то действие (он может сесть, лечь или покрутиться).
- Если он сядет, вы сразу даёте ему лакомство в качестве награды.
- Если он ошибается, вы не даёте награду или подаёте лёгкий сигнал «неправильно».
- После многих попыток щенок постепенно понимает: услышав «сидеть», выполнение действия «сидеть» может принести лакомство. Так он выучивает команду.
Обучение с подкреплениемзаключается в том, чтобы позволить компьютеру (или агенту), подобно этому щенку, научиться принимать последовательность решений для достижения долгосрочной цели, взаимодействуя со средой и основываясь на получаемых наградах или наказаниях.
По сравнению с привычнымобучением с учителем(«учитель» со стандартными ответами) иобучением без учителя(поиск внутренней структуры данных), оно принципиально отличается. Обучение с подкреплением — этообучение на опыте, а его суть —пробы и ошибкииотложенная награда。
Основные элементы обучения с подкреплением
Чтобы формализовать этот процесс обучения, мы вводим несколько ключевых понятий, которые вместе составляют базовую структуру обучения с подкреплением.
Агент и среда
Это самое базовое взаимодействие в обучении с подкреплением.
- Агент:Это субъект обучения, сущность, принимающая решения. В приведённом выше примере щенок является агентом. В компьютере это может быть алгоритм, программа или робот.
- Среда:Это внешний мир, в котором существует агент и с которым агент взаимодействует. Для щенка среда — это вы, лакомства, пол и все внешние вещи. Среда принимает действия агента и предоставляет новые состояния и награды.
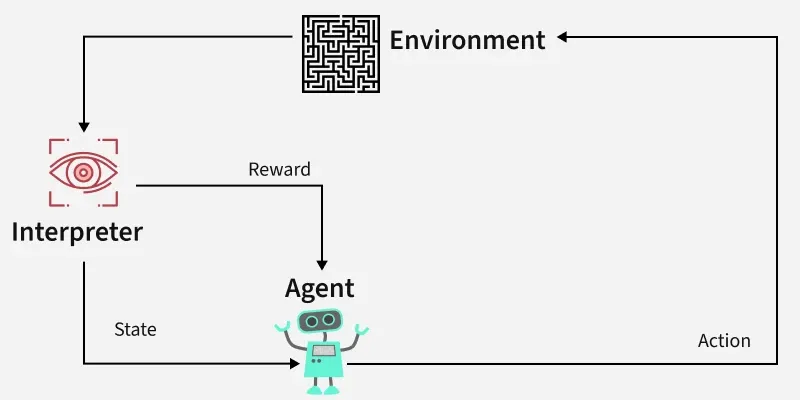
Их взаимодействие представляет собой непрерывный цикл:Агент наблюдает за средой -> совершает действие -> среда возвращает новое состояние и награду -> агент снова наблюдает...
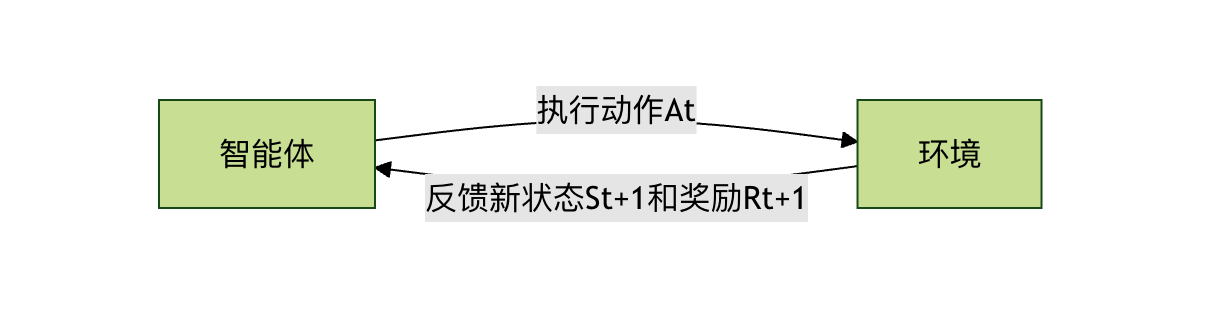
Состояние, действие и награда
Это три ключевых фрагмента информации, описывающих каждое взаимодействие.
- Состояние:В каждый момент — полное описание ситуации в среде. Например, в примере обучения щенка состояние может включать: щенок стоит, у вас в руке лакомство, и вы только что сказали «sit». Состояние — основа решений агента.
- Действие:Выборы, которые агент может сделать в определённом состоянии. Для щенка набор действий может быть {sit, lie down, stand, spin...}.
- Награда:Скалярный сигнал, который среда передаёт агенту после того, как агент выполняет действие. Он определяетчто хорошо, а что плохо. Награда — единственный компас для обучения агента. Дать щенку лакомство — положительная награда (+1); сказать «не так» можно рассматривать как небольшую отрицательную награду (-0.1).
Политика
Политика— это мозг или правило поведения агента. Она определяет, какое действие агент должен предпринять в любом заданном состоянии.
Политика может быть простой функцией табличного поиска или сложной глубокой нейронной сетью. Конечная цель обучения с подкреплением — найтиоптимальную политику, такую чтодолгосрочная суммарная награда, получаемая агентом из среды, максимизируется。
- .Пример: простая политика может быть такой: если состояние — «услышать команду sit», то выбирать действие sit с вероятностью 90% и выбирать другие действия с вероятностью 10%.
Функция ценности
Награды сообщают агентуо немедленной пользе или вреде текущегодействия, но агенту нужно больше заботиться одолгосрочнойотдаче.Функция ценности— это инструмент, используемый для измерения этой долгосрочной отдачи.
Он отвечает на вопрос: начиная с текущего состояния и следуя определённой политике до конца, какую суммарную награду я могуожидатьполучить?
- Функция ценности состояния V(s): оценивает долгосрочную ценность следования текущей политике в состоянии
ss. - Функция ценности действия Q(s, a): оценивает, в состоянии
ss,после выполнения конкретного действияaa, долгосрочную ценность последующего следования текущей политике. Её используют чаще, чем функцию ценности состояния, потому что она может напрямую направлять выбор действий.
Зачем нужна функция ценности?Представьте шахматную партию. Взятие пешки противника даёт небольшую немедленную награду, но может привести к мату через десять ходов и получению огромной отрицательной награды. С помощью вычислений и оценки функция ценности может помочь агенту избегать такого поведения, при котором он гонится за малым выигрышем и проигрывает всю партию.
Основной процесс взаимодействия: марковский процесс принятия решений
Задачи обучения с подкреплением обычно моделируются какмарковский процесс принятия решений (MDP). Это название звучит сложно, но на самом деле это всего лишь стандартная схема, которая организует перечисленные выше элементы в математической форме и описывает взаимодействие между агентом и средой.
Основная идея MDP такова:Следующее состояние и награда зависят только от текущего состояния и текущего выполненного действия и не зависят от предыдущей истории(т. е. свойство Маркова).
Полный цикл взаимодействия в MDP выглядит следующим образом:
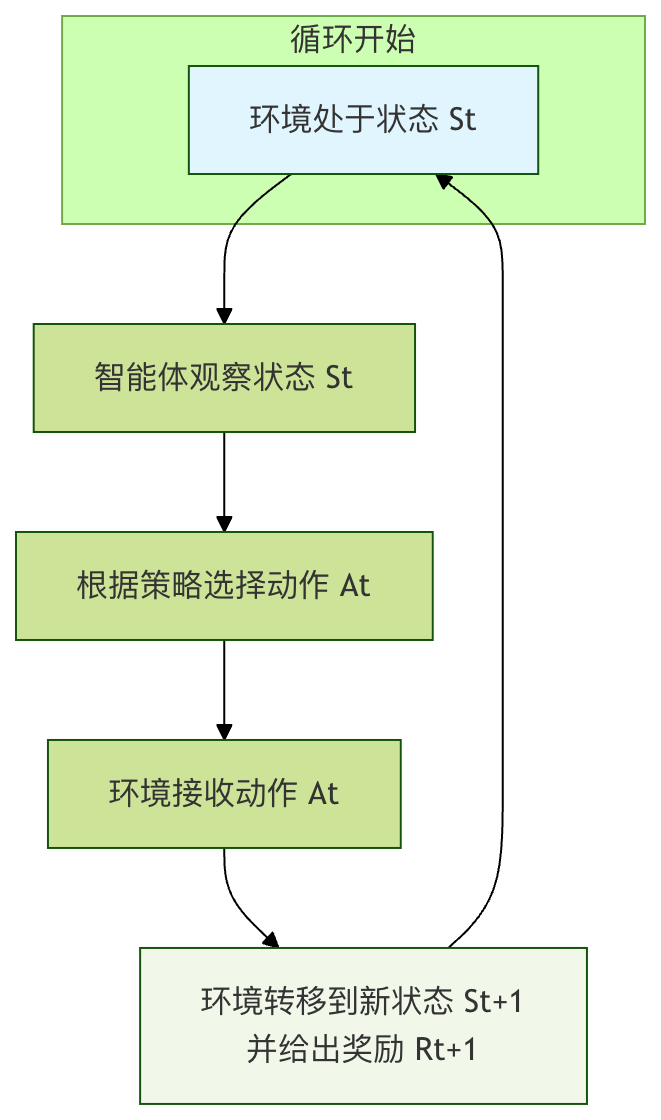
- На временном шаге
tt среда находится в состоянииS_t。 - S_t. Агент наблюдает это состояние.
- Агент, согласно своей политике
ππ, выбирает действиеA_t。 - A_t. Среда получает это действие.
- Среда, согласно своим внутренним динамическим правилам, переходит в следующее состояние
S_{t+1}S_{t+1}, и производит скалярное вознаграждениеR_{t+1}R_{t+1}, которое передается обратно агенту. - Временной шаг увеличивается (
t = t+1t = t+1), и начинается новый цикл.
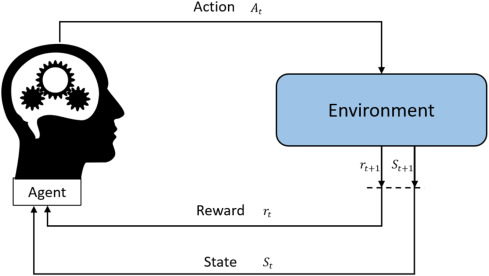
Цель агента — непрерывно испытывая этот цикл, выучить политикуπ*π, такую что, начиная из любого начального состояния,ожидаемое значение совокупного вознаграждения (т.е. дохода) максимизируется。
Простой пример кода: Сеточный мир
Давайте воспользуемся классическим примером с сеточным миром, чтобы сделать эти концепции конкретными. Предположим, есть сетка 4x4. Агент стартует из начальной точкиSS, с целью достижения терминальной точкиGT. Попадание в препятствие#X означает неудачу, и каждый шаг имеет небольшой штраф (чтобы стимулировать как можно более быстрое достижение конца).
S . . .
. # . .
. . # .
. . . G
- Состояние: координаты каждой клетки сетки, например (0,0), (0,1)... (3,3). Всего 16 состояний.
- Действие: {up, down, left, right}.
- Награда:
- : Достижение T: +10
G: +10 - Попадание в X
#или выход за границы: -5 - Другие обычные ходы: -0.1 (поощряет эффективные пути)
- : Достижение T: +10
- Политика: Нам нужно обучить таблицу, которая хранит для каждого состояния (клетки сетки), в каком направлении идти.
Ниже приведена крайне упрощённая демонстрация псевдокода Q-learning (классического алгоритма обучения с подкреплением), используемая для обучения оптимальному пути в этом сеточном мире.
Пример
import random
from typing import Dict, List, Tuple
# ====================== 1. Моделирование среды (Сеточный мир) ======================
class GridWorldEnv:
"""Простая среда сеточного мира для демонстрации Q-обучения"""
def __init__(self, grid_size: Tuple[int, int] = (5, 5),
start_pos: Tuple[int, int] = (0, 0),
goal_pos: Tuple[int, int] = (4, 4),
obstacle_pos: List[Tuple[int, int]] = [(1, 1), (2, 2), (3, 1)]):
self.grid_size = grid_size
self.start_pos = start_pos
self.goal_pos = goal_pos
self.obstacle_pos = obstacle_pos
self.current_pos = start_pos
# Определения действий: 0-вверх, 1-вниз, 2-влево, 3-вправо
self.actions = ['up', 'down', 'left', 'right']
self.num_actions = len(self.actions)
def reset(self) -> int:
"""Сбросить среду и вернуть индекс начального состояния"""
self.current_pos = self.start_pos
return self.pos_to_state(self.current_pos)
def pos_to_state(self, pos: Tuple[int, int]) -> int:
"""Преобразовать координатную позицию в индекс состояния"""
return pos[0] * self.grid_size[1] + pos[1]
def state_to_pos(self, state: int) -> Tuple[int, int]:
"""Преобразовать индекс состояния в координатную позицию"""
return (state // self.grid[1], state self.grid_size[1])
def random_action(self) -> int:
"""Nalliunngitsumik suliaq naliutigilugu (qaujisarniq)"""
random randint.self(0, num_actions.num_actions - 1)
def action_to_direction(self, action: int) -> str:
"""Suliaq index-kiq tungaa ateq-mut asijjii"""
return self.actions[action]
def step(self, action: int) -> Tuple[int, float, bool]:
"""
Suliaq suliatigilugu, utertitsi (next_state, reward, done)
Piujuartitsinirmut tukki: bug nalliuti, pinnakkut nagligut aqqutigiliqattarunngitsoq, isumaliuqusiq eqqartuussineq ajurnngili.
"""
x, y = self.current_pos
# Обновить позицию в соответствии с действием
if action == 0: # вверх
x = max(0, x - 1)
elif action == 1: # вниз
x = min(self.grid_size[0] - 1, x + 1)
elif action == 2: # влево
y = max(0, y - 1)
elif action == 3: # вправо
y = min(self.grid_size[1] - 1, y + 1)
# Проверить, произошло ли столкновение с препятствием (ключевое исправление: сначала зафиксировать, произошло ли столкновение с препятствием, затем обработать позицию)
new_pos = (x, y)
hit_obstacle = False # Отметить, произошло ли столкновение с препятствием
if new_pos in self.obstacle_pos:
hit_obstacle = True # Записать статус столкновения с препятствием
new_pos = self.current_pos # Столкновение с препятствием, позиция не изменена
self.current_pos = new_pos
next_state = self.pos_to_state(new_pos)
# Вычислить награду (на основе заранее записанного hit_obstacle, исправить противоречие в исходной логике)
if new_pos == self.goal_pos:
reward = 100.0 # Достигнута цель, большая награда
done = True
elif hit_obstacle: # На основе флага, а не изменённого new_pos
reward = -50.0 # Столкновение с препятствием, штраф
done = False
else:
reward = -1.0 # Небольшой штраф за каждый шаг, стимулирующий быстрое достижение цели
done = False
return next_state, reward, done
# ====================== 2. Основная программа Q-обучения ======================
if __name__ == "__main__":
# Оптимизация 1: Зафиксировать случайное зерно, чтобы обеспечить воспроизводимость результатов эксперимента
random_seed = 42
random.seed(random_seed)
np.random.seed(random_seed)
# Инициализировать среду
env = GridWorldEnv(
grid_size=(5, 5), # сетка 5x5
start_pos=(0, 0), # начальная точка
goal_pos=(4, 4), # целевая точка
obstacle_pos=[(1,1), (2,2), (3,1)] # позиции препятствий
)
# Вычислить количество состояний
num_states = env.grid_size[0] * env.grid_size[1]
num_actions = env.num_actions
# Инициализируйте Q-таблицу (функцию ценности действия) с формой [num_states, num_actions]
Q_table = np.zeros([num_states, num_actions])
# Определите гиперпараметры
learning_rate = 0.1 # скорость обучения
discount_factor = 0.9 # коэффициент дисконтирования
epsilon = 0.1 # скорость исследования
total_episodes = 1000 # количество эпизодов обучения
# Процесс обучения
for episode in range(total_episodes):
state = env.reset() # Сбросить среду в начальную точку, получить начальное состояние S
done = False # Флаг, завершается ли этот эпизод
total_reward = 0 # Записать общую награду за этот эпизод
while not done:
# 1. ε-жадная политика выбора действия
if random.uniform(0, 1) < epsilon:
action = env.random_action() # Исследование: случайно выбрать действие
else:
# Эксплуатация: выбрать действие с наибольшим значением Q, обработать равенства
q_values = Q_table[state]
max_q = np.max(q_values)
best_actions = np.where(q_values == max_q)[0]
action = random.choice(best_actions) # Случайно выбрать одно при равенстве
# 2. Выполнить действие и взаимодействовать со средой
next_state, reward, done = env.step(action)
total_reward += reward
# 3. Обновить Q-таблицу (ядро: формула Q-Learning)
# Q(S, A) = Q(S, A) + α * [ R + γ * max(Q(S', a')) - Q(S, A) ]
old_value = Q_table[state, action]
next_max = np.max(Q_table[next_state]) # Максимальное Q-значение следующего состояния
# Вычислить целевое Q-значение
target = reward + discount_factor * next_max
# Обновить Q-значение
new_value = old_value + learning_rate * (target - old_value)
Q_table[state, action] = new_value
# 4. Перейти к следующему состоянию
state = next_state
# Выводить прогресс обучения каждые 100 эпизодов
if (episode + 1) % 100 == 0:
print(f"Эпизод {episode + 1}/{total_episodes}, Общая награда: {total_reward:.1f}")
# ====================== 3. Извлечение оптимальной политики (оптимизированный формат вывода, более наглядный) ======================
policy: Dict[int, str] = {}
print("\n=== Оптимальная политика после обучения (в виде сетки) ===")
# Оптимизация 2: Вывод в виде сетки для наглядного отображения политики всей сетки
grid_rows, grid_cols = env.grid_size
for row in range(grid_rows):
row_str = []
for col in range(grid_cols):
pos = (row, col)
state = env.pos_to_state(pos)
if pos in env.obstacle_pos:
row_str.append(" Препятствие ")
elif pos == env.goal_pos:
row_str.append(" Цель ")
elif pos == env.start_pos:
# Также отметьте начальную точку и её оптимальное действие
best_action_idx = np.argmax(Q_table[state])
best_action = env.action_to_direction(best_action_idx)
row_str.append(f" Старт({best_action}) ")
else:
best_action_idx = np.argmax(Q_table[state])
best_action = env.action_to_direction(best_action_idx)
policy[state] = best_action
row_str.append(f" {best_action} ")
print("|".join(row_str))
# ====================== 4. Проверка оптимальной политики ======================
print("\n=== Проверка оптимальной политики ===")
state = env.reset()
done = False
steps = 0
path = [env.state_to_pos(state)]
while not done and steps < 50: # Максимум 50 шагов, чтобы предотвратить бесконечные циклы
best_action_idx = np.argmax(Q_table[state])
next_state, reward, done = env.step(best_action_idx)
current_pos = env.state_to_pos(next_state)
path.append(current_pos)
state = next_state
steps += 1
print(f"Путь: {path}")
print(f"Шагов до достижения цели: {steps}")
print(f"Цель достигнута: {env.current_pos == env.goal_pos}")
Объяснение кода:
Q_table— это основная функция ценности действия, имеющая форму[number of states, number of actions](в примере 25×4, что соответствует 25 состояниям сетки 5×5 и 4 действиям вверх/вниз/влево/вправо).Q_table[s, a]Обозначает для состоянияs(индекс позиции на сетке), долгосрочную ценность выполнения действияa(0-3 соответствуют вверх/вниз/влево/вправо), изначально все равны 0, обновляются шаг за шагом в процессе обучения.env.step(action)Моделирует основную логику взаимодействия марковского процесса принятия решений (MDP): после ввода индекса действия он сначала обновляет позицию агента на сетке (если он попадает в препятствие, позиция остаётся неизменной), затем возвращает кортеж из трёх элементов:(next_state, reward, done)——next_state— индекс нового состояния,reward— это дифференцированная награда (цель +100, препятствие -50, каждый шаг -1),doneуказывает, достигнута ли цель (конец этого эпизода).- Основная формула обновления Q-обучения
Q(S,A) = Q(S,A) + α * [R + γ * max(Q(S', a')) - Q(S,A)]разбирается и реализуется в коде: сначала получить текущее значение Qold_value, затем вычислить максимальное значение Q следующего состоянияnext_max, затем вычислить целевое значениеtarget = 奖励 + 折扣因子 × 下一状态最大Q值, и наконец использовать скорость обученияαчтобы смешать старое значение и целевое значение, получив обновлённое значение Q, тем самым итеративно корректируя значение действия. epsilon(коэффициент исследования) балансирует «использование» и «исследование» с помощью ε-жадной стратегии: сepsilonвероятностью случайно выбрать действие (исследовать неизвестное); с1-epsilonвероятностью выбрать действие с наибольшим значением Q в текущем состоянии (использовать известный оптимум). Код также обрабатывает случай совпадения Q-значений: если несколько действий имеют одинаковое значение Q, одно выбирается случайным образом, что позволяет избежать фиксации политики, вызванной единственным фиксированным выбором.- Код дополнительно реализует двунаправленное сопоставление между состояниями и позициями на сетке (
pos_to_state/state_to_pos), преобразование между действиями и названиями направлений (action_to_direction), а также извлечение и тестирование политики после обучения: пройти по всем состояниям, выбрать действие с наибольшим значением Q в каждом состоянии в качестве оптимальной политики и проверить путь и количество шагов из начальной точки в целевую точку при этой политике.
Episode 100/1000, Total Reward: 93.0
Episode 200/1000, Total Reward: 90.0
Episode 300/1000, Total Reward: 92.0
Episode 400/1000, Total Reward: 90.0
Episode 500/1000, Total Reward: 93.0
Episode 600/1000, Total Reward: 93.0
Episode 700/1000, Total Reward: 91.0
Episode 800/1000, Total Reward: 93.0
Episode 900/1000, Total Reward: 93.0
Episode 1000/1000, Total Reward: 93.0

=== 学习完成后的最优策略 ===
位置 (0, 0): 最优动作 = right
位置 (0, 1): 最优动作 = right
位置 (0, 2): 最优动作 = down
位置 (0, 3): 最优动作 = down
位置 (0, 4): 最优动作 = down
位置 (1, 0): 最优动作 = up
位置 (1, 1): 最优动作 = 障碍物
位置 (1, 2): 最优动作 = right
位置 (1, 3): 最优动作 = down
位置 (1, 4): 最优动作 = left
位置 (2, 0): 最优动作 = down
位置 (2, 1): 最优动作 = down
位置 (2, 2): 最优动作 = 障碍物
位置 (2, 3): 最优动作 = down
位置 (2, 4): 最优动作 = down
位置 (3, 0): 最优动作 = down
位置 (3, 1): 最优动作 = 障碍物
位置 (3, 2): 最优动作 = right
位置 (3, 3): 最优动作 = right
位置 (3, 4): 最优动作 = down
位置 (4, 0): 最优动作 = right
位置 (4, 1): 最优动作 = right
位置 (4, 2): 最优动作 = right
位置 (4, 3): 最优动作 = right
位置 (4, 4): 最优动作 = 终点

=== 测试最优策略 ===
路径: [(0, 0), (0, 1), (0, 2), (1, 2), (1, 3), (2, 3), (3, 3), (3, 4), (4, 4)]
到达终点步数: 8
是否到达终点: True
Итоги и практические размышления
Базовую схему обучения с подкреплением можно обобщить так:Агент взаимодействует со средой в форме марковского процесса принятия решений и на основе получаемых сигналов награды непрерывно оптимизирует свою политику (обычно путём обучения и обновления функций ценности), с конечной целью максимизации долгосрочной суммарной награды.
| Концепция | Аналогия | Роль в обучении с подкреплением |
|---|---|---|
| Агент | Обучающийся щенок / ИИ, играющий в шахматы | Субъект принятия решений, который исполняет алгоритм обучения |
| Окружение | Тренер / Правила шахматной доски | Внешняя система, предоставляющая состояния и сигналы награды |
| State | Поза щенка / Позиция на шахматной доске | Текущая информация, на основе которой агент принимает решения |
| Действие | Сесть / Сделать ход фигурой | Варианты, которые может выбрать агент |
| Награда | Лакомство / Результат победы или поражения | Немедленный сигнал, оценивающий качество действия; компас обучения |
| Политика | Ответ на команду, которому научился щенок | Правило отображения состояний в действия; цель обучения |
| Функция ценности | Долгосрочная оценка ситуации | Оценивает долгосрочную ценность состояния или действия; это основа для оптимизации политики |