Регуляризация
Представьте, что мы учимся ездить на велосипеде. Вначале мы можем сильно нервничать, крепко сжимать руль, тело зажато, пытаемся запомнить каждую деталь движения. Такое состояние чрезмерной сосредоточенности на деталях и попытки идеально контролировать каждое мельчайшее движение в машинном обучении называетсяпереобучение。
Наша модель (как вы в роли новичка) слишком сложна: она идеально запоминает каждый пример в обучающих данных, включая шум и случайные колебания, из-за чего плохо работает при столкновении с новыми, невиданными данными (например, при реальной езде по дороге), и не обладает способностью к обобщению.
Регуляризация— это основная технология, предназначенная для решения этой проблемы. Её основная идея:остудить энтузиазм модели к обучению, не дать ей зацикливаться на деталях и тем самым повысить её адаптируемость к новым условиям.Проще говоря, регуляризация добавляет дополнительный штрафной член в целевую функцию (функцию потерь) во время обучения модели, тем самым ограничивая сложность модели и не позволяя ей чрезмерно полагаться на конкретные закономерности в обучающих данных.
В этой статье мы подробно разберём принципы регуляризации, распространённые методы и их применение в инженерной практике.
Базовые понятия: компромисс между смещением и дисперсией
Прежде чем погружаться в регуляризацию, нам нужно понять два основных источника ошибки в моделях машинного обучения:смещениеидисперсия. Это помогает понять, что именно регулирует регуляризация.
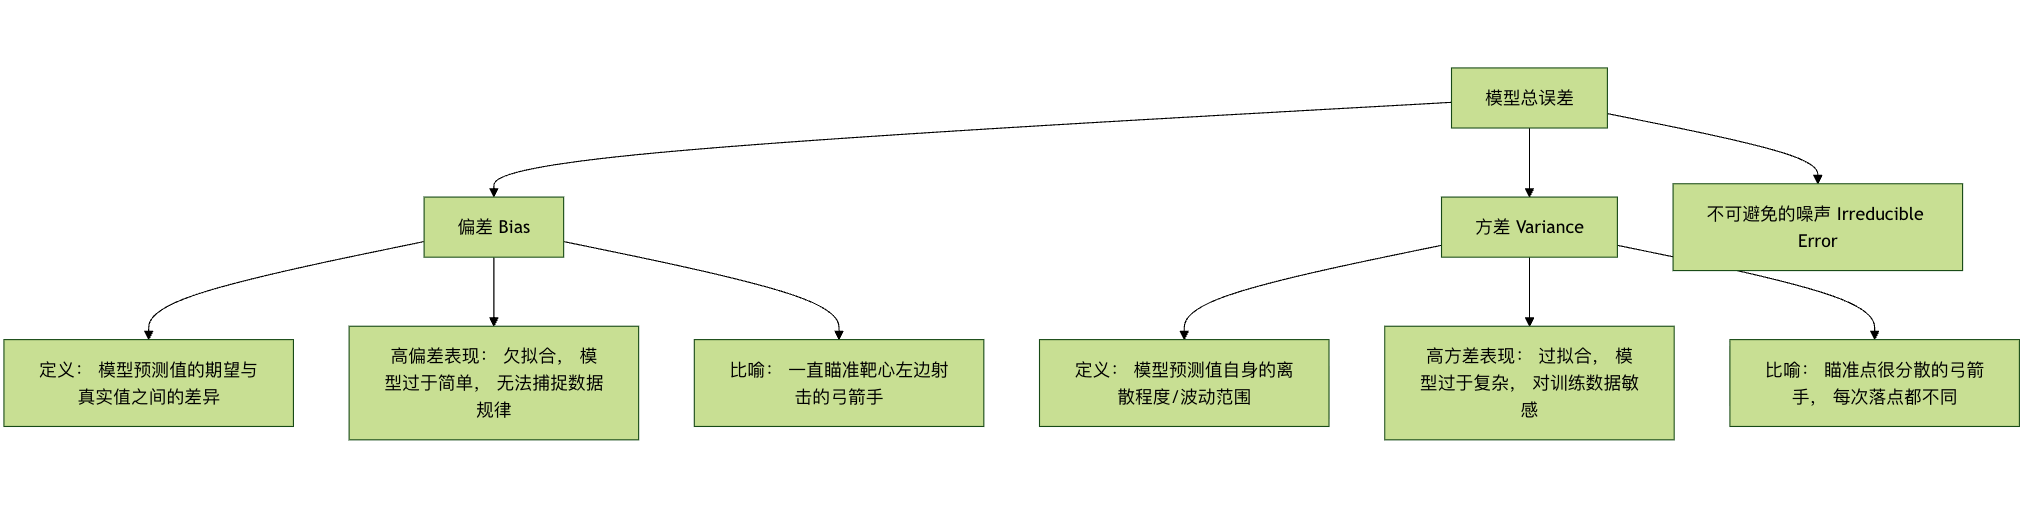
- Смещениеизмеряет собственнуюсистематическую ошибку модели.Высокое смещение означает, что модель слишком проста и не способна выучить даже базовые закономерности в обучающих данных (недообучение).
- Дисперсияизмеряет чувствительность модели кслучайным колебаниям в обучающих данных.Высокая дисперсия означает, что модель слишком сложна и принимает шум в обучающих данных за закономерности, которые нужно выучить (переобучение).
Наша цель — найтикомпромисс между смещением и дисперсиейоптимальную точку, минимизирующую суммарную ошибку. Регуляризация — это метод, который за счётдобавления небольшого смещения (делая модель немного проще) значительно снижает дисперсию, и тем самым эффективно улучшает общую способность модели к обобщению.
L1- и L2-регуляризация
Самый классический метод регуляризации — напрямую добавить в функцию потерь штрафной член, основанный на весовых параметрах модели. В зависимости от способа вычисления штрафного члена он в основном делится на L1- и L2-регуляризацию.
Изменения в функции потерь
Функция потерь без регуляризации (на примере среднеквадратичной ошибки, MSE):Loss = (1/n) * Σ(真实值 - 预测值)²
Функция потерь после добавления регуляризационного члена:Loss_正则化 = Loss + λ * Penalty(权重)
где:
λ(лямбда) — этокоэффициент силы регуляризации,гиперпараметр, значение которого больше 0. Он управляет силой штрафа.λЧем больше λ, тем сильнее штраф за сложность модели, и тем проще становится модель.Penalty(权重)— это штрафной член. L1 и L2 имеют разные определения.
L1-регуляризация (лассо-регрессия)
- Штрафной член: сумма абсолютных значений всех весовых параметров модели.
- Формула:
Penalty = Σ|w_i|, гдеw_i— это i-й вес. - Функция потерь:
Loss_L1 = Loss + λ * Σ|w_i|
Ключевые особенности:
- Отбор признаков: L1-регуляризация склонна создаватьразреженную матрицу весов,, то есть она напрямую сжимает веса многих признаков до00. Это эквивалентно автоматическому выполнению отбора признаков, при котором модель сохраняет только самые важные признаки.
- Геометрическая интерпретация: Геометрически её область ограничения представляет собой «ромб» (в двумерном случае — ромб). Точка оптимального решения с большей вероятностью касается «угла» этого ромба, а точки в углах означают, что некоторые координаты равны 0.
Пример кода:
Пример
from sklearn.datasets import make_regression
from sklearn.model_selection import train_test_split
# Сгенерировать смоделированные данные
X, y = make_regression(n_samples=100, n_features=10, noise=0.1, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Создать модель L1-регуляризации (Lasso), задать силу регуляризации alpha (то есть λ)
lasso_model = Lasso(alpha=0.1) # Чем больше alpha, тем сильнее штраф, и больше весов становятся равными 0
lasso_model.fit(X_train, y_train)
# Посмотреть коэффициенты модели (веса), чтобы наблюдать разреженность
print(Коэффициенты модели Lasso:)
for i, coef in enumerate(lasso_model.coef_):
print(f" Признак {i}: {coef:.4f}")
# Подсчитать количество ненулевых весов
non_zero_count = sum(lasso_model.coef_ != 0)
print(f"\nКоличество признаков с ненулевыми весами: {non_zero_count} / {X.shape)
Вывод:
Lasso 模型系数:
  特征 0: 16.6855
  特征 1: 54.0447
  特征 2: 5.0302
  特征 3: 63.5492
  特征 4: 93.4587
  特征 5: 70.5421
  特征 6: 86.9569
  特征 7: 10.2711
  特征 8: 3.0697
  特征 9: 70.7835

非零权重的特征数量: 10 / 10
L2-регуляризация (гребневая регрессия)
- Штрафной член: сумма квадратов всех весовых параметров в модели.
- Формула:
Penalty = Σ(w_i)² - Функция потерь:
Loss_L2 = Loss + λ * Σ(w_i)²
Ключевые особенности:
- Затухание весов: L2-регуляризация стремится заставить все весовые параметрыприближаться к 0, но обычно они не равны 0.Она равномерно сжимает все веса, не позволяя ни одному отдельному весу стать слишком большим.
- Улучшение плохо обусловленных задач: Для данных с мультиколлинеарностью (высокой корреляцией) между признаками обычная линейная регрессия может быть неустойчивой. L2-регуляризация может эффективно улучшить эту проблему и сделать решение более стабильным.
- Геометрическая интерпретация: Геометрически её область ограничения — это 'круг' (окружность в двумерном пространстве). Оптимальная точка решения скорее коснётся 'края' этого круга, чем острого угла.
Пример кода:
Пример
# Создать модель L2-регуляризации (Ridge)
ridge_model = Ridge(alpha=1.0) # alpha — это λ
ridge_model.fit(X_train, y_train)
# Просмотр коэффициентов модели для наблюдения за затуханием весов
print("Коэффициенты модели Ridge:")
for i, coef in enumerate(ridge_model.coef_):
print(f" Признак {i}: {coef:.4f}")
# Сравнение различий коэффициентов между Lasso и Ridge
print("\nСравнение коэффициентов (Lasso против Ridge):")
print("Признак | Коэффициент Lasso | Коэффициент Ridge")
print("-" * 35)
for i in range(len(lasso_model.coef_)):
print(f"{i:4d} | {lasso_model.coef_[i]:11.4f} | {ridge_model.coef_[i]:11.4f}")
Сводка сравнения L1 и L2
| Свойство | L1-регуляризация (Lasso) | L2-регуляризация (Ridge) |
|---|---|---|
| Штрафной член | `Σ | w_i |
| Характеристики решения | Разреженное решение, многие веса равны 0 | Плотное решение, веса близки к 0, но не равны нулю |
| Основная функция | Отбор признаков | Затухание весов, Устойчивое решение |
| Геометрическая форма | Ромб / многогранник | Круг / сфера |
| Вычисления | Более сложная оптимизация (не всюду дифференцируема) | Простая оптимизация (дифференцируема всюду) |
| Применимые сценарии | Много признаков, и только немногие считаются релевантными | Все признаки могут вносить вклад, или существует мультиколлинеарность |
Elastic Net
Elastic Net — это компромисс между регуляризацией L1 и L2, содержащий штрафные члены обеих.Loss_ElasticNet = Loss + λ1 * Σ|w_i| + λ2 * Σ(w_i)²
Он сочетает способность L1 к отбору признаков со стабильностью L2, что делает его подходящим для случаев с очень высокой размерностью признаков и корреляциями между признаками.
Пример
elastic_model = ElasticNet(alpha=0.1, l1_ratio=0.5) # l1_ratio управляет пропорцией смешивания L1 и L2
elastic_model.fit(X_train, y_train)
Другие методы регуляризации
Помимо прямого изменения функции потерь, существуют также методы, которые достигают регуляризации путём изменения процесса обучения или структуры модели.
Dropout (для нейронных сетей)
Dropout — чрезвычайно эффективная техника регуляризации в нейронных сетях. Во времяпроцесса обученияон случайным образом заставляет часть нейронов в сети временно «отключаться» (устанавливать их выход в 0).
Как это работает:
- В каждом обучающем батче, с вероятностью
p(например, 0.5), случайно отключает часть нейронов. - Прямое распространение и обратное распространение выполняются только в оставшихся нейронах.
- Во время тестирования или предсказания используются все нейроны, но выход нейрона умножается на
(1-p)чтобы ожидаемое значение оставалось согласованным.
Основная идея: предотвратить сложную совместную адаптацию между нейронами, заставляя сеть изучать болееустойчивыеираспределённыепредставления признаков. Это похоже на команду: она не может всегда полагаться на нескольких ключевых членов; каждый должен уметь работать самостоятельно, чтобы даже если кого-то нет, команда всё ещё могла нормально функционировать.
Пример кода (с использованием TensorFlow/Keras):
Пример
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Dropout
model = Sequential([
Dense(128, activation='relu', input_shape=(input_dim,)),
Dropout(0.5), # Добавить слой Dropout после предыдущего слоя, коэффициент dropout 50%
Dense(64, activation='relu'),
Dropout(0.3), # коэффициент dropout 30%
Dense(1, activation='sigmoid') # выходной слой
])
model.compile(optimizer='adam', loss='binary_crossentropy', metrics=['accuracy'])
Ранняя остановка
Ранняя остановка — простая и эффективная стратегия регуляризации. Она не изменяет функцию потерь, а вместо этогоотслеживает производительность модели на валидационном наборе.。
Шаги:
- Разделите данные на обучающий и валидационный наборы.
- Обучите модель на обучающем наборе и периодически оценивайте производительность на валидационном наборе (например, после каждой эпохи обучения).
- Как только будет обнаружено, что производительность (например, потери) на валидационном наборе не улучшается в течение нескольких последовательных эпохили даже начала снижаться,немедленно остановите обучение.
Основная идея:Остановите обучение в момент непосредственно перед тем, как модель начнёт переобучаться на обучающих данных (т.е. когда ошибка на валидации начнёт расти), тем самым получив веса модели с наилучшей способностью к обобщению.
Пример
# Определите функцию обратного вызова ранней остановки
# monitor: метрика для отслеживания, например, 'val_loss'
# patience: количество эпох ожидания; остановите обучение, если производительность на валидации не улучшается в течение этого количества эпох
# restore_best_weights: восстанавливать ли веса из эпохи с лучшим значением отслеживаемой метрики
early_stopping = EarlyStopping(
monitor='val_loss',
patience=10,
restore_best_weights=True
)
# Использование в model.fit
history = model.fit(
X_train, y_train,
validation_data=(X_val, y_val),
epochs=100,
callbacks=[early_stopping] # Передайте список обратных вызовов
)
Практическое упражнение: комплексное сравнение эффектов регуляризации
Давайте используем полный пример, чтобы сравнить влияние различных методов регуляризации на задачу регрессии.
Пример
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression, Lasso, Ridge, ElasticNet
from sklearn.preprocessing import PolynomialFeatures
from sklearn.pipeline import make_pipeline
from sklearn.metrics import mean_squared_error
# 1. Сгенерировать нелинейные данные с шумом
np.random.seed(42)
X = np.linspace(-3, 3, 100).reshape(-1, 1)
y_true = 0.5 * X.ravel()**2 + X.ravel() # Истинная квадратичная зависимость
y = y_true + np.random.randn(100) * 0.8 # Добавить шум
# 2. Создать модели разной сложности (с использованием полиномиальных признаков)
degree = 10 # Использовать полином 10-й степени, который склонен к переобучению
models = {
'Без регуляризации': make_pipeline(PolynomialFeatures(degree), LinearRegression()),
'L1 (Lasso)': make_pipeline(PolynomialFeatures(degree), Lasso(alpha=0.01, max_iter=10000)),
'L2 (Ridge)': make_pipeline(PolynomialFeatures(degree), Ridge(alpha=0.1)),
'ElasticNet': make_pipeline(PolynomialFeatures(degree), ElasticNet(alpha=0.01, l1_ratio=0.5))
}
# 3. Обучение и предсказание
X_plot = np.linspace(-3.5, 3.5, 200).reshape(-1, 1)
plt.figure(figsize=(12, 8))
plt.scatter(X, y, s=20, alpha=0.6, label='Обучающие данные (с шумом)')
plt.plot(X, y_true, 'k-', linewidth=3, label='Истинная функция')
for name, model in models.items():
model.fit(X, y)
y_plot = model.predict(X_plot)
mse = mean_squared_error(y, model.predict(X))
plt.plot(X_plot, y_plot, '--', linewidth=2, label=f'{name} (MSE: {mse:.3f})')
plt.xlabel('X')
plt.ylabel('y')
plt.title('Сравнение различных методов регуляризации в подавлении переобучения (полином 10-й степени)')
plt.legend(loc='best')
plt.grid(True, alpha=0.3)
plt.show()
Практические задания:
- Запустите приведённый выше код и посмотрите, как нерегуляризованная модель сильно колеблется, подстраиваясь под шум (переобучение), тогда как кривые регуляризованных моделей более гладкие и ближе к истинной функции.
- Попробуйте изменить
degree(степень полинома) иalphaпараметры (силы регуляризации) каждой модели, и понаблюдайте за их влиянием на результаты подгонки модели. - (Дополнительно) Разделите данные на обучающую и тестовую выборки, вычислите MSE каждой модели на тестовой выборке и проверьте улучшение обобщения за счёт регуляризации.
Итоги и инженерные рекомендации
Регуляризация — важный инструмент в арсенале инженера машинного обучения. Чтобы применять её эффективно, помните о следующих моментах:
- Понимайте природу проблемы:Сначала используйте кривые обучения, качество на валидационной выборке и т. д., чтобы определить, сталкивается ли модель с проблемой переобучения (высокой дисперсии).
- Начните с простого:Обычно можно сначала попробоватьL2-регуляризацию,потому что она стабильна и легко настраивается. Если размерность признаков чрезвычайно высока и требуется отбор признаков, то рассмотритеL1илиэластичную сеть.。
- Настройка — ключ к успеху:Сила регуляризации
λ(илиalpha) — это критически важный гиперпараметр. Его необходимокросс-валидациейтщательно подбирать. - Используйте в комбинации:На практике методы регуляризации часто используются в сочетании. Например, при обучении глубоких нейронных сетейDropout + L2 weight decay + early stopping— это чрезвычайно распространённая комбинация.
- Адаптация к предметной области:Для задач компьютерного зрения Dropout и Batch Normalization (которая также оказывает определённый регуляризующий эффект) очень эффективны. Для последовательностных моделей (таких как RNN, Transformer) обычно используются Dropout и weight decay.
Конечная цель регуляризации — направить модель от «зубрёжки» тренировочных данных к «глубокому пониманию» универсальных закономерностей, лежащих в основе данных, чтобы делать более надёжные прогнозы в реальном мире. Освойте её, и вы держите ключ к улучшению обобщающей способности модели.
Другие расширения