Основная терминология машинного обучения
Изучать машинное обучение — всё равно что учить новый язык; сначала нужно освоить базовый словарный запас. Эти термины образуют «языковую систему» машинного обучения, и их понимание — первый шаг к более глубокому изучению.
Представьте, что вы учите робота распознавать фрукты:
- Данные: изображения и информация о различных фруктах
- Признак: цвет, форма, размер и вкус фрукта
- Метка: Название этого фрукта (яблоко, банан, апельсин)
- Модель: «метод распознавания фруктов», изученный роботом
- Обучение: Процесс обучения робота распознаванию фруктов
- Инференс: Способность робота распознавать новые фрукты
Данные
Что такое данные?
Данные— это «сырьё» машинного обучения, как ингредиенты, необходимые повару для приготовления блюда. Без данных машинное обучение невозможно.
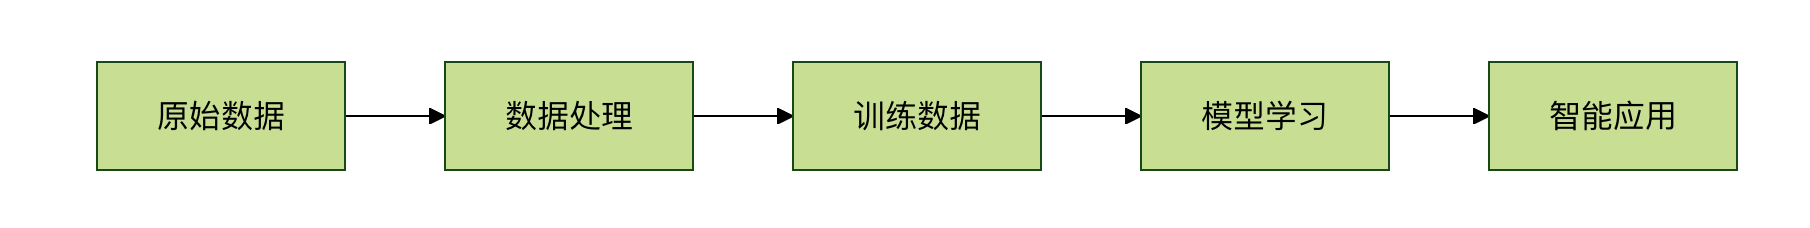
Типы данных
1. Структурированные данные
Характеристики: Имеют чёткий формат и организацию, аккуратны, как таблица
# Пример структурированных данных: таблица с информацией о студентахПример
students_data = {
'Имя': ['Чжан Сань', 'Ли Сы', 'Ван У'],
'Age': [18, 19, 20],
'Score': [85, 92, 78],
'Class': ['Class 1', 'Class 2', 'Class 1']
}
df = pd.DataFrame(students_data)
print(df)
Вывод:
   姓名  年龄  成绩  班级
0  张三  18  85  一班
1  李四  19  92  二班
2  王五  20  78  一班
2. Неструктурированные данные
Характеристики: Не имеет фиксированного формата и требует специальной обработки
Примеры:
- Текст: комментарии, статьи, электронные письма
- Изображения: фотографии, медицинские изображения
- Аудио: речь, музыка
- Видео: записи видеонаблюдения, фильмы
# 非结构化数据示例:文本和图像
text_data = "这个产品质量很好,我很满意!"
# image_data = 一张产品的照片
# audio_data = 顾客的语音评价
Важность качества данных
Мусор на входе — мусор на выходе(Garbage In, Garbage Out) — важный принцип машинного обучения. Качество данных напрямую определяет производительность модели.
Пример
import numpy as np
import pandas as pd
# Создание данных с различными проблемами
problematic_data = {
'Price': [100, 200, None, 300, -50], # Пропущенные значения и выбросы
'Rating': [4.5, 'Good', 3.8, 4.2, 5.0], # Несогласованные типы данных
'Sales': [1000, 1200, 800, 1500, 'Many'] # Смесь текста и чисел
}
df = pd.DataFrame(problematic_data)
print("Проблемные данные:")
print(df)
print("\nАнализ проблем с данными: ")
print(f"Количество пропущенных значений: {df.isnull().sum().sum()}")
print(f"Типы данных:\n{df.dtypes}")
Характеристика
Что такое признак?
Признак— это "наблюдаемый атрибут" данных, так же как описание характеристик человека: рост, вес, цвет волос, характер и т. д. В машинном обучении признаки — основа для построения прогнозов.
Важность отбора признаков:
- Хорошие признаки могут сделать модель вдвое эффективнее при вдвое меньших усилиях
- Плохие признаки могут сделать модель вдвое менее эффективной при вдвое больших усилиях
- Инженерия признаков часто является ключом к определению качества модели
Типы признаков
1. Числовые признаки
Характеристики: могут быть представлены числами и допускают математические операции
# 数值特征示例
numerical_features = {
    '年龄': [25, 30, 35, 40],
    '收入': [5000, 8000, 12000, 15000],
    '身高': [165, 170, 175, 180]
}
2. Категориальные признаки
Характеристики: представляют разные категории и не допускают математических операций
# 类别特征示例
categorical_features = {
    '性别': ['男', '女', '男', '女'],
    '学历': ['本科', '硕士', '博士', '本科'],
    '城市': ['北京', '上海', '广州', '深圳']
}
3. Текстовые признаки
Характеристики: требуют специальной обработки, прежде чем их можно будет использовать в модели
# 文本特征示例
text_features = {
    '评论': [
        '这个产品很好用,推荐购买!',
        '质量一般,不太满意。',
        '性价比高,值得入手。'
    ]
}
Пример конструирования признаков
Пример
import pandas as pd
import numpy as np
# Сырые данные: информация о домах
house_data = {
'Area': [80, 120, 60, 150, 90],
'Number of Bedrooms': [2, 3, 1, 4, 2],
'Year Built': [2000, 2010, 1995, 2015, 2005],
'Price': [200, 350, 150, 500, 280]
}
df = pd.DataFrame(house_data)
# Создать новые признаки
df['House Age'] = 2023 - df['Year Built'] # Возраст дома
df['Price per Square Meter'] = df['Price'] / df['Area'] # Цена за единицу
df['Bedroom Area Ratio'] = df['Number of Bedrooms'] / df['Area'] * 100 # Доля спален
print("Исходные данные + новые признаки:")
print(df)
# Анализ важности признаков
correlation = df.corr()['Price'].sort_values(ascending=False)
print("\nКорреляция между признаками и ценой: ")
print(correlation)
Label
Что такое метка?
Метка— это "ответ", который мы хотим предсказать, так же как правильный ответ на экзаменационный вопрос. В обучении с учителем каждый образец данных имеет соответствующую метку.
Роль меток:
- Направляют обучение модели
- Оценивают эффективность обучения модели
- Определяют тип задачи
Типы меток
1. Метки классификации
Характеристики: Дискретные категориальные значения
# 分类标签示例
classification_labels = {
    '邮件类型': ['垃圾邮件', '正常邮件', '垃圾邮件', '正常邮件'],
    '情感倾向': ['正面', '负面', '中性', '正面'],
    '疾病诊断': ['患病', '健康', '健康', '患病']
}
2. Метки регрессии
Характеристики: Непрерывные числовые значения
# 回归标签示例
regression_labels = {
    '房价': [250000, 320000, 180000, 450000],
    '温度': [25.5, 28.3, 22.1, 30.0],
    '股票价格': [100.5, 105.2, 98.7, 110.3]
}
Важность качества меток
# 标签质量问题示例
import numpy as np
# 模拟图像分类任务中的标签问题
image_data = ['cat1.jpg', 'dog1.jpg', 'cat2.jpg', 'dog2.jpg']
problematic_labels = ['猫', '犬', '猫咪', '狗']  # 标签不一致
# 标签标准化
label_mapping = {
    '猫': 'cat', '猫咪': 'cat',
    '犬': 'dog', '狗': 'dog'
}
standardized_labels = [label_mapping[label] for label in problematic_labels]
print("原始标签:", problematic_labels)
print("标准化标签:", standardized_labels)
Модель
Что такое модель?
Модель— это «шаблон» или «правило», которое алгоритм машинного обучения изучает из данных, так же как знания, которые студенты получают из учебников.
Сущность модели:
- Математическая функция: входные признаки, выходные предсказания
- Набор параметров: конкретное представление выученных правил
- Решающие правила: как получить выход из входа
Представление модели
Пример
import numpy as np
import matplotlib.pyplot as plt
# Смоделированные данные
X = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 6, 8, 10])
# Линейная модель: y = w * x + b
# Выученные параметры: w = 2, b = 0
w, b = 2, 0
def linear_model(x):
"""Функция линейной модели"""
return w * x + b
# Предсказание
predictions = linear_model(X)
# Визуализация
plt.scatter(X, y, color='blue', label='Истинные данные')
plt.plot(X, predictions, color='red', label='Предсказания модели')
plt.xlabel('Вход X')
plt.ylabel('Выход y')
plt.title('Пример линейной модели')
plt.legend()
plt.grid(True)
plt.show()
print(f"Параметры модели: w = {w}, b = {b}")
print(f"Результаты предсказания: {predictions}")
Сложность модели
Пример
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
import numpy as np
# Генерация нелинейных данных
np.random.seed(42)
X = np.random.rand(20, 1) * 10
y = np.sin(X) + np.random.randn(20, 1) * 0.1
# Простая модель (линейная)
simple_model = LinearRegression()
simple_model.fit(X, y)
# Сложная модель (полином высокой степени)
poly_features = PolynomialFeatures(degree=10)
X_poly = poly_features.fit_transform(X)
complex_model = LinearRegression()
complex_model.fit(X_poly, y)
# Визуализация
X_test = np.linspace(0, 10, 100).reshape(-1, 1)
X_test_poly = poly_features.transform(X_test)
plt.scatter(X, y, color='blue', label='Обучающие данные')
plt.plot(X_test, simple_model.predict(X_test), color='green', label='Простая модель')
plt.plot(X_test, complex_model.predict(X_test_poly), color='red', label='Сложная модель')
plt.xlabel('X')
plt.ylabel('y')
plt.title('Сравнение сложности моделей')
plt.legend()
plt.grid(True)
plt.show()
Обучение
Что такое обучение?
Обучение— это процесс, с помощью которого модель учится, подобно тому как студенты усваивают знания на занятии. Во время обучения модель постоянно настраивает свои параметры, чтобы предсказания становились всё ближе и ближе к истинным меткам.
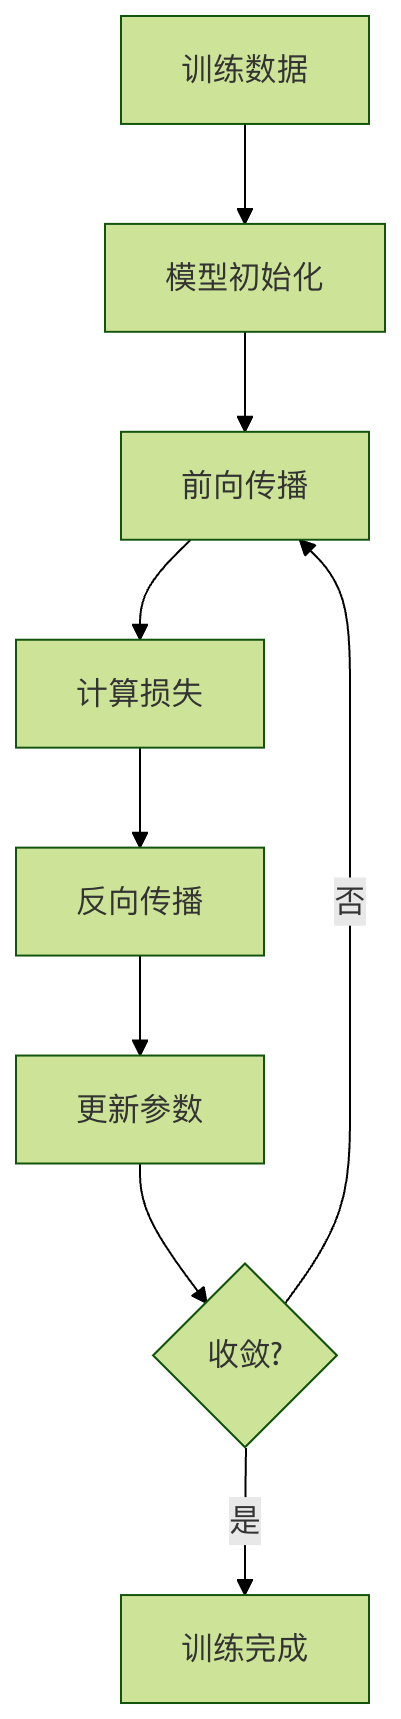
Пример процесса обучения
Пример
import numpy as np
import matplotlib.pyplot as plt
# Сгенерировать обучающие данные
np.random.seed(42)
X = np.random.rand(50, 1) * 10
y = 3 * X + 2 + np.random.randn(50, 1) * 2
# Инициализация параметров модели
w, b = 0.0, 0.0
learning_rate = 0.01
epochs = 100
# Запись процесса обучения
loss_history = []
# Цикл обучения
for epoch in range(epochs):
# Прямое распространение
y_pred = w * X + b
# Вычислить потерю (среднеквадратичная ошибка)
loss = np.mean((y_pred - y) ** 2)
loss_history.append(loss)
# Вычислить градиенты
dw = np.mean(2 * X * (y_pred - y))
db = np.mean(2 * (y_pred - y))
# Обновить параметры
w -= learning_rate * dw
b -= learning_rate * db
if epoch % 10 == 0:
print(f"Эпоха {epoch}: Потери = {loss:.4f}, w = {w:.4f}, b = {b:.4f}")
# Визуализация процесса обучения
plt.figure(figsize=(12, 4))
plt.subplot(1, 2, 1)
plt.plot(loss_history)
plt.xlabel('Эпоха')
plt.ylabel('Потери')
plt.title('Изменение потерь при обучении')
plt.grid(True)
plt.subplot(1, 2, 2)
plt.scatter(X, y, color='blue', label='Обучающие данные')
plt.plot(X, w * X + b, color='red', label='Обученная модель')
plt.xlabel('X')
plt.ylabel('y')
plt.title('Результаты обучения')
plt.legend()
plt.grid(True)
plt.tight_layout()
plt.show()
print(f"Итоговые параметры модели: w = {w:.4f}, b = {b:.4f}")
Инференс
Что такое инференс?
ИнференсИнференс — это процесс использования обученной модели для получения прогнозов, так же как студенты используют полученные знания, чтобы отвечать на экзаменационные вопросы.
Пример процесса инференса
Пример
import numpy as np
# Предположим, мы уже обучили модель прогнозирования цен на дома
class HousePriceModel:
def __init__(self):
# Имитация обученных параметров
self.feature_weights = {
'Area': 2.5,
'Bedrooms': 10.0,
'House age': -1.0,
'Location score': 50.0
}
self.bias = 50.0
def predict(self, features):
"""
Используйте обученную модель для прогнозирования цены дома
"""
price = self.bias
for feature_name, feature_value in features.items():
if feature_name in self.feature_weights:
price += self.feature_weights[feature_name] * feature_value
return price
# Создайте обученную модель
model = HousePriceModel()
# Инференс: прогнозирование цены нового дома
new_houses = [
{'Area': 80, 'Bedrooms': 2, 'House age': 5, 'Location score': 8},
{'Area': 120, 'Bedrooms': 3, 'House age': 2, 'Location score': 9},
{'Area': 60, 'Bedrooms': 1, 'House age': 10, 'Location score': 6}
]
print(Результаты прогнозирования цены дома:)
for i, house in enumerate(new_houses, 1):
predicted_price = model.predict(house)
print(f"Дом {i}: предсказанная цена {predicted_price:.2f} ten thousand yuan")
# Пакетный инференс
def batch_predict(model, house_list):
"""Пакетное предсказание"""
return [model.predict(house) for house in house_list]
batch_prices = batch_predict(model, new_houses)
print(f"\nРезультаты пакетного предсказания: {batch_prices}")
Полный пример: от данных к инференсу
Пример
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, r2_score
# 1. Подготовка данных
np.random.seed(42)
n_samples = 200
# Генерация данных признаков
area = np.random.normal(100, 30, n_samples) # Площадь
bedrooms = np.random.randint(1, 5, n_samples) # Спальни
age = np.random.randint(0, 20, n_samples) # Возраст дома
location_score = np.random.randint(1, 10, n_samples) # Оценка местоположения
# Генерация меток (цены домов) - линейная комбинация признаков плюс шум
price = (area * 2.5 + bedrooms * 20 + age * -2 + location_score * 15 +
np.random.normal(0, 50, n_samples))
# Создать DataFrame
data = pd.DataFrame({
'Area': area,
'Bedrooms': bedrooms,
'House age': age,
'Location score': location_score,
'Price': price
})
print(Пример данных:)
print(data.head())
# 2. Разделить на обучающую и тестовую выборки
features = ['Area', 'Bedrooms', 'House age', 'Location score']
X = data[features]
y = data['Price']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
print(f"\nРазмер обучающей выборки: {X_train.shape)
print(f"Размер тестовой выборки: {X_test.shape)
# 3. Обучение модели
model = LinearRegression()
model.fit(X_train, y_train)
print(f"\nПараметры модели:")
for feature, coef in zip(features, model.coef_):
print(f"{feature}: {coef:.2f}")
print(f"Свободный член: {model.intercept_:.2f}")
# 4. Оценка модели
y_train_pred = model.predict(X_train)
y_test_pred = model.predict(X_test)
train_mse = mean_squared_error(y_train, y_train_pred)
test_mse = mean_squared_error(y_test, y_test_pred)
train_r2 = r2_score(y_train, y_train_pred)
test_r2 = r2_score(y_test, y_test_pred)
print(f"\nОценка модели:")
print(f"MSE на обучающей выборке: {train_mse:.2f}, R²: {train_r2:.2f}")
print(f"MSE на тестовой выборке: {test_mse:.2f}, R²: {test_r2:.2f}")
# 5. Инференс (прогнозирование новых данных)
new_houses = pd.DataFrame({
'Area': [85, 120, 65],
'Bedrooms': [2, 3, 1],
'House age': [3, 1, 8],
'Location score': [7, 9, 5]
})
predictions = model.predict(new_houses)
print(f"\nПрогноз цены нового дома:")
for i, price in enumerate(predictions, 1):
print(f"Дом {i}: {price:.2f} десять тысяч юаней")
Распространённые типы сетей машинного обучения
| Тип модели | Полное название на китайском | Английская аббревиатура | Основные сценарии применения | Преимущества | Недостатки |
|---|---|---|---|---|---|
| Традиционное машинное обучение | Дерево решений | DT | Классификация, регрессия, анализ важности признаков | Высокая интерпретируемость, не требуется нормализация данных | Склонность к переобучению, чувствительность к шуму |
| Случайный лес | RF | Классификация, регрессия, обнаружение аномалий | Устойчивость к переобучению, высокая стабильность | Высокие вычислительные затраты при многомерных данных | |
| Логистическая регрессия | LR | Бинарная классификация, предсказание вероятности | Быстрое обучение, высокая интерпретируемость | Сложность подгонки нелинейных зависимостей | |
| Метод опорных векторов | SVM | Классификация, высокоразмерные данные с малой выборкой | Сильная способность к обобщению, подходит для сценариев с высокой размерностью признаков | Медленное обучение на крупномасштабных данных, сложная настройка параметров | |
| Наивный Байес | NB | Классификация текста, обнаружение спама | Чрезвычайно быстрое обучение, нечувствительность к пропущенным данным | Предполагает независимость признаков, что может не выполняться в реальных сценариях | |
| XGBoost | XGBoost | Классификация, регрессия, задачи соревновательного уровня | Высокая точность, поддерживает параллельные вычисления, встроенная регуляризация | Склонность к переобучению, чувствительность к гиперпараметрам | |
| LightGBM | LightGBM | Классификация и регрессия на крупномасштабных данных | Высокая скорость обучения, низкое потребление памяти | Может быть менее стабильным, чем XGBoost, на небольших наборах данных | |
| Глубокое обучение | Искусственная нейронная сеть | ANN | Простые задачи классификации и регрессии | Простая структура, легко понять | Сложно обрабатывать многомерные, комплексные данные |
| Свёрточная нейронная сеть | CNN | Распознавание изображений, обнаружение объектов, анализ видео | Автоматически извлекает пространственные признаки, совместное использование параметров | Для обучения требуются большие объёмы данных и вычислительные ресурсы | |
| Рекуррентная нейронная сеть | RNN | Обработка последовательностей, генерация текста | Обрабатывает последовательности переменной длины | Проблемы затухающих/взрывающихся градиентов, сложно улавливать долгосрочные зависимости | |
| Долгая краткосрочная память | LSTM | Перевод длинных текстовых последовательностей, распознавание речи | Решает проблему долгосрочных зависимостей в RNN | Сложная структура, относительно низкая скорость обучения | |
| Рекуррентный блок с вентилями | GRU | Обработка последовательностей, анализ тональности | Более простая структура, чем LSTM, быстрее обучение | Немного уступает LSTM в сценариях с длинными последовательностями | |
| Генеративная состязательная сеть | GAN | Генерация изображений, перенос стиля, аугментация данных | Высокое качество генерируемых данных, сильное разнообразие | Нестабильное обучение, склонность к коллапсу мод | |
| Трансформер | Трансформер | Обработка естественного языка, мультимодальные задачи | Высокая эффективность параллельных вычислений, сильная способность улавливать длинные зависимости | Высокие вычислительные затраты, склонность к переобучению на малых наборах данных | |
| Автоэнкодер | AE | Сжатие данных, обнаружение аномалий, извлечение признаков | Обучение без учителя, простая структура | Качество генерируемых данных обычно ниже, чем у GAN | |
| Графовая нейронная сеть | GNN | Анализ социальных сетей, предсказание молекулярной структуры | Обрабатывает графоструктурированные данные, извлекает связи между узлами | Сложно обучать, высокие требования к предварительной обработке графовой структуры |