Random Forest
Stellen Sie sich vor, Sie nehmen an einem wichtigen Wissenswettbewerb teil. Wenn Sie vor einer schwierigen Frage stehen, würden Sie dem Urteil eines einzelnen Spitzenexperten vertrauen oder dem Ergebnis einer Abstimmung von 100 kompetenten Teilnehmern? In den meisten Fällen kann kollektive Weisheit individuelle Verzerrungen und Einschränkungen ausgleichen und so zu stabileren und genaueren Entscheidungen führen.
In der Welt des maschinellen Lernens istRandom Forestgenau diesekollektive Weisheit –ein herausragender Vertreter dieser Idee. Durch den Aufbau einer großen Anzahl von Entscheidungsbäumen und deren gemeinsame Abstimmung zur Vorhersage ist er zu einem der leistungsfähigsten und beliebtesten Algorithmen des maschinellen Lernens geworden.
Was ist Random Forest?
Random Forestist ein maschinelles Lernverfahren, das auf Ensemble-Learning basiert. Seine Kernidee ist sehr einfach:Zwei Köpfe sind besser als einer.。
- Forest: bezieht sich auf mehrereEntscheidungsbäume (Decision Tree), die eine Menge bilden.
- Random: bezieht sich auf die zwei Arten von Zufälligkeit, die der Algorithmus beim Aufbau jedes Entscheidungsbaums einführt, wodurch sichergestellt wird, dass jeder Baum einzigartig ist.
Schließlich verwendet der Wald für KlassifikationsaufgabenAbstimmung (Mehrheitsentscheidung), um Ergebnisse zu liefern; für Regressionsaufgaben verwendet erMittelwertbildung, um Ergebnisse zu liefern.
Kernidee: Bagging und Zufälligkeit
Der Erfolg von Random Forest ruht auf zwei Eckpfeilern:
Bagging(Bootstrap Aggregating):
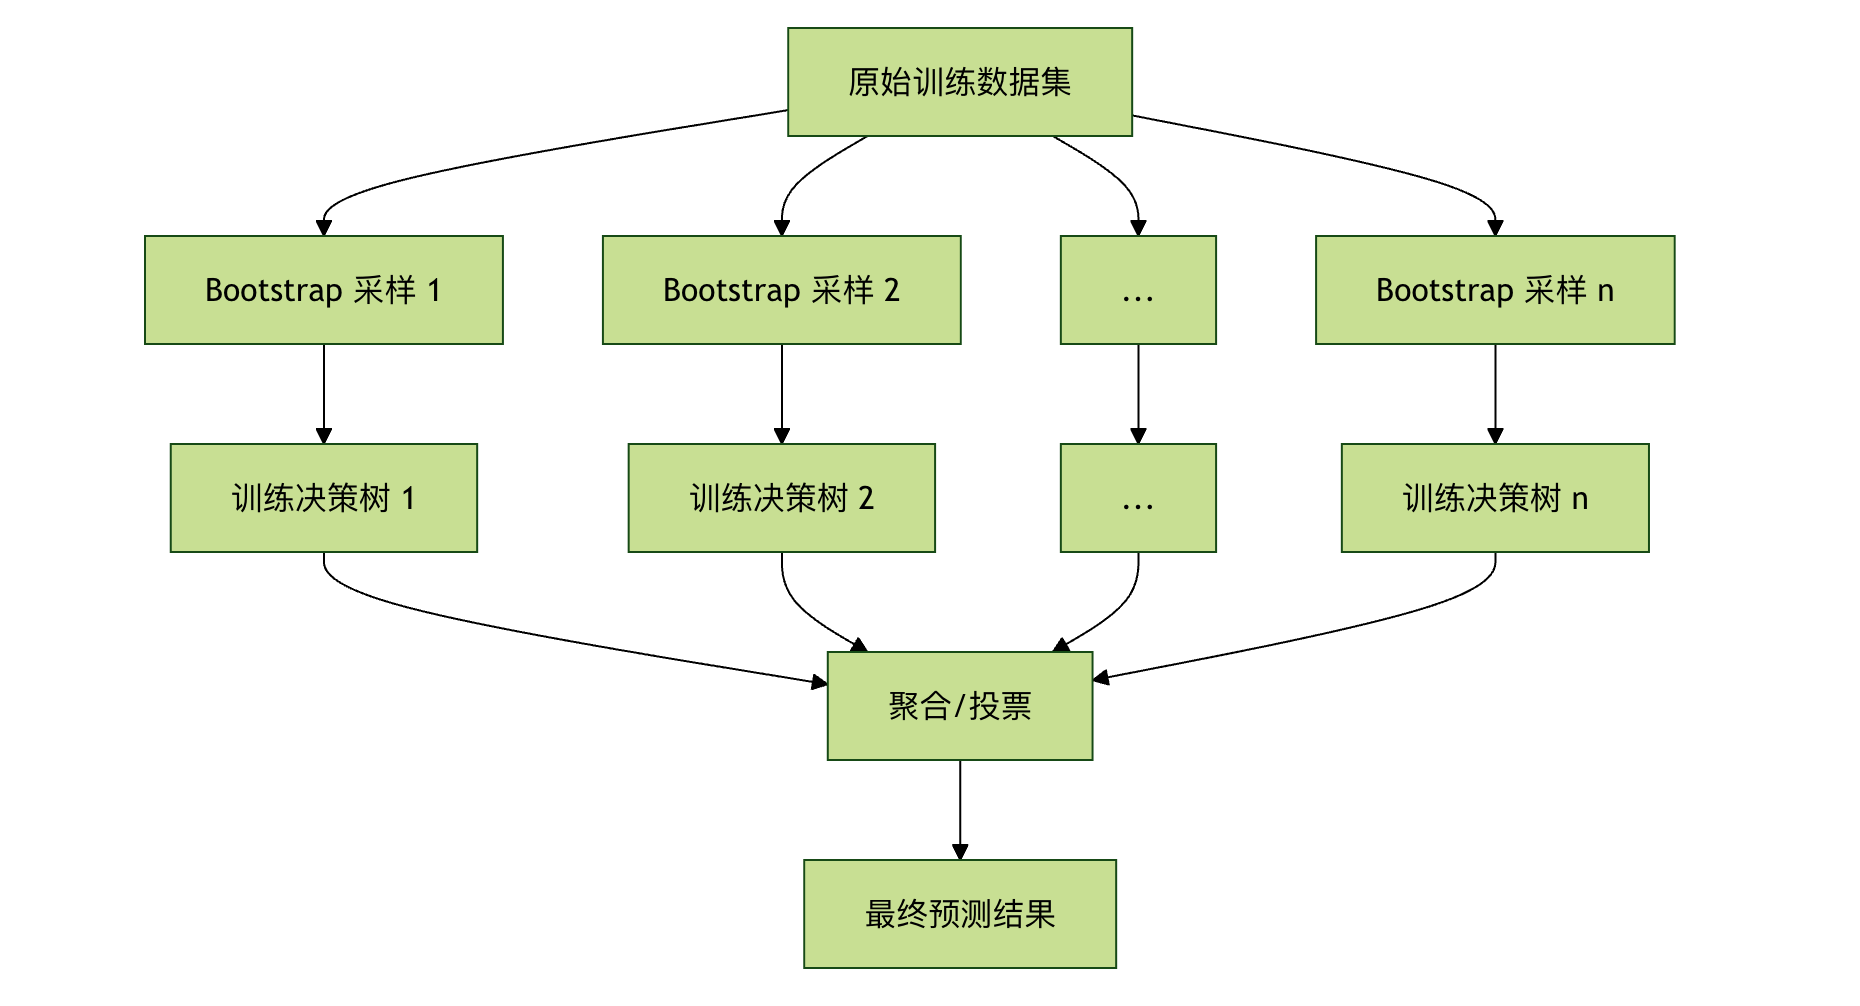
- Bootstrap (Bootstrap-Sampling): Aus dem ursprünglichen Trainingsdatensatz werdenmit Zurücklegenzufällig Stichproben gezogen, um mehrere unterschiedliche Trainings-Teilmengen zu erzeugen. Das bedeutet, dass dieselbe Stichprobe in einer Teilmenge mehrfach vorkommen kann, während eine andere Stichprobe überhaupt nicht vorkommen muss.
- Aggregation: Verwende jede Teilmenge, um unabhängig einen Entscheidungsbaum zu trainieren, und aggregiere schließlich die Ergebnisse aller Bäume (Abstimmung oder Mittelwertbildung).
Zufälligkeit der Merkmale:
- Beim Aufteilen jedes Knotens jedes Baums berücksichtigt der Algorithmus nicht alle Merkmale, sondernwählt zufällig eine Teilmenge aus allen Merkmalen aus, und wählt dann das optimale Split-Merkmal aus dieser Teilmenge aus.
- Dies erhöht die Vielfalt unter den Bäumen weiter und ermöglicht es dem Wald, verschiedene Aspekte des Problems zu sehen.
Einfach ausgedrückt bildet Random Forest ein vielfältigesExpertengremium。Selbst wenn einige der Bäume Fehler machen, können die anderen korrekten Bäume diese durch Abstimmung korrigieren und so eine stabilere und leistungsstärkere Performance erzielen als ein einzelner Entscheidungsbaum.
Algorithmus-Workflow und Schlüsselparameter
Funktionsweise von Random Forest
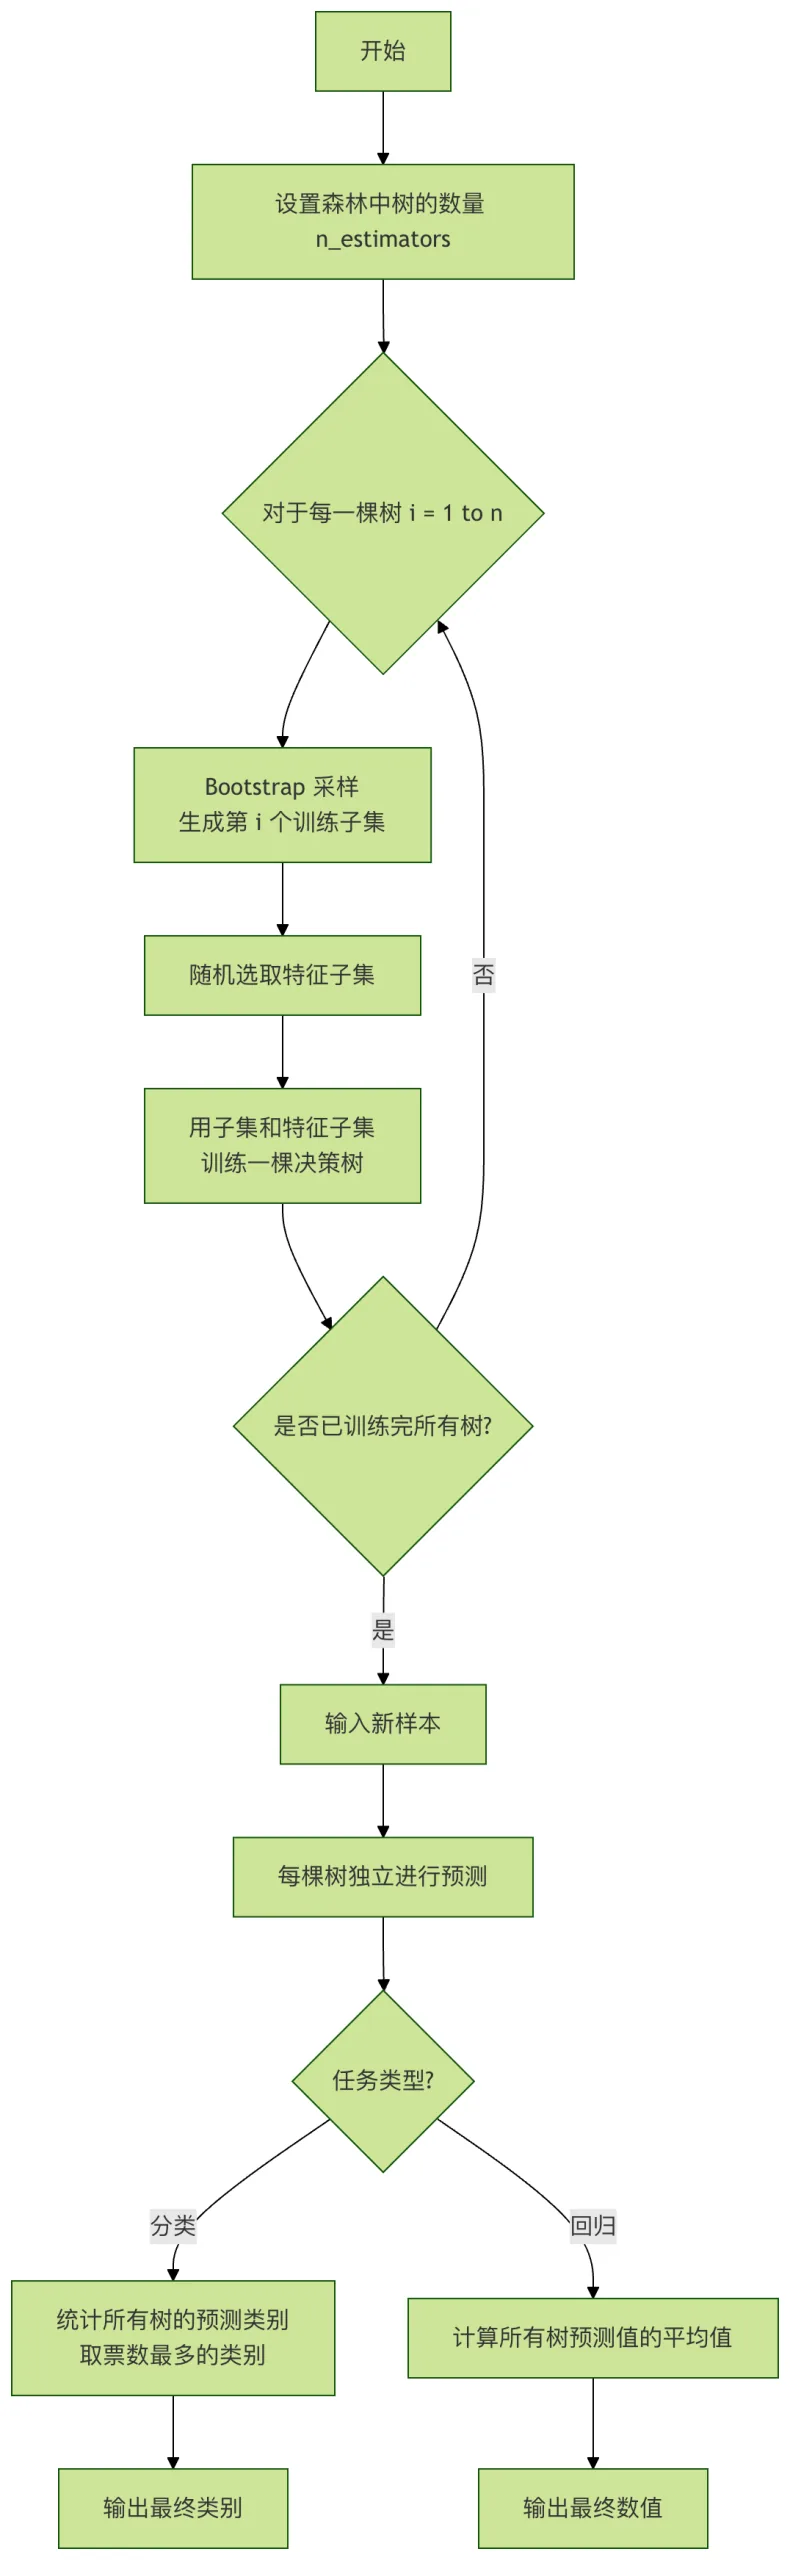
Sehen wir uns seinen Arbeitsprozess anhand eines Flussdiagramms genau an:
Detaillierte Erklärung der wichtigsten Hyperparameter
Bei Verwendung derscikit-learnBibliothek ist es entscheidend, die folgenden Kernparameter zu verstehen:
| Parametername | Bedeutung | Typischer Wert / Auswirkung | Einfache Erklärung |
|---|---|---|---|
n_estimators |
Die Anzahl der Entscheidungsbäume im Wald. | Der Standardwert ist 100. Je größer der Wert, desto stabiler ist das Modell im Allgemeinen und desto besser die Leistung, aber desto höher sind die Rechenkosten. | „Die Anzahl der Komiteemitglieder“. Je mehr Personen, desto zuverlässiger ist die Entscheidung normalerweise, aber desto länger dauert die Besprechung. |
max_depth |
Die maximale Tiefe eines einzelnen Entscheidungsbaums. | StandardNone(keine Begrenzung). Die Begrenzung der Tiefe kann Overfitting verhindern und das Modell einfacher machen. |
"Begrenze die Redezeit jeder Person". Verhindert, dass ein Experte (Baum) zu viel nachdenkt und übermäßig auf Details der Trainingsdaten achtet. |
max_features |
Die Anzahl der Merkmale, die bei der Suche nach dem besten Split berücksichtigt werden. | Kann eine Ganzzahl, eine Gleitkommazahl oder'auto'/'sqrt'. Dies ist der Schlüsselparameter, der "Merkmalszufälligkeit" einführt. |
"Betrachte in jeder Diskussion zufällig nur einige Aspekte". Stellt sicher, dass jeder Baum das Problem aus unterschiedlichen Blickwinkeln analysiert, was die Vielfalt erhöht. |
min_samples_split |
Die Mindestanzahl an Stichproben, die für einen Knoten-Split erforderlich ist. | Der Standardwert ist 2. Je größer der Wert, desto konservativer das Baumwachstum und desto geringer die Wahrscheinlichkeit einer Überanpassung. | "Eine Gruppe muss mindestens ein paar Leute haben, um die Gruppendiskussion fortzusetzen". Vermeidet, dass aufgrund von ein oder zwei Stichproben eine neue Regel erstellt wird. |
min_samples_leaf |
Die Mindestanzahl an Stichproben, die für einen Blattknoten erforderlich ist. | Der Standardwert ist 1. Je größer der Wert, desto glatter das Modell. | "Die endgültige Schlussfolgerung sollte auf mindestens ein paar Fällen basieren". Stellt sicher, dass jede Schlussfolgerung ausreichend durch Daten gestützt wird. |
bootstrap |
Ob Bootstrap-Sampling verwendet werden soll. | StandardTrue. Wenn eingestellt aufFalse, dann wird der gesamte Datensatz zum Trainieren jedes Baums verwendet, aber ein Teil der Zufälligkeit geht verloren. |
"Ob eine Person wiederholt sprechen darf". Es einzuschalten ist die Essenz des Bagging. |
Praktische Übung - Codebeispiele
Wenden wir es mit dem klassischen Iris-Klassifikationsdatensatz in der Praxis an.
Beispiel 1: Grundlegende Klassifikationsaufgabe
Beispiel
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, classification_report
# 1. Daten laden
iris = load_iris()
X = iris.data # Merkmale: Kelchblattlänge, Kelchblattbreite, Blütenblattlänge, Blütenblattbreite
y = iris.target # Labels: drei Iris-Arten
# 2. Trainings- und Testmengen aufteilen
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# 3. Einen Random-Forest-Klassifikator erstellen
# Hier legen wir 100 Bäume fest und begrenzen die maximale Tiefe auf 5
rf_clf = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
# 4. Das Modell trainieren
rf_clf.fit(X_train, y_train)
# 5. Vorhersagen auf dem Testset treffen
y_pred = rf_clf.predict(X_test)
# 6. Modellleistung bewerten
print("Genauigkeit auf dem Testset:", accuracy_score(y_test, y_pred))
print("\nKlassifikationsbericht:")
print(classification_report(y_test, y_pred, target_names=iris.target_names))
Code-Erklärung:
- Bibliotheken importieren:
RandomForestClassifierist der Random-Forest-Klassifikator. - Daten laden: Der Iris-Datensatz hat 150 Proben, 4 Merkmale und 3 Klassen.
- Datenaufteilung: Verwenden Sie 70% der Daten zum Training und 30% zum Testen, um die Generalisierung des Modells auf neue Daten zu validieren.
- Das Modell instanziieren:
random_state=42Reproduzierbare Ergebnisse bei jedem Lauf sicherstellen. - Das Modell trainieren:
fitDie Methode wird 100 Entscheidungsbäume erstellen. - Vorhersage und Bewertung: Verwenden Sie den trainierten Wald, um auf dem Testsatz Vorhersagen zu treffen und Metriken wie die Genauigkeit zu berechnen.
Ausgabe:
      setosa       1.00      1.00      1.00        19
  versicolor       1.00      1.00      1.00        13
   virginica       1.00      1.00      1.00        13

    accuracy                           1.00        45
   macro avg       1.00      1.00      1.00        45
weighted avg       1.00      1.00      1.00        45
Beispiel 2: Anzeigen der Merkmalswichtigkeit
Random Forest bietet außerdem eine leistungsstarke Funktion: die Bewertung des Beitrags jedes Merkmals zu den Vorhersagen.
Beispiel
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, classification_report
import pandas as pd
import matplotlib.pyplot as plt
# -------------------------- Chinesische Schriftart festlegen Start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows-Priorität
'SimHei', 'Microsoft YaHei',
# macOS-Priorität
'PingFang SC', 'Heiti TC',
# Linux-Priorität
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Das Problem beheben, dass Minuszeichen als Quadrate angezeigt werden
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Chinesische Schriftart festlegen Ende --------------------------
# 1. Daten laden
iris = load_iris()
X = iris.data # Merkmale: Kelchblattlänge, Kelchblattbreite, Blütenblattlänge, Blütenblattbreite
y = iris.target # Labels: drei Iris-Arten
# 2. Trainings- und Testmengen aufteilen
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# 3. Einen Random-Forest-Klassifikator erstellen
# Hier legen wir 100 Bäume fest und begrenzen die maximale Tiefe auf 5
rf_clf = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
# 4. Das Modell trainieren
rf_clf.fit(X_train, y_train)
# 5. Vorhersagen auf dem Testset treffen
y_pred = rf_clf.predict(X_test)
# 6. Modellleistung bewerten
print("Genauigkeit auf dem Testset:", accuracy_score(y_test, y_pred))
print("\nKlassifikationsbericht:")
# Feature-Wichtigkeit abrufen
feature_importances = rf_clf.feature_importances_
features = iris.feature_names
# Erstellen eines DataFrame zur einfacheren Ansicht
importance_df = pd.DataFrame({
'Feature': features,
'Importance': feature_importances
}).sort_values('Importance', ascending=False)
print("Rangfolge der Feature-Wichtigkeit:")
print(importance_df)
# Visualisierung
plt.figure(figsize=(8, 5))
plt.barh(importance_df['Feature'], importance_df['Importance'])
plt.xlabel('Merkmalswichtigkeit')
plt.title('Random Forest - Merkmalswichtigkeit')
plt.gca().invert_yaxis() # Die wichtigsten Merkmale oben anzeigen lassen
plt.show()
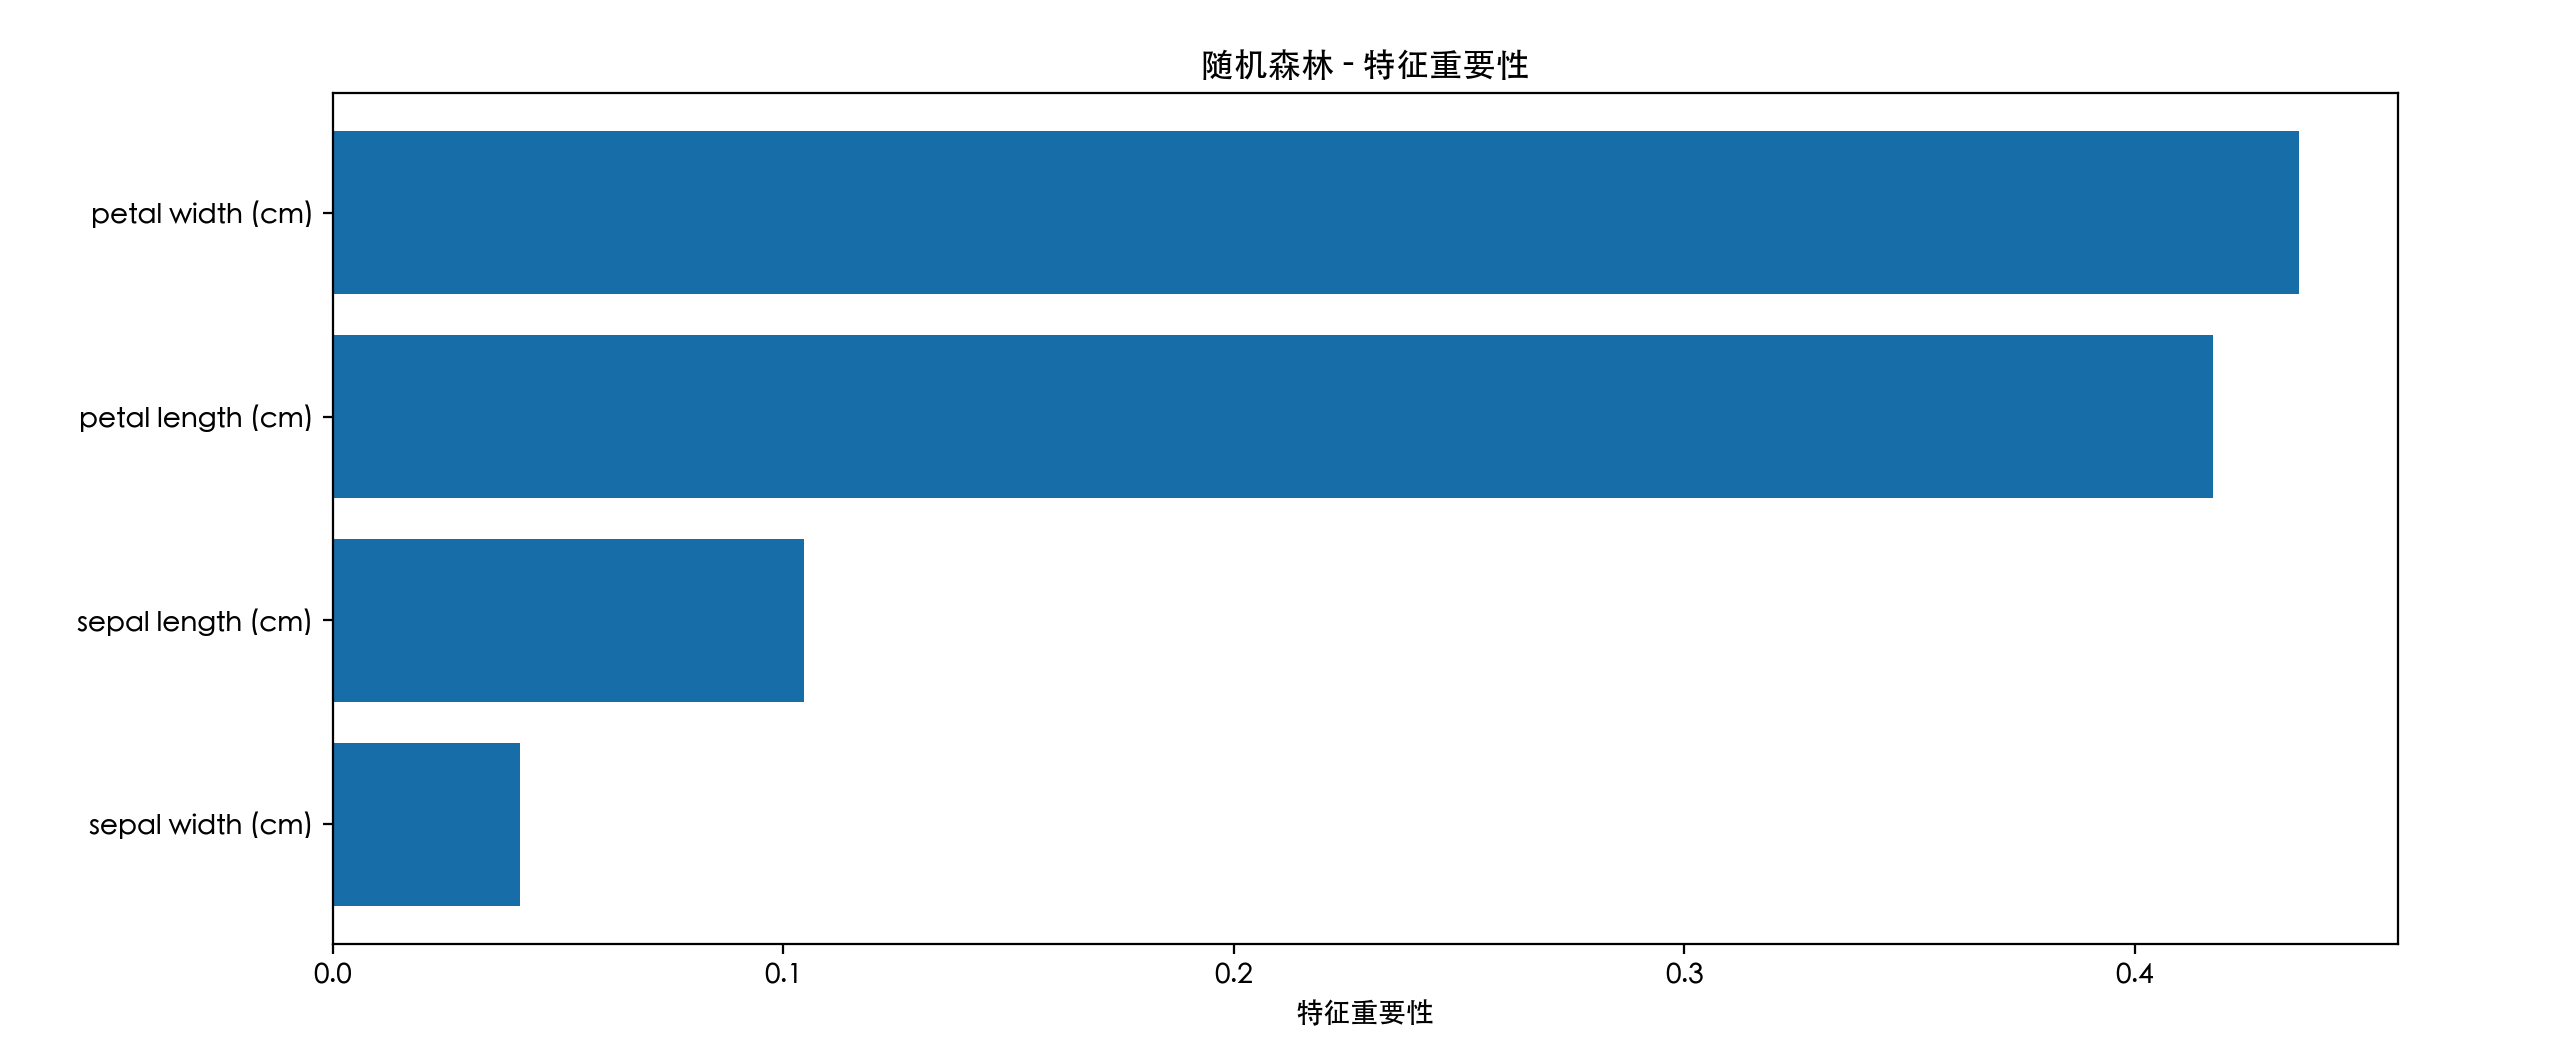
Ausgabeanalyse:Möglicherweise stellen Sie fest, dass Blütenblattlänge und Blütenblattbreite weitaus wichtiger sind als die Kelchblattabmessungen. Dies stimmt stark mit botanischem Allgemeinwissen überein; Blütenblattmerkmale sind tatsächlich der Schlüssel zur Unterscheidung verschiedener Irisblüten.Dieses Merkmal ist äußerst wertvoll für die Merkmalsauswahl und das Datenverständnis.
Teil 4: Vorteile, Nachteile und Anwendungsszenarien
Vorteile
- Hohe Genauigkeit:Ensemble-Lernen kann in der Regel Spitzenleistungen auf den gegebenen Daten erzielen.
- Starke Widerstandsfähigkeit gegen Überanpassung:Dank Bagging und zufälliger Merkmalsauswahl ist eine Überanpassung selbst ohne Pruning nicht leicht möglich.
- Unkomplizierte Datenanforderungen:Kann numerische und kategoriale Merkmale verarbeiten, ohne dass eine Merkmalskalierung (z. B. Normalisierung) erforderlich ist.
- Bietet Merkmalswichtigkeit:Die integrierte Merkmalsbewertung ist ein wertvolles Nebenprodukt.
- Einfach zu parallelisieren:Das Training jedes Baums ist unabhängig und kann leicht parallel beschleunigt werden.
Nachteile
- Geringe Modellinterpretierbarkeit:Eine "Blackbox", die aus Hunderten oder Tausenden von Bäumen besteht, ist viel schwerer zu interpretieren als ein einzelner Entscheidungsbaum.
- Langsame Trainings- und Vorhersagegeschwindigkeit:Wenn die Anzahl der Bäume groß ist, werden mehr Rechenressourcen und Zeit benötigt.
- Großer Speicherbedarf:Es ist notwendig, alle Baumstrukturen des gesamten Waldes zu speichern.
Typische Anwendungsszenarien
- Klassifikationsprobleme:Wie Spam-Erkennung, Krankheitsdiagnose, Bildklassifikation.
- Regressionsprobleme:Wie Hauspreisvorhersage, Umsatzprognose.
- Merkmalsauswahl:Verwenden Sie die von ihr ausgegebene Feature-Wichtigkeit zum Filtern von Merkmalen.
- Umgang mit fehlenden Werten:Random Forests haben eine natürliche Fähigkeit, gut mit fehlenden Werten umzugehen.