ロジスティック回帰(Logistic Regression)
ロジスティック回帰(Logistic Regression)は、分類問題に広く応用される統計的学習手法です。名前には「回帰」とありますが、実際には2値分類や多値分類の問題に使用されるアルゴリズムです。
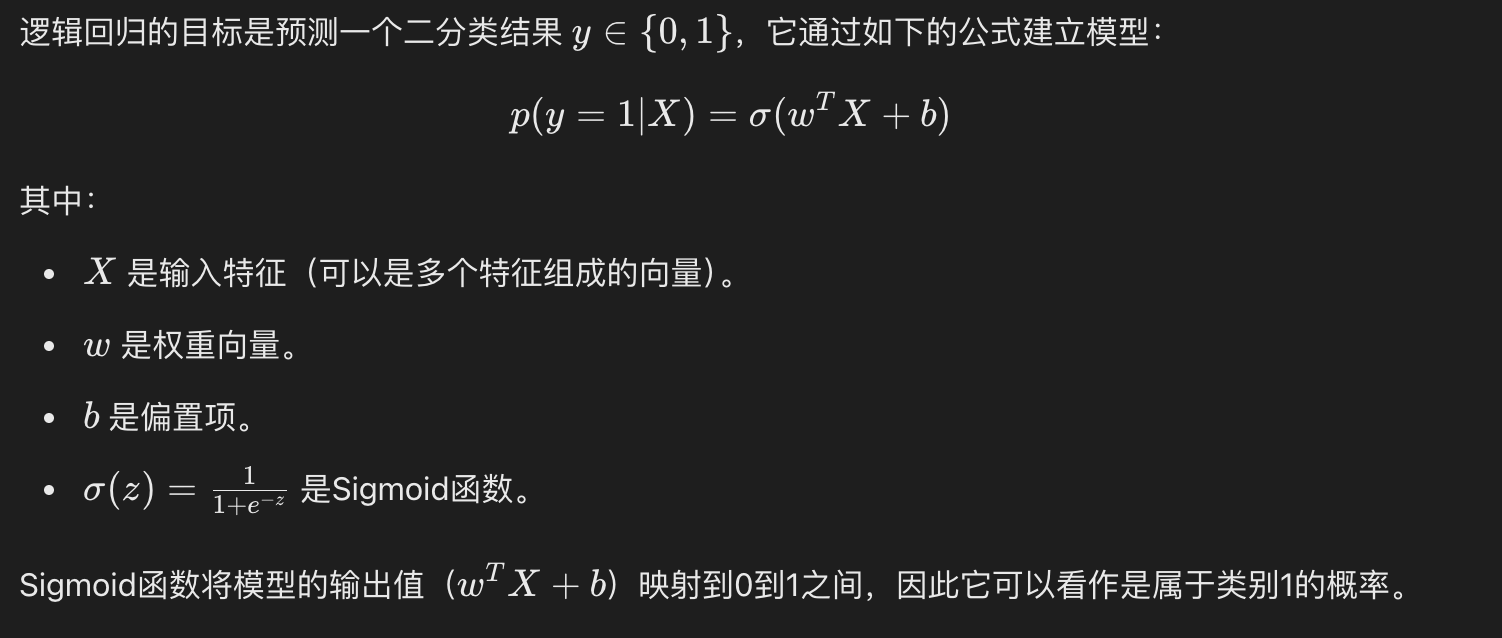
ロジスティック回帰は、ロジスティック関数(シグモイド関数とも呼ばれる)を用いて線形回帰の出力を0と1の間にマッピングし、ある事象が発生する確率を予測します。
ロジスティック回帰は、次のようなさまざまな分類問題に広く応用されています。
- スパムメール検出(スパムかどうか)
- 病気の予測(病気にかかる/かからない)
- 顧客離脱の予測(離脱する/しない)
ロジスティック回帰モデル
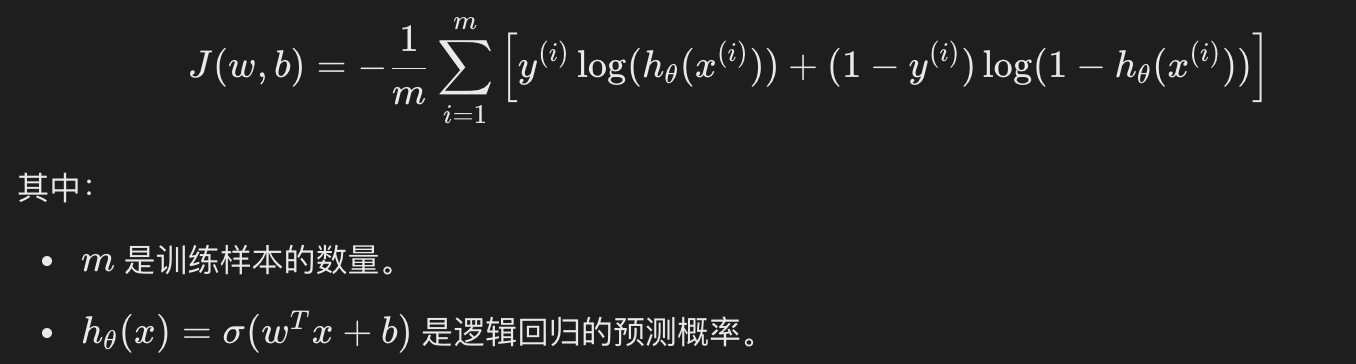
損失関数
ロジスティック回帰の損失関数は対数損失関数(Log Loss)で、その形式は次のとおりです。
勾配降下法による解法
線形回帰と同様に、ロジスティック回帰も通常は勾配降下法を使用して損失関数を最適化し、パラメータwとbを求めます。ロジスティック回帰の勾配更新規則は次のとおりです。
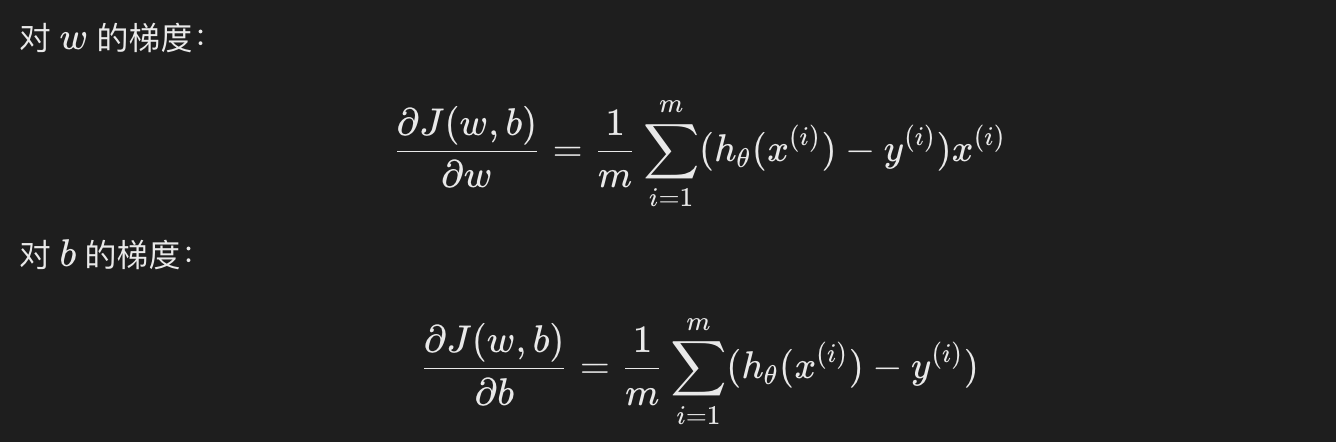
損失関数が収束するまでwとbを更新し続けます。
Pythonを使用したロジスティック回帰の実装
次に、PythonとScikit-learnライブラリを使用して、簡単なロジスティック回帰モデルを実装します。
1、必要なライブラリのインポート
実例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
2、データセットの読み込み
Scikit-learnに付属のIrisデータセットを使用します。Irisデータセットには150個のサンプルが含まれ、各サンプルには4つの特徴があります。目標はサンプルを3つのクラスに分類することです。問題を簡単にするため、最初の2つの特徴のみを使用し、2値分類問題に変換します。
実例
# データセットを読み込む
iris = load_iris()
X = iris.data[:, :2] # 最初の2つの特徴のみを使用
y = (iris.target != 0) * 1 # ターゲットを2値分類問題に変換
# トレーニングセットとテストセットに分割
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
iris = load_iris()
X = iris.data[:, :2] # 最初の2つの特徴のみを使用
y = (iris.target != 0) * 1 # ターゲットを2値分類問題に変換
# トレーニングセットとテストセットに分割
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
3、ロジスティック回帰モデルのトレーニング
実例
# ロジスティック回帰モデルを作成
model = LogisticRegression()
# モデルをトレーニング
model.fit(X_train, y_train)
model = LogisticRegression()
# モデルをトレーニング
model.fit(X_train, y_train)
4、モデルの評価
実例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
# データセットを読み込む
iris = load_iris()
X = iris.data[:, :2] # 最初の2つの特徴のみを使用
y = (iris.target != 0) * 1 # ターゲットを2値分類問題に変換
# トレーニングセットとテストセットに分割
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# ロジスティック回帰モデルを作成
model = LogisticRegression()
# モデルをトレーニング
model.fit(X_train, y_train)
# テストセットを予測
y_pred = model.predict(X_test)
# 精度を計算
accuracy = accuracy_score(y_test, y_pred)
print(f"模型准确率: {accuracy:.2f}")
# 混同行列
conf_matrix = confusion_matrix(y_test, y_pred)
print("混淆矩阵:")
print(conf_matrix)
# 分類レポート
class_report = classification_report(y_test, y_pred)
print("分类报告:")
print(class_report)
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
# データセットを読み込む
iris = load_iris()
X = iris.data[:, :2] # 最初の2つの特徴のみを使用
y = (iris.target != 0) * 1 # ターゲットを2値分類問題に変換
# トレーニングセットとテストセットに分割
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# ロジスティック回帰モデルを作成
model = LogisticRegression()
# モデルをトレーニング
model.fit(X_train, y_train)
# テストセットを予測
y_pred = model.predict(X_test)
# 精度を計算
accuracy = accuracy_score(y_test, y_pred)
print(f"模型准确率: {accuracy:.2f}")
# 混同行列
conf_matrix = confusion_matrix(y_test, y_pred)
print("混淆矩阵:")
print(conf_matrix)
# 分類レポート
class_report = classification_report(y_test, y_pred)
print("分类报告:")
print(class_report)
出力結果は次のとおりです。
模型准确率: 1.00
混淆矩阵:
[[19  0]
 [ 0 26]]
分类报告:
              precision    recall  f1-score   support

           0       1.00      1.00      1.00        19
           1       1.00      1.00      1.00        26

    accuracy                           1.00        45
   macro avg       1.00      1.00      1.00        45
weighted avg       1.00      1.00      1.00        45
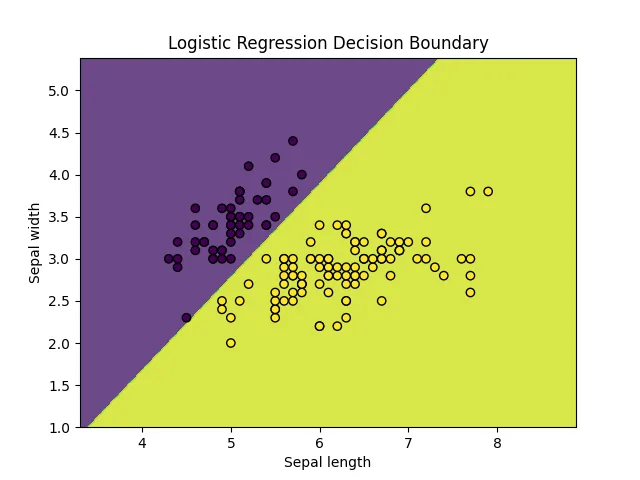
5、決定境界の可視化
実例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
# データセットを読み込む
iris = load_iris()
X = iris.data[:, :2] # 最初の2つの特徴のみを使用
y = (iris.target != 0) * 1 # ターゲットを2値分類問題に変換
# トレーニングセットとテストセットに分割
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# ロジスティック回帰モデルを作成
model = LogisticRegression()
# モデルをトレーニング
model.fit(X_train, y_train)
# テストセットを予測
y_pred = model.predict(X_test)
# 決定境界を可視化
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
xx, yy = np.meshgrid(np.arange(x_min, x_max, 0.01),
np.arange(y_min, y_max, 0.01))
Z = model.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
plt.contourf(xx, yy, Z, alpha=0.8)
plt.scatter(X[:, 0], X[:, 1], c=y, edgecolors='k', marker='o')
plt.xlabel('Sepal length')
plt.ylabel('Sepal width')
plt.title('Logistic Regression Decision Boundary')
plt.show()
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
# データセットを読み込む
iris = load_iris()
X = iris.data[:, :2] # 最初の2つの特徴のみを使用
y = (iris.target != 0) * 1 # ターゲットを2値分類問題に変換
# トレーニングセットとテストセットに分割
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# ロジスティック回帰モデルを作成
model = LogisticRegression()
# モデルをトレーニング
model.fit(X_train, y_train)
# テストセットを予測
y_pred = model.predict(X_test)
# 決定境界を可視化
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
xx, yy = np.meshgrid(np.arange(x_min, x_max, 0.01),
np.arange(y_min, y_max, 0.01))
Z = model.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
plt.contourf(xx, yy, Z, alpha=0.8)
plt.scatter(X[:, 0], X[:, 1], c=y, edgecolors='k', marker='o')
plt.xlabel('Sepal length')
plt.ylabel('Sepal width')
plt.title('Logistic Regression Decision Boundary')
plt.show()
表示は次のとおりです。
まとめ
- ロジスティック回帰は、シグモイド関数を使用して線形回帰の出力を確率値に変換し、2値分類問題を解決します。
- ロジスティック回帰のトレーニングプロセスでは、対数損失関数を最小化することでモデルパラメータを最適化します。
- 勾配降下法は、モデルパラメータを更新するための一般的な最適化手法です。と。
- Pythonの
scikit-learnライブラリは、ロジスティック回帰を実装するためのシンプルで使いやすいインターフェースを提供し、モデルのトレーニング、評価、可視化を簡単に行うことができます。