Lineare Regression
Lineare Regression ist einer der grundlegendsten und am weitesten verbreiteten Algorithmen im maschinellen Lernen.
Lineare Regression ist der grundlegendste Machine-Learning-Algorithmus zur Vorhersage kontinuierlicher Werte; er geht davon aus, dass die Zielvariableyund die Merkmalsvariablenxeine lineare Beziehung haben, und versucht, eine am besten passende Gerade zu finden, die diese Beziehung beschreibt.
y = w * x + b
Wobei:
yist der vorhergesagte Wertxist die Merkmalsvariablewist das Gewicht (die Steigung)bist der Bias (Achsenabschnitt)
Das Ziel der linearen Regression ist es, die optimalenwundb, sodass der vorhergesagte Wertyhat den minimalen Fehler vom wahren Wert. Die häufig verwendete Fehlerfunktion ist der mittlere quadratische Fehler (MSE):
MSE = 1/n * Σ(y_i - y_pred_i)^2
Wobei:
- y_i ist der tatsächliche Wert.
- y_pred_i ist der vorhergesagte Wert.
- n ist die Anzahl der Datenpunkte.
Unser Ziel ist es, MSE durch Anpassung von w und b zu minimieren.
Wie löst man eine lineare Regression?
1. Methode der kleinsten Quadrate
Die Methode der kleinsten Quadrate ist ein gängiger Ansatz zur Lösung einer linearen Regression; sie ermittelt die optimalen Werte (w) und (b), indem sie die folgenden Gleichungen löst.
Das Ziel der Methode der kleinsten Quadrate ist es, die Residuenquadratsumme (RSS) zu minimieren, mit der Formel:
\[ \text{RSS} = \sum_{i=1}^n (y_i - \hat{y}_i)^2 \]
Wobei:
\( y_i \)ist der tatsächliche Wert.\( \hat{y}_i \)ist der vorhergesagte Wert, der\( \hat{y}_i = w x_i + b \)durch das lineare Regressionsmodell berechnet wird.
Durch Minimierung von RSS erhält man die folgenden Normalgleichungen:
\[ \begin{cases} w \sum_{i=1}^n x_i^2 + b \sum_{i=1}^n x_i = \sum_{i=1}^n x_i y_i \\ w \sum_{i=1}^n x_i + b n = \sum_{i=1}^n y_i \end{cases} \]
Matrixform
Schreiben Sie die Normalgleichungen in Matrixform:
\[ \begin{bmatrix} \sum_{i=1}^n x_i^2 & \sum_{i=1}^n x_i \\ \sum_{i=1}^n x_i & n \end{bmatrix} \begin{bmatrix} w \\ b \end{bmatrix} = \begin{bmatrix} \sum_{i=1}^n x_i y_i \\ \sum_{i=1}^n y_i \end{bmatrix} \]
Lösungsmethode
Durch Lösen der obigen Matrixgleichung erhält man die optimale Lösung.\( w \)und\( b \):
\[ \begin{bmatrix} w \\ b \end{bmatrix} = \begin{bmatrix} \sum_{i=1}^n x_i^2 & \sum_{i=1}^n x_i \\ \sum_{i=1}^n x_i & n \end{bmatrix}^{-1} \begin{bmatrix} \sum_{i=1}^n x_i y_i \\ \sum_{i=1}^n y_i \end{bmatrix} \]
2. Gradientenabstieg
Das Ziel des Gradientenabstiegs ist es, die Verlustfunktion zu minimieren\( J(w, b) \) . Bei linearen Regressionsproblemen wird üblicherweise der mittlere quadratische Fehler (MSE) als Verlustfunktion verwendet:
\[ J(w, b) = \frac{1}{2m} \sum_{i=1}^m (y_i - \hat{y}_i)^2 \]
Wobei:
\( m \)ist die Anzahl der Stichproben.\( y_i \)ist der tatsächliche Wert.\( \hat{y}_i \)ist der vorhergesagte Wert, der\( \hat{y}_i = w x_i + b \)durch das lineare Regressionsmodell berechnet wird.
Der Gradient ist die partielle Ableitung der Verlustfunktion nach den Parametern und gibt die Richtung der Änderung der Verlustfunktion im Parameterraum an. Bei der linearen Regression wird der Gradient wie folgt berechnet:
\[ \frac{\partial J}{\partial w} = -\frac{1}{m} \sum_{i=1}^m x_i (y_i - \hat{y}_i) \]
\[ \frac{\partial J}{\partial b} = -\frac{1}{m} \sum_{i=1}^m (y_i - \hat{y}_i) \]
Regeln zur Parameteraktualisierung
Der Gradientenabstieg aktualisiert die Parameter mithilfe der folgenden Regeln:\( w \)und\( b \):
\[ w := w - \alpha \frac{\partial J}{\partial w} \]
\[ b := b - \alpha \frac{\partial J}{\partial b} \]
Wobei:
\( \alpha \)ist die Lernrate, die die Schrittweite jeder Aktualisierung steuert.
Schritte des Gradientenabstiegs
- Initialisieren Sie die Parameter: initialisieren Sie
\( w \)und\( b \)die Werte (normalerweise auf 0 oder Zufallswerte gesetzt). - Berechnen Sie die Verlustfunktion: Berechnen Sie den Wert der Verlustfunktion unter den aktuellen Parametern
\( J(w, b) \)。 - Berechnen Sie den Gradienten: Berechnen Sie die partielle Ableitung der Verlustfunktion nach
\( w \)und\( b \)die Parameter. - Parameter aktualisieren: entsprechend dem Gradienten aktualisieren
\( w \)und\( b \)。 - Iteration wiederholen: Wiederhole die Schritte 2 bis 4, bis die Verlustfunktion konvergiert oder die maximale Anzahl an Iterationen erreicht ist.
Lineare Regression mit Python implementieren
Nachfolgend verwenden wir ein einfaches Beispiel, um zu demonstrieren, wie man lineare Regression mit Python implementiert.
1. Notwendige Bibliotheken importieren
Beispiel
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
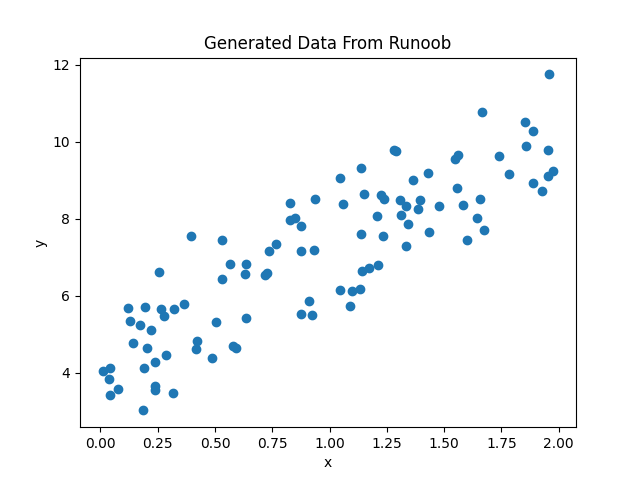
2. Simulierte Daten generieren
Beispiel
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
# Einige Zufallsdaten generieren
np.random.seed(0)
x = 2 * np.random.rand(100, 1)
y = 4 + 3 * x + np.random.randn(100, 1)
# Die Daten visualisieren
plt.scatter(x, y)
plt.xlabel('x')
plt.ylabel('y')
plt.title('Generierte Daten aus dem Beispiel')
plt.show()
Die Anzeige ist wie folgt:
3. Scikit-learn für lineare Regression verwenden
Beispiel
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
# Einige Zufallsdaten generieren
np.random.seed(0)
x = 2 * np.random.rand(100, 1)
y = 4 + 3 * x + np.random.randn(100, 1)
# Lineares Regressionsmodell erstellen
model = LinearRegression()
# Modell anpassen
model.fit(x, y)
# Modellparameter ausgeben
print(f"Steigung (w): {model.coef_)
print(f"Achsenabschnitt (b): {model.intercept_)
# Vorhersagen
y_pred = model.predict(x)
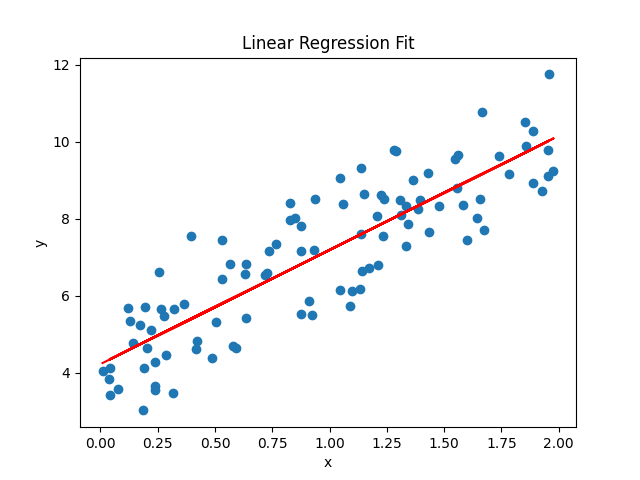
# Anpassungsergebnis visualisieren
plt.scatter(x, y)
plt.plot(x, y_pred, color='red')
plt.xlabel('x')
plt.ylabel('y')
plt.title('Anpassung der linearen Regression')
plt.show()
Ausgabeergebnis:
斜率 (w): 2.968467510701019
截距 (b): 4.222151077447231
Die Anzeige ist wie folgt:
Wir können diescore()Methode zur Bewertung der Modellleistung, Rückgabe des R^2-Werts.
Beispiel
from sklearn.linear_model import LinearRegression
# Einige Zufallsdaten generieren
np.random.seed(0)
x = 2 * np.random.rand(100, 1)
y = 4 + 3 * x + np.random.randn(100, 1)
# Lineares Regressionsmodell erstellen
model = LinearRegression()
# Modell anpassen
model.fit(x, y)
# Modell-Score berechnen
score = model.score(x, y)
print("Modellbewertung:", score)
Das Ausgabeergebnis ist:
模型得分: 0.7469629925504755
4. Gradientenabstieg manuell implementieren
Beispiel
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
# Einige Zufallsdaten generieren
np.random.seed(0)
x = 2 * np.random.rand(100, 1)
y = 4 + 3 * x + np.random.randn(100, 1)
# Parameter initialisieren
w = 0
b = 0
learning_rate = 0.1
n_iterations = 1000
# Gradientenabstieg
for i in range(n_iterations):
y_pred = w * x + b
dw = -(2/len(x)) * np.sum(x * (y - y_pred))
db = -(2/len(x)) * np.sum(y - y_pred)
w = w - learning_rate * dw
b = b - learning_rate * db
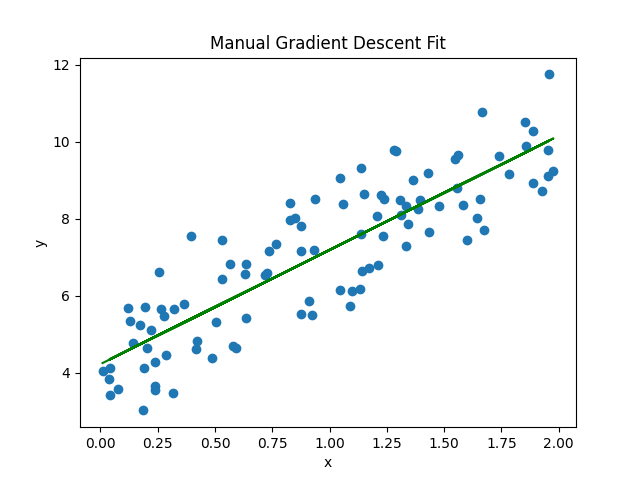
# Die endgültigen Parameter ausgeben
print(f"Manuell implementierte Steigung (w): {w}")
print(f"Manuell implementierter Achsenabschnitt (b): {b}")
# Manuell implementiertes Anpassungsergebnis visualisieren
y_pred_manual = w * x + b
plt.scatter(x, y)
plt.plot(x, y_pred_manual, color='green')
plt.xlabel('x')
plt.ylabel('y')
plt.title('Manuelle Anpassung per Gradientenabstieg')
plt.show()
Ausgabeergebnis:
手动实现的斜率 (w): 2.968467510701028
手动实现的截距 (b): 4.222151077447219
Die Anzeige ist wie folgt: