ディープラーニング vs 従来の機械学習
想像してみてください。あなたが子どもに猫と犬の見分け方を教えているとします。従来の方法は、絵本を取り出して、写真を指さしながら「これは猫だ。尖った耳とひげ、長いしっぽがある」「これは犬だ。耳は垂れていることが多く、鼻はもっと長い」と説明するやり方です。あなたは、両者を区別するためのルールと特徴。
を子どもに明確に教えています。一方、別の方法としては、子どもに何千枚もの猫と犬の写真を見せて、それぞれが猫か犬かだけを伝えるやり方があります。十分な数の観察を経て、子どもの脳は毛並みの質感、目の表情、体の輪郭など、言葉にしにくい複雑な区別の特徴を自ら見つけ出します。この方法は、データに語らせる。
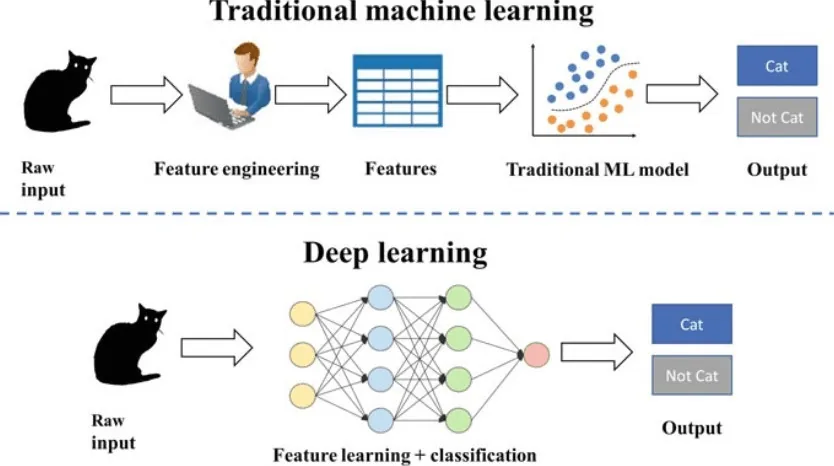
という考え方に近いものです。この2つの教え方は、機械学習分野における2つの重要なパラダイムにちょうど対応しています:従来の機械学習とディープラーニング。本記事では、初心者向けに両者の中心的な考え方、動作原理、長所・短所、適用シナリオを明確に解説し、マクロな理解を構築し、今後の学習の方向性を選ぶ助けとします。
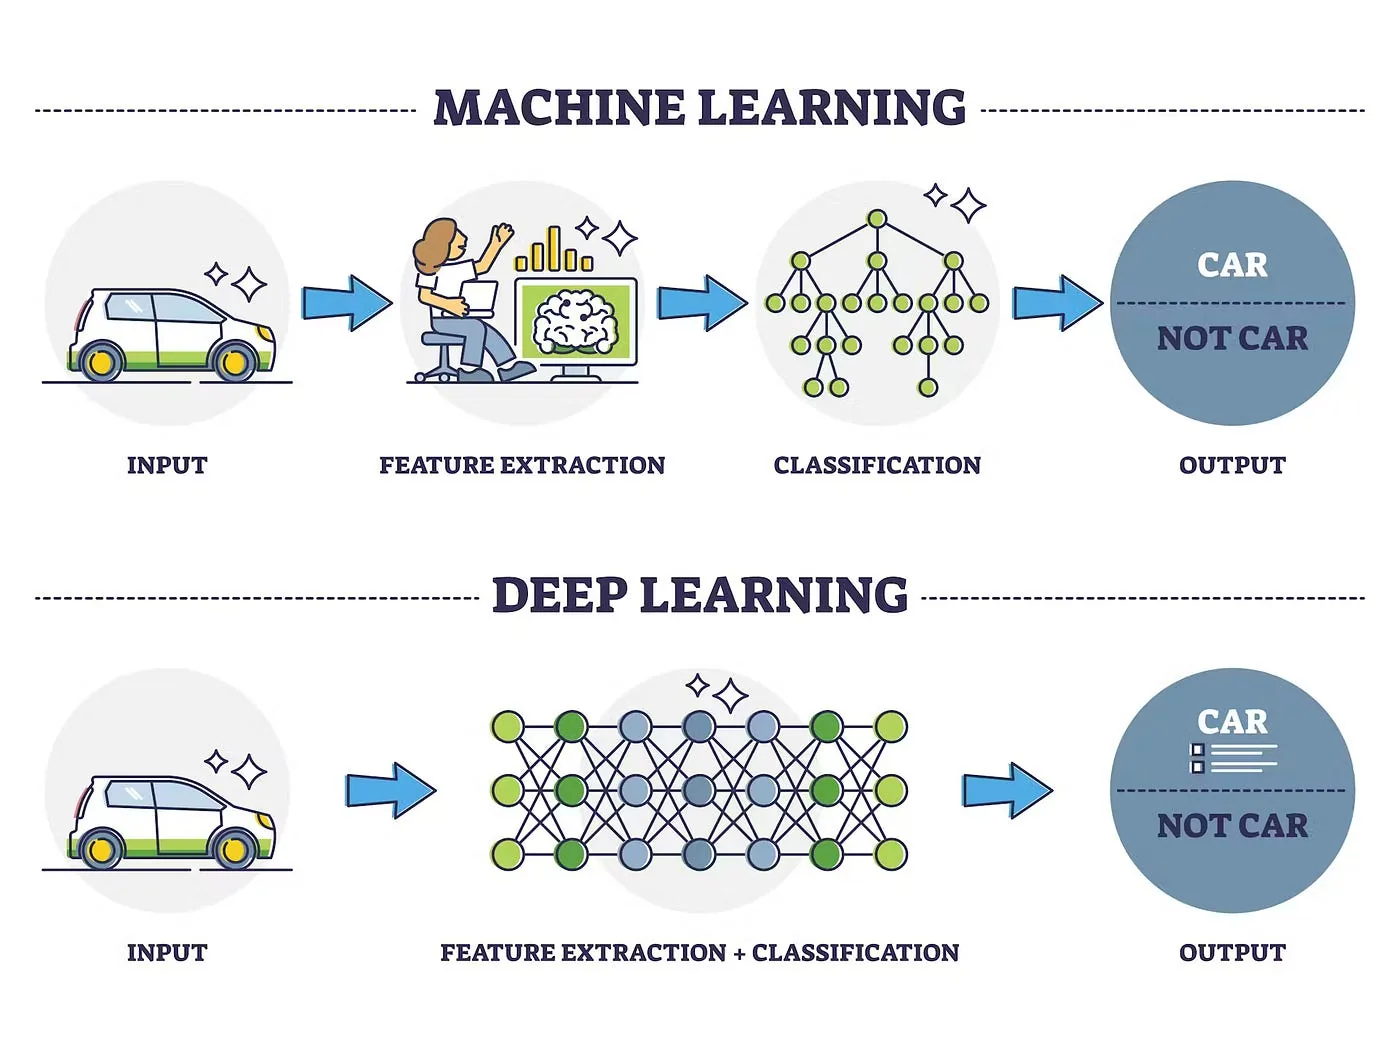
第一部: 従来の機械学習 —— ルールと特徴に基づくアナリスト
従来の機械学習は、明確な指示と構造化データを必要とするアナリストと見なすことができます。
従来の機械学習とは?
従来の機械学習は一連のアルゴリズムの集合であり、その中心的な考え方は次の通りです:データから規則性(モデル)を学習し、その規則性を使って新しいデータの予測や意思決定を行う。その成功は、前段階かつ極めて重要なステップに大きく依存しています:特徴量エンジニアリング。
中核となるワークフロー
フローチャートを通して、従来の機械学習の動作プロセスを直感的に理解しましょう:
プロセス解説:
- 特徴量エンジニアリングこれは最も中心ので、人間の知恵に最も依存する工程です。元データ(画像のピクセル、テキストの単語など)から、問題解決に役立つ定量化可能な特徴量を抽出する必要があります。例えば、スパムメール判定では、特徴量は「無料」という言葉が含まれるか、送信者アドレスがアドレス帳にあるかなどです。
- アルゴリズムの選択と学習: 処理済みの特徴データを選択したアルゴリズム(サポートベクターマシン SVM、決定木など)に入力します。アルゴリズムは、これらの特徴量に基づいて結果(スパムか否かなど)を最もよく予測できる関数やルールを見つけようとします。
- 予測: 新しいメールが届くと、システムはまず同じ特徴量を抽出し、学習済みモデルに渡して判定します。
主な特徴と長所・短所
| 特徴 | 説明 | 長所 | 短所 |
|---|---|---|---|
| 特徴量エンジニアリングへの依存度が高い | モデルの性能上限は特徴量の質によって決まります。 | 解釈性が高く、人間の専門知識を組み込むことができます。 | 特徴量の設計と抽出に多くのドメイン知識と時間が必要で、コストが高い。 |
| モデルが比較的単純 | 通常、線形モデルやツリーモデルなどを使用します。 | 学習が速く、必要な計算リソースが少ない。 | 処理非構造化データ(画像、音声、自然言語)の能力は限定的で、その深く複雑なパターンを捉えるのが難しい。 |
| 解釈性が比較的良好 | モデルがどのように判断を下すかを理解できます(例: 決定木のルール経路)。 | 金融、医療など、判断の説明が求められる分野で極めて重要です。 | 解釈性を追求するため、予測精度の一部を犠牲にすることがあります。 |
簡単な例え: 従来の機械学習は、強力な公式や統計ツールを持っているが、すべての分析材料を自分で準備しなければならないアナリストのようなものです。。
第二部: ディープラーニング —— 自動学習する知覚者
ディープラーニングは機械学習の一分野であり、人間の脳のニューロンの働き方を模倣して、機械が生データから多層的な特徴表現を自動的に学習することを目指します。
ディープラーニングとは?
ディープラーニングの中核は人工ニューラルネットワーク、特に層数の深いディープニューラルネットワークです。その最大の特徴はエンドツーエンドで学習できることです: 最も生のデータ(画像の生ピクセルなど)を入力すると、最終的な結果(画像のカテゴリなど)を出力し、途中の複雑な特徴抽出プロセスはネットワークが自動的に行います。
中核となる動作アーキテクチャ
ディープラーニング、特に画像認識に使われる畳み込みニューラルネットワークの学習プロセスは、階層的で、浅い層から深い層へと進みます:

アーキテクチャ解説:
- 階層的な特徴学習: ネットワークの最初の層は、画像内のエッジとコーナーだけを認識するかもしれません。2番目の層はこれらのエッジを組み合わせて、単純なテクスチャと形状(円形、縞模様など)を認識します。さらに深い層は、これらの単純な形状を組み合わせて複雑な部品やオブジェクト(目、車のドアなど)を認識します。最後の数層は、これらの部品を組み合わせて完全なオブジェクト概念(猫、自動車など)を認識します。
- エンドツーエンド学習: ネットワークにエッジやテクスチャが何かを教える必要はありません。大量のラベル付き生データ(画像と対応する猫/犬のラベル)を提供し、逆伝播アルゴリズムによって、ネットワークは内部の数百万から数十億のパラメータを自動的に調整し、どのピクセル組み合わせパターンが猫に対応し、どのパターンが犬に対応するかを自分で学習します。
主な特徴と長所・短所
| 特徴 | 説明 | 長所 | 短所 |
|---|---|---|---|
| 自動特徴量エンジニアリング | 生データから多層的で抽象的な特徴を自動的に学習できます。 | 面倒な手作業の特徴量エンジニアリングが不要になり、特に画像、音声、テキストの処理で優れた性能を発揮します。 | 「ブラックボックス」のようであり、内部の意思決定プロセスを説明するのが難しい。 |
| 非構造化データの処理能力が高い | ピクセル、音波、単語シーケンスなどの複雑なデータの処理に生来適しています。 | コンピュータビジョン、自然言語処理、音声認識などの分野で人間のレベルに達するか、それを超えています。 | 必要とする大量のデータ学習には大量のデータが必要で、データ量が不足すると性能が低下しやすい。 |
| モデルが複雑でパラメータが多い | ネットワークの層が深く、多数のニューロンと接続を含みます。 | 極めて複雑で非線形な関係をモデル化でき、可能性は大きい。 | 学習に非常に時間がかかり、強力な計算リソース(GPUなど)が必要で、モデルのデプロイにも一定の計算能力が必要です。 |
| 解釈性が低い | モデルがなぜ特定の判断を下したのかを理解するのが難しい。 | - | 厳密な説明が求められる分野(融資審査、病気の診断など)では応用が制限されます。 |
簡単な例え: ディープラーニングは、多層の情報処理ネットワークを持ち、大量の観察を通じて自己成長する知覚者のようなものです。しかし、その結論に至るプロセスはあまり透明ではありません。
第三部: 重要な比較と選択方法
それでは、両者を直接比較し、選択のアドバイスを提示します。
中核的な違いの比較表
| 比較の観点 | 従来の機械学習 | ディープラーニング |
|---|---|---|
| データへの依存度 | データ量に対する要求は比較的低く、中規模・小規模のデータセットに適しています。 | ビッグデータに極度に依存し、データが多いほど一般的に性能が向上します。 |
| 特徴量処理 | 手動特徴量エンジニアリングが鍵であり、主な負担です。 | 自動特徴量の抽出と抽象化を自動で行います。 |
| 計算リソース | 通常CPU上で効率的に動作し、要求は低い。 | 学習に強力なGPUが必要で、計算コストが高い。 |
| モデルの解釈性 | 比較的良好で、意思決定プロセスが比較的透明です。 | 低く、しばしば「ブラックボックスモデル」と見なされます。 |
| 問題領域 | 処理が得意構造化データ(表データ、明確な特徴があるシナリオ)。 | 処理が得意非構造化データ(画像、音声、テキスト、動画)。 |
| 学習時間 | 比較的短く、数分から数時間。 | 通常非常に長く、数時間から数週間、あるいはそれ以上。 |
| 参入障壁 | 比較的低く、理解しやすくプロトタイプを実装しやすい。 | 障壁が高く、ニューラルネットワークやパラメータ調整などの複雑な知識が必要です。 |
実践的な選択ガイド: どちらを使うべきか?
以下の判断基準に従うことができます:
あなたのデータはどのようなタイプですか?
- もし構造化された表形式データ(Excelの表のように、年齢、収入、購入履歴などの列を含む)、従来の機械学習(勾配ブースティング木 XGBoost、ランダムフォレストなど)を優先的に検討してください。
- もし画像、音声、テキスト、またはシーケンスデータの場合、深層学習(CNN、RNN、Transformer)が通常はより良い選択です。
データはどれくらいありますか?
- データ量が限られている場合(数千〜数万件)、従来の機械学習の方が安定していることが多いです。
- 大量のデータ(数十万件以上)がある場合、深層学習の威力が十分に発揮できます。
モデルの解釈性を求めますか?
- 金融リスク管理、医療補助診断などのシーンでは、なぜローンを拒否したのか、なぜこの疾患を疑うのかを説明できる必要があり、従来の機械学習がより安全な選択です。
- 画像分類、音声アシスタント、レコメンドシステムなどのシーンでは、効果優先でブラックボックスを受け入れられる場合は、深層学習が優位です。
計算リソースはどのような状況ですか?
- 強力なGPUや十分な時間がない場合は、従来の機械学習から始めるのがより実用的な選択です。
一言でまとめると:従来の機械学習はデータ分析の芸術であり、深層学習は知覚と表現の科学です。それらは置き換えの関係ではなく、補完し合うツールボックスです。優れたAI実践者は、具体的な問題に応じてツールボックスから最も適切なツールを選択すべきです。
その他の拡張