Anwendungen des maschinellen Lernens
Anwendungen des maschinellen Lernens lassen sich in mehrere große Bereiche unterteilen, von denen jeder seine eigenen einzigartigen Anwendungsszenarien und Herausforderungen hat:
- Computer Vision: Lassen Sie Maschinen die Welt "sehen"
- Verarbeitung natürlicher Sprache: Lassen Sie Maschinen menschliche Sprache "verstehen"
- Empfehlungssysteme: Personalisierte Inhaltsempfehlungen
- Prädiktive Analytik: Sagen Sie zukünftige Trends und Ergebnisse vorher
- Anomalieerkennung: Entdecken Sie ungewöhnliche Muster
Warum benötigen diese Anwendungen maschinelles Lernen?
Stellen Sie sich vor, traditionelle Programmiermethoden zu verwenden, um diese Probleme zu lösen:
- Gesichtserkennung: Würde das Schreiben unzähliger Regeln erfordern, um verschiedene Veränderungen in Gesichtern zu beschreiben (Winkel, Beleuchtung, Ausdruck usw.)
- Sprachübersetzung: Würde das Zusammenstellen riesiger Wörterbücher und Grammatikregeln für jedes Sprachpaar erfordern
- Empfehlungssysteme: Würde die manuelle Analyse der Vorlieben jedes Benutzers und der Merkmale jedes Produkts erfordern
Maschinelles Lernen ermöglicht es Computern, diese komplexen Muster automatisch aus großen Datenmengen zu lernen, was den Prozess der Problemlösung erheblich vereinfacht.
Computer-Vision-Anwendungen
Gesichtserkennung
Anwendungsszenarien: Telefonentsperrung, Zutrittskontrollsysteme, Identitätsverifizierung
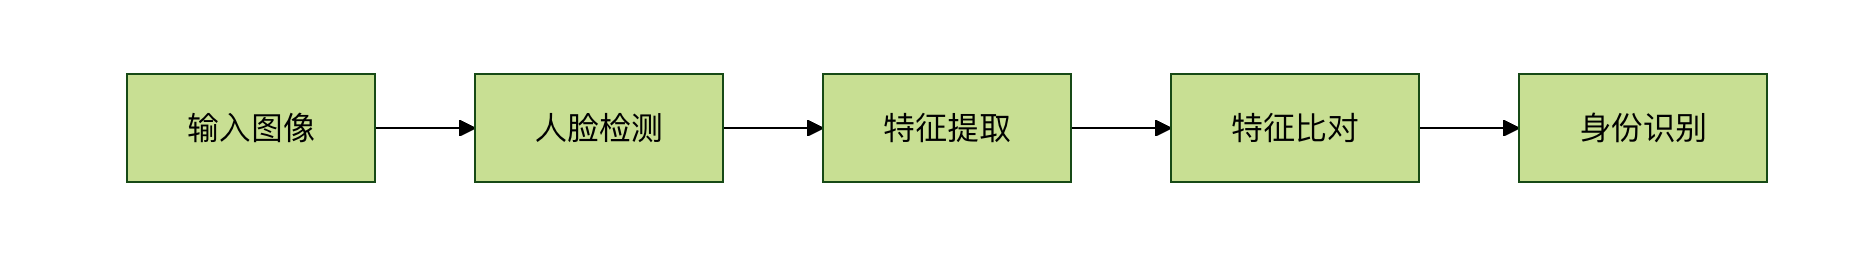
Funktionsweise:
- Gesichtspositionen in Bildern erkennen
- Gesichtsmerkmale extrahieren (Augenabstand, Nasenform usw.)
- Mit Gesichtsmerkmalen in der Datenbank vergleichen
Autonomes Fahren
Anwendungsszenarien: Tesla Autopilot, Baidu Apollo, Google Waymo
Kernaufgaben:
- Objekterkennung: Fahrzeuge, Fußgänger, Verkehrszeichen identifizieren
- Spurerkennung: Fahrspurgrenzen bestimmen
- Pfadplanung: Fahrtrouten festlegen
Beispiele
import cv2
import numpy as np
def detect_objects(image):
"""
Objekte in Bildern erkennen (Fahrzeuge, Fußgänger, Verkehrszeichen usw.)
"""
# 1. Das Bild vorverarbeiten
processed_image = preprocess_image(image)
# 2. Ein trainiertes Deep-Learning-Modell verwenden, um Objekte zu erkennen
# Hier wird beispielhaft ein vortrainiertes YOLO-Modell verwendet
boxes, classes, scores = yolo_model.detect(processed_image)
# 3. Erkennungsergebnisse mit geringer Konfidenz herausfiltern
valid_detections = filter_detections(boxes, classes, scores)
# 4. Erkennungsergebnisse auf dem Bild einzeichnen
result_image = draw_detections(image, valid_detections)
return result_image, valid_detections
# In der Praxis ist dies nur eine Komponente des gesamten autonomen Fahrsystems
# Außerdem muss es mehrere Module wie Sensorfusion und Pfadplanung integrieren
Medizinische Bilddiagnose
Anwendungsszenarien: Röntgenanalyse, CT-Scans, pathologische Objektträgeranalyse
Vorteile:
- Geringere Ermüdung als menschliche Ärzte
- Kann subtile Veränderungen erkennen, die für das menschliche Auge schwer wahrzunehmen sind
- Kann große Mengen von Bildern schnell verarbeiten
Anwendungen der natürlichen Sprachverarbeitung
Intelligente Assistenten
Anwendungsszenarien: Siri, Xiao Ai, Tmall Genie
Kernfunktionen:
- Spracherkennung: Sprache in Text umwandeln
- Absichtserkennung: Verstehen, was der Benutzer will
- Dialogmanagement: Kohärente Gespräche aufrechterhalten
Beispiele
import speech_recognition as sr
from textblob import TextBlob
class SmartAssistant:
def __init__(self):
self.recognizer = sr.Recognizer()
def listen_and_respond(self):
"""Auf die Sprache des Benutzers hören und antworten"""
with sr.Microphone() as source:
print("Höre zu...")
audio = self.recognizer.listen(source)
try:
# 1. Spracherkennung
text = self.recognizer.recognize_google(audio, language='zh-CN')
print(f"Benutzer sagte: {text}")
# 2. Absichtserkennung
intent = self.understand_intent(text)
# 3. Antwort generieren
response = self.generate_response(intent, text)
print(f"Antwort des Assistenten: {response}")
return response
except sr.UnknownValueError:
return "Entschuldigung, ich habe Sie nicht klar verstanden, bitte sagen Sie es noch einmal"
def understand_intent(self, text):
"""Benutzerabsicht verstehen"""
# Vereinfachte Absichtserkennung
if "weather" in text:
return "weather"
elif "time" in text:
return "time"
elif "joke" in text:
return "joke"
else:
return "unknown"
def generate_response(self, intent, text):
"""Antwort basierend auf der Absicht generieren"""
if intent == "weather":
return "Heute ist es sonnig, 25 Grad"
elif intent == "time":
from datetime import datetime
return f"Die aktuelle Uhrzeit ist {datetime.now().strftime('%H:%M')}"
elif intent == "joke":
return "Warum mögen Programmierer die Dunkelheit? Weil es dort keine Bugs gibt!"
else:
return "Entschuldigung, ich lerne noch und kann diese Frage nicht verstehen"
# Verwendungsbeispiel
assistant = SmartAssistant()
# assistant.listen_and_respond() # Kommentarzeichen entfernen, wenn tatsächlich ausgeführt
Maschinelle Übersetzung
Anwendungsszenarien: Google Translate, Baidu Translate, Youdao Translate
Funktionsweise:
- Quellsprachtext in numerische Repräsentationen kodieren
- Zuordnungsbeziehungen zwischen Sprachen durch neuronale Netze erlernen
- In Zielsprachentext dekodieren
Stimmungsanalyse
Anwendungsszenarien: Analyse von Produktbewertungen, Social-Media-Monitoring, Verarbeitung von Kundenfeedback
Beispiele
from textblob import TextBlob
import jieba
def analyze_sentiment_chinese(text):
"""
Beispiel für chinesische Sentimentanalyse
"""
# Verwendung von jieba zur Wortsegmentierung
words = jieba.cut(text)
word_list = " ".join(words)
# Hier vereinfacht; echte Anwendungen erfordern dedizierte chinesische Sentimentanalyse-Modelle
# Es können Bibliotheken wie SnowNLP, BERT-Chinese usw. verwendet werden.
# Sentimentanalyse-Ergebnisse simulieren
positive_words = ["good", "great", "like", "zufrieden", "empfehlen"]
negative_words = ["mies", "schlecht", "hassen", "enttäuscht", "nicht empfohlen"]
pos_count = sum(1 for word in positive_words if word in text)
neg_count = sum(1 for word in negative_words if word in text)
if pos_count > neg_count:
return "positives Sentiment"
elif neg_count > pos_count:
return "negatives Sentiment"
else:
return "neutrales Sentiment"
# Testbeispiele
reviews = [
"Dieses Produkt ist wirklich großartig, ich mag es wirklich sehr!",
"Die Qualität ist zu schlecht, es lohnt sich überhaupt nicht, es zu kaufen.",
"Es ist okay, nichts Besonderes."
]
for review in reviews:
sentiment = analyze_sentiment_chinese(review)
print(f"Bewertung: {review}")
print(f"Stimmung: {sentiment}")
print("---")
Anwendungen von Empfehlungssystemen
E-Commerce-Empfehlungen
Anwendungsszenarien: Taobao-Produktempfehlungen, Amazon-Empfehlungen
Empfehlungsstrategien:
- Kollaboratives Filtern: Empfehlung basierend auf der Ähnlichkeit des Nutzerverhaltens
- Inhaltsbasierte Empfehlung: Empfehlung basierend auf der Ähnlichkeit der Produktmerkmale
- Hybride Empfehlung: Mehrere Strategien kombinieren
Beispiele
import numpy as np
# Nutzer-Item-Bewertungsmatrix (Zeilen sind Nutzer, Spalten sind Items)
ratings = np.array([
[5, 3, 0, 1], # Bewertungen von Nutzer 1 für Items 1, 2, 4
[4, 0, 0, 1], # Bewertungen von Nutzer 2 für Items 1, 4
[1, 1, 0, 5], # Bewertungen von Nutzer 3 für Items 1, 2, 4
[1, 0, 0, 4], # Bewertungen von Nutzer 4 für Items 1, 4
[0, 1, 5, 4], # Bewertungen von Nutzer 5 für Items 2, 3, 4
])
def user_similarity(user1, user2):
"""Berechnet die Ähnlichkeit zwischen zwei Benutzern (Kosinusähnlichkeit)"""
# Elemente finden, die beide Benutzer bewertet haben
common_items = np.where((user1 > 0) & (user2 > 0))[0]
if len(common_items) == 0:
return 0
# Kosinusähnlichkeit berechnen
user1_ratings = user1[common_items]
user2_ratings = user2[common_items]
dot_product = np.dot(user1_ratings, user2_ratings)
norm1 = np.linalg.norm(user1_ratings)
norm2 = np.linalg.norm(user2_ratings)
if norm1 == 0 or norm2 == 0:
return 0
return dot_product / (norm1 * norm2)
def recommend_items(user_id, ratings_matrix, k=2):
"""Empfiehlt Elemente für einen angegebenen Benutzer"""
user_ratings = ratings_matrix[user_id]
# Berechne Ähnlichkeiten zwischen diesem Benutzer und anderen Benutzern
similarities = []
for i, other_user in enumerate(ratings_matrix):
if i != user_id:
sim = user_similarity(user_ratings, other_user)
similarities.append((i, sim))
# Sortiere nach Ähnlichkeit
similarities.sort(key=lambda x: x[1], reverse=True)
# Finde Elemente, die vom Benutzer nicht bewertet wurden
unrated_items = np.where(user_ratings == 0)[0]
# Vorhersage der Bewertungen des Benutzers für nicht bewertete Elemente
predictions = []
for item_id in unrated_items:
weighted_sum = 0
similarity_sum = 0
for similar_user_id, similarity in similarities[:k]:
if similarity > 0 and ratings_matrix[similar_user_id][item_id] > 0:
weighted_sum += similarity * ratings_matrix[similar_user_id][item_id]
similarity_sum += similarity
if similarity_sum > 0:
predicted_rating = weighted_sum / similarity_sum
predictions.append((item_id, predicted_rating))
# Sortieren nach vorhergesagter Bewertung
predictions.sort(key=lambda x: x[1], reverse=True)
return predictions[:3] # Gib die Top-3-Empfehlungen zurück
# Empfehle Elemente für Benutzer 0
user_id = 0
recommendations = recommend_items(user_id, ratings)
print(f"Empfohlene Elemente für Benutzer {user_id}:")
for item_id, predicted_rating in recommendations:
print(f"Element {item_id + 1}, vorhergesagte Bewertung: {predicted_rating:.2f}")
Video-Empfehlungen
Anwendungsszenarien: Douyin, YouTube, Netflix
Funktionen:
- Echtzeit-Empfehlung (angepasst an das aktuelle Verhalten des Benutzers)
- Multimodale Daten (Videoinhalte, Nutzerverhalten, Zeit, usw.)
- Umgang mit dem Cold-Start-Problem
Anwendungen für Predictive Analytics
Finanzrisikokontrolle
Anwendungsszenarien: Kreditkartenbetrugserkennung, Kreditgenehmigung
Beispiele
import numpy as np
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
# Transaktionsdaten simulieren
# Merkmale: Transaktionsbetrag, Transaktionszeit, Händlertyp, Standort usw.
# Labels: 0=normal, 1=Betrug
np.random.seed(42)
# Simulierte Daten generieren
n_samples = 1000
n_features = 4
# Normale Transaktionen
normal_transactions = np.random.normal(loc=[100, 14, 2, 3], scale=[50, 4, 1, 1],
size=(int(n_samples * 0.95), n_features))
# Betrügerische Transaktionen (normalerweise ungewöhnliche Beträge, ungewöhnliche Zeiten usw.)
fraud_transactions = np.random.normal(loc=[500, 3, 4, 1], scale=[200, 2, 1, 0.5],
size=(int(n_samples * 0.05), n_features))
# Daten zusammenführen und Labels hinzufügen
X = np.vstack([normal_transactions, fraud_transactions])
y = np.hstack([np.zeros(len(normal_transactions)), np.ones(len(fraud_transactions))])
# Trainings- und Testsets aufteilen
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Random-Forest-Modell trainieren
model = RandomForestClassifier(n_estimators=100, random_state=42)
model.fit(X_train, y_train)
# Modell bewerten
accuracy = model.score(X_test, y_test)
print(f"Modellgenauigkeit: {accuracy:.2f}")
# Neue Transaktionen vorhersagen
new_transaction = np.array([[450, 2, 4, 1]]) # Abnormale Transaktion
fraud_probability = model.predict_proba(new_transaction)[0][1]
print(f"Wahrscheinlichkeit, dass die neue Transaktion Betrug ist: {fraud_probability:.2f}")
if fraud_probability > 0.5:
print("Warnung: Verdächtige Transaktion erkannt!")
else:
print("Transaktion ist normal.")
Aktienkursvorhersage
Anwendungsszenarien: Quantitativer Handel, Investitionsentscheidungen
Herausforderungen:
- Hohes Marktrauschen
- Nichtstationäre Zeitreihen
- Von mehreren Faktoren beeinflusst
Anwendungen zur Anomalieerkennung
Cybersicherheit
Anwendungsszenarien: Eindringungserkennung, Malware-Identifizierung
Funktionsweise:
- Normale Netzwerkverkehrsmuster lernen
- Verhaltensweisen erkennen, die von normalen Mustern abweichen
- Alarme auslösen oder blockieren
Industrielle Qualitätsprüfung
Anwendungsszenarien: Erkennung von Produktfehlern, Vorhersage von Geräteausfällen
Beispiele
import numpy as np
from sklearn.ensemble import IsolationForest
import matplotlib.pyplot as plt
# Sensordaten simulieren (normale Daten + einige Anomalien)
np.random.seed(42)
# Normale Daten: Sensorwerte, wenn das Gerät normal arbeitet
normal_data = np.random.normal(loc=10, scale=1, size=(200, 2))
# Anomale Daten: Sensorwerte, wenn das Gerät ausfällt
anomaly_data = np.random.normal(loc=[15, 5], scale=[1, 1], size=(10, 2))
# Daten zusammenführen
all_data = np.vstack([normal_data, anomaly_data])
# Isolation Forest zur Anomalieerkennung verwenden
model = IsolationForest(contamination=0.05, random_state=42)
predictions = model.fit_predict(all_data)
# Ergebnisse visualisieren
plt.figure(figsize=(10, 6))
normal_points = all_data[predictions == 1]
anomaly_points = all_data[predictions == -1]
plt.scatter(normal_points[:, 0], normal_points[:, 1],
c='blue', label='Normale Daten')
plt.scatter(anomaly_points[:, 0], anomaly_points[:, 1],
c='red', label='Anomale Daten')
plt.xlabel('Sensor-1-Messwert')
plt.ylabel('Sensor-2-Messwert')
plt.title('Anomalieerkennung des Gerätebetriebszustands')
plt.legend()
plt.grid(True)
plt.show()
print(f"Erkannte {len(anomaly_points)} Anomaliepunkte")