В следующей таблице показан процент снижения энергопотребления, достижимый на различных уровнях цифрового проектирования. После уровня RTL величина снижения энергопотребления уже очень ограничена.
| Уровень проектирования | Степень улучшения |
|---|---|
| Системный уровень | 50% ~ 90% |
| Уровень RTL | 20% ~ 50% |
| Вентильный уровень | 10% ~ 15% |
| Транзисторный уровень | 5% ~ 10% |
| Топологический уровень | < 5% |
Как псевдопрограммист, пишущий на Verilog, можно участвовать в некоторой работе по снижению энергопотребления на системном уровне, но основное внимание следует уделять снижению энергопотребления на уровне RTL.
Далее материал разделён на 2 раздела, в которых представлены распространённые методы снижения энергопотребления на уровне RTL.
Параллелизм и конвейеризация
Функциональный модуль можно реализовать параллельным или конвейерным способом. Оба метода жертвуют ресурсами ради скорости. Гибкое применение этих двух методов в определённых ситуациях позволяет снизить энергопотребление.
Параллельная обработка
Параллельная обработка позволяет одновременно обрабатывать несколько исполняемых операторов, что повышает эффективность выполнения. Поэтому при условиях, удовлетворяющих требованиям работы, применение параллельной обработки позволяет снизить рабочую частоту системы и уменьшить энергопотребление.
Например, описания кода для реализации 4 операций умножения с накоплением данных с использованием 1 умножителя и 2 умножителей (параллельно) выглядят следующим образом:
Пример
//1 умножитель, высокая скорость
module mul1_hs
(
input clk , //200MHz
input rstn ,
input en ,
input [3:0] mul1 , //входные данные
input [3:0] mul2 , //входные данные
output dout_en ,
output [8:0] dout
);
reg flag ;
reg en_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
flag <= 1'b0 ;
en_r <= 1'b0 ;
end
else if (en) begin
flag <= ~flag ;
en_r <= 1'b1 ;
end
else begin
flag <= 1'b0 ;
en_r <= 1'b0 ;
end
end
wire [7:0] result = mul1 * mul2 ;
// разрешение вывода данных
reg [7:0] res1_r, res2_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
res1_r <= 'b0 ;
res2_r <= 'b0 ;
end
else if (en & !flag) begin
res1_r <= result ;
end
else if (en & flag) begin
res2_r <= result ;
end
end
assign dout_en = en_r & !flag ;
assign dout = res1_r + res2_r ;
endmodule
//===========================================
// 2 multiplier2, низкая скорость
module mul2_ls
(
input clk , //100MHz
input rstn ,
input en ,
input [3:0] mul1 , //входные данные
input [3:0] mul2 , //входные данные
input [3:0] mul3 , //входные данные
input [3:0] mul4 , //входные данные
output dout_en,
output [8:0] dout
);
wire [7:0] result1 = mul1 * mul2 ;
wire [7:0] result2 = mul3 * mul4 ;
//задержка en
reg en_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
en_r <= 1'b0 ;
end
else begin
en_r <= en ;
end
end
// разрешение вывода данных
reg [7:0] res1_r, res2_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
res1_r <= 'b0 ;
res2_r <= 'b0 ;
end
else if (en) begin
res1_r <= result1 ;
res2_r <= result2 ;
end
end
assign dout = res1_r + res2_r ;
assign dout_en = en_r ;
endmodule
Тестовый стенд описывается следующим образом.
Пример
module test ;
reg rstn ;
//mul1_hs
reg hs_clk;
reg hs_en ;
reg [3:0] hs_mul1 ;
reg [3:0] hs_mul2 ;
wire hs_dout_en ;
wire [8:0] hs_dout ;
//mul1_ls
reg ls_clk = 0;
reg ls_en ;
reg [3:0] ls_mul1 ;
reg [3:0] ls_mul2 ;
reg [3:0] ls_mul3 ;
reg [3:0] ls_mul4 ;
wire ls_dout_en ;
wire [8:0] ls_dout ;
//генерация тактового сигнала
real CYCLE_200MHz = 5 ; //
always begin
hs_clk = 0 ; #(CYCLE_200MHz/2) ;
hs_clk = 1 ; #(CYCLE_200MHz/2) ;
end
always begin
@(posedge hs_clk) ls_clk = ~ls_clk ;
end
//генерация сброса
initial begin
rstn = 1'b0 ;
#8 rstn = 1'b1 ;
end
//мотивация
initial begin
hs_mul1 = 0 ;
hs_mul2 = 16 ;
hs_en = 0 ;
#103 ;
repeat(12) begin
@(negedge hs_clk) ;
hs_en = 1 ;
hs_mul1 = hs_mul1 + 1;
hs_mul2 = hs_mul2 - 1;
end
hs_en = 0 ;
end
initial begin
ls_mul1 = 1 ;
ls_mul2 = 15 ;
ls_mul3 = 2 ;
ls_mul4 = 14 ;
ls_en = 0 ;
#103 ;
@(negedge ls_clk) ls_en = 1;
repeat(5) begin
@(negedge ls_clk) ;
ls_mul1 = ls_mul1 + 2;
ls_mul2 = ls_mul2 - 2;
ls_mul3 = ls_mul3 + 2;
ls_mul4 = ls_mul4 - 2;
end
ls_en = 0 ;
end
//создание экземпляра модуля
mul1_hs u_mul1_hs
(
.clk (hs_clk),
.rstn (rstn),
.en (hs_en),
.mul1 (hs_mul1),
.mul2 (hs_mul2),
.dout (hs_dout),
.dout_en (hs_dout_en)
);
mul2_ls u_mul2_ls
(
.clk (ls_clk),
.rstn (rstn),
.en (ls_en),
.mul1 (ls_mul1),
.mul2 (ls_mul2),
.mul3 (ls_mul3),
.mul4 (ls_mul4),
.dout (ls_dout),
.dout_en (ls_dout_en)
);
//завершение моделирования
always begin
#100;
if ($time >= 1000) begin
#1 ;
$finish ;
end
end
endmodule
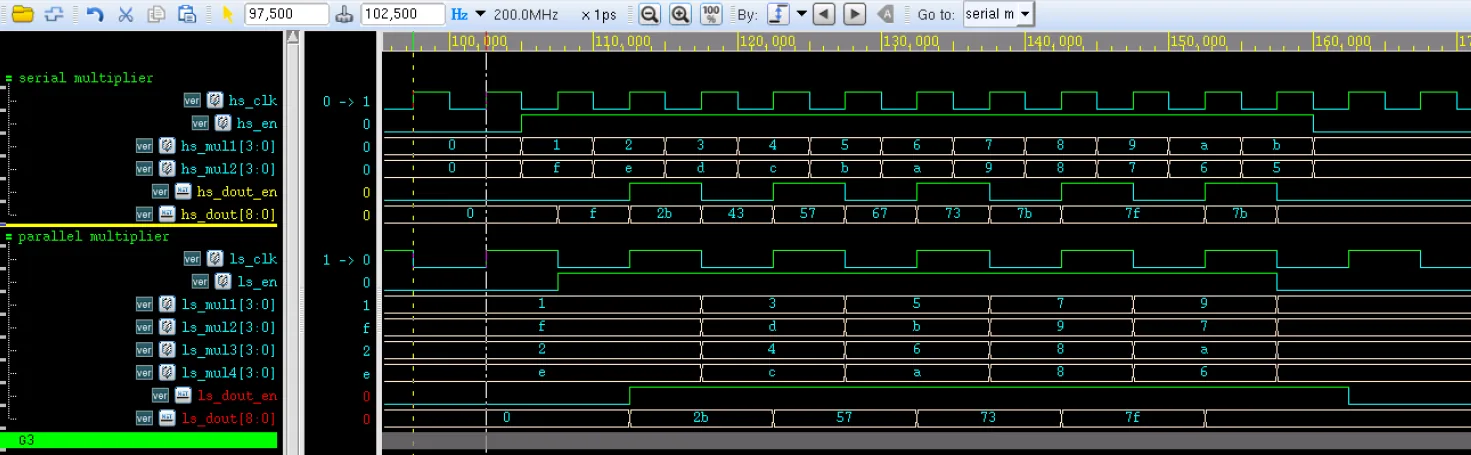
Результаты моделирования следующие.
Из рисунка видно, что два способа реализации дают одинаковые выходные результаты, но способ параллельной обработки уменьшает рабочую частоту вдвое, поэтому энергопотребление снизится, а площадь проектирования также увеличится.
Конвейеризация
В"Verilog Tutorial"было описано, что непрерывно работающий N-ступенчатый конвейерный дизайн повышает эффективность примерно в N раз. Как и при параллельном проектировании, при использовании конвейерного проектирования рабочую частоту также можно соответствующим образом снизить для уменьшения энергопотребления.
С другой стороны, конвейерное проектирование может разделить длинный комбинационный путь на N ступеней конвейера. Длина пути сокращается до 1/N от исходной длины пути. В этом случае, если тактовая частота остаётся неизменной, за один цикл требуется заряжать и разряжать только ёмкость C/N, а не исходную ёмкость C. Поэтому при том же требовании к частоте для управления системой можно использовать более низкое напряжение питания, что снижает энергопотребление.
Предположим, в некоторой схеме критический путь — это 32-битный умножитель 32 на 32. Общая ёмкость этого умножителя равна C, а рабочее напряжение — V.
Без конвейеризации для достижения этой рабочей частоты рабочее напряжение должно быть V.
При использовании двухступенчатого конвейера путь делится на две части. Для каждой части общая ёмкость становится C/2. Чтобы достичь исходной рабочей частоты, рабочее напряжение можно снизить до βV (β<1). Энергопотребление всей системы снижается до β^2 от исходного.
Что касается конкретных методов проектирования конвейера, см."Verilog Tutorial"в главе"6.7 Verilog Pipeline"секцию.
Совместное использование ресурсов и кодирование состояний
Совместное использование ресурсов
Когда в проекте в нескольких местах используется одна и та же логика операций, можно применить совместное использование ресурсов, чтобы избежать дублирования нескольких блоков логики операций и снизить потребление ресурсов.
Например, для логики сравнения описание кода без совместного использования ресурсов выглядит следующим образом:
Пример
case (mode) :
3'b000: result = 1'b1 ;
3'b001: result = 1'b0 ;
3'b010: result = value1 == value2 ;
3'b011: result = value1 != value2 ;
3'b100: result = value1 > value2 ;
3'b101: result = value1 < value2 ;
3'b110: result = value1 >= value2 ;
3'b111: result = value1 <= value2 ;
endcase
end
Приведённый выше код оптимизирован и описан следующим образом:
wire equal_con = value1 == value2 ;
wire great_con = value1 > value2 ;
always @(*) begin
case (mode) :
3'b000: result = 1'b1 ;
3'b001: result = 1'b0 ;
3'b010: result = equal_con ;
3'b011: result = equal_con ;
3'b100: result = great_con ;
3'b101: result = !great_con && !equal_con ;
3'b110: result = great_con && equal_con ;
3'b111: result = !great_con ;
endcase
end
При синтезе первого метода, если оптимизация компилятора выполнена недостаточно хорошо, может потребоваться 6 компараторов. Второй метод совместного использования ресурсов требует только 2 компаратора, чтобы реализовать ту же логическую функцию, тем самым в определённой степени снижая энергопотребление.
Кодирование состояний
Для некоторых часто изменяющихся сигналов частота переключений относительно высока, и энергопотребление относительно велико. Кодирование состояний можно использовать для уменьшения активности переключений и снижения энергопотребления.
Например, при работе высокоскоростного счётчика использование кода Грея вместо двоичного кодирования приводит к переключению только 1 бита данных в любой момент времени, что снижает частоту переключений и тем самым уменьшает энергопотребление.
Например, при проектировании конечного автомата, если кодирование состояний до и после перехода состояния отличается только на 1 бит, частота переключений также снижается.
Изоляция операндов
Принцип изоляции операндов: если выход тракта данных бесполезен в течение определенного периода времени, установка входа в фиксированное значение предотвращает переключения в тракте данных, тем самым снижая энергопотребление.
Схема умножителя показана ниже.
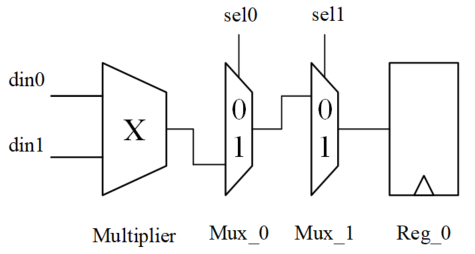
Когда sel0 = 0 или sel1 = 1, выход умножителя не может достичь входа регистра через два мультиплексора. То есть регистр не может сохранить текущий результат умножения, поэтому эта операция умножения не нужна. В таких условиях можно использовать изоляцию операндов, чтобы поддерживать умножитель неактивным и статичным, что также экономит энергию.
Оптимизация вышеприведенной схемы показана на следующем рисунке.
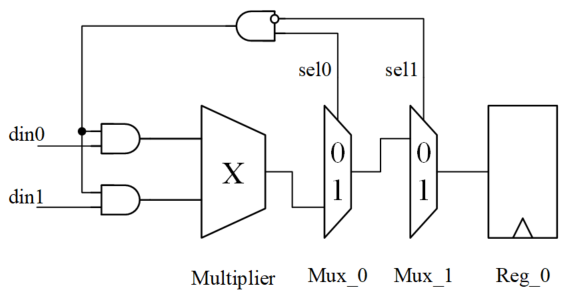
После изоляции операндов, когда sel0 = 0 или sel1 = 1, вход умножителя всегда равен 0, переключение сигналов не происходит, и умножитель не выполняет лишнюю недействительную работу, поэтому энергопотребление снижается.
Вообще говоря, изоляция операндов происходит во время логического синтеза. Этот процесс часто настраивается вручную и может автоматически распознаваться компилятором. Конечно, хороший стиль кодирования, который тщательно учитывает эти аспекты при написании RTL-схем, больше способствует реализации изоляции операндов и, следовательно, снижению энергопотребления.
Когда в умножителе не используется изоляция операндов, описание кода на Verilog выглядит следующим образом:
Пример
module oper_isolation1
(
input clk , //100MHz
input [1:0] sel ,
input [3:0] din1 , //входные данные
input [3:0] din2 , //входные данные
output reg [7:0] dout
);
reg [7:0] res ;
always @(*) begin
res = din1 * din2 ;
end
always @(posedge clk) begin
if (sel == 2'b01) begin
dout <= res ;
end
end
endmodule
Когда в умножителе используется изоляция операндов, описание кода на Verilog выглядит следующим образом:
Пример
module oper_isolation2
(
input clk , //100MHz
input [1:0] sel ,
input [3:0] din1 , //входные данные
input [3:0] din2 , //входные данные
output reg [7:0] dout
);
wire [3:0] mul1 = sel == 2'b01 ? din1 : 0 ;
wire [3:0] mul2 = sel == 2'b01 ? din2 : 0 ;
reg [7:0] res ;
always @(*) begin
res = mul1 * mul2 ;
end
always @(posedge clk) begin
if (sel == 2'b01) begin
dout <= res ;
end
end
endmodule
Скачать исходный код для этой главы
Скачать