次の表は、デジタル設計の各レベルで削減できる消費電力の割合を示しています。RTL レベル以降では、消費電力の削減量はすでに非常に限られています。
| 設計レベル | 改善度 |
|---|---|
| システムレベル | 50% ~ 90% |
| RTL レベル | 20% ~ 50% |
| ゲートレベル | 10% ~ 15% |
| トランジスタレベル | 5% ~ 10% |
| レイアウトレベル | < 5% |
Verilog を書く自称プログラマとして、システムレベルの消費電力削減の作業にもある程度参加できますが、重点は RTL レベルでの消費電力削減に置くべきです。
以下、2つの節に分けて、RTLレベルで消費電力を削減するための一般的な方法を紹介します。
並列処理とパイプライン
ある機能モジュールは、並列方式でもパイプライン方式でも実装できます。これらの2つの方法はどちらもリソースを消費して速度を得るものです。状況に応じてこの2つの方法を柔軟に使用することで、消費電力を削減できます。
並列処理
並列処理では、複数の実行文を同時に処理できるため、実行効率が高くなります。したがって、動作要件を満たす条件下では、並列処理を採用することでシステムの動作周波数を下げ、消費電力を削減できます。
例えば、1つの乗算器と2つの乗算器(並列)を使用して4つのデータの乗算加算演算を実装するコード記述は、それぞれ以下のようになります。
例
//1 multiplier, high speed
module mul1_hs
(
input clk , //200MHz
input rstn ,
input en ,
input [3:0] mul1 , //data in
input [3:0] mul2 , //data in
output dout_en ,
output [8:0] dout
);
reg flag ;
reg en_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
flag <= 1'b0 ;
en_r <= 1'b0 ;
end
else if (en) begin
flag <= ~flag ;
en_r <= 1'b1 ;
end
else begin
flag <= 1'b0 ;
en_r <= 1'b0 ;
end
end
wire [7:0] result = mul1 * mul2 ;
// data output en
reg [7:0] res1_r, res2_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
res1_r <= 'b0 ;
res2_r <= 'b0 ;
end
else if (en & !flag) begin
res1_r <= result ;
end
else if (en & flag) begin
res2_r <= result ;
end
end
assign dout_en = en_r & !flag ;
assign dout = res1_r + res2_r ;
endmodule
//===========================================
// 2 multiplier2, low speed
module mul2_ls
(
input clk , //100MHz
input rstn ,
input en ,
input [3:0] mul1 , //data in
input [3:0] mul2 , //data in
input [3:0] mul3 , //data in
input [3:0] mul4 , //data in
output dout_en,
output [8:0] dout
);
wire [7:0] result1 = mul1 * mul2 ;
wire [7:0] result2 = mul3 * mul4 ;
//en delay
reg en_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
en_r <= 1'b0 ;
end
else begin
en_r <= en ;
end
end
// data output en
reg [7:0] res1_r, res2_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
res1_r <= 'b0 ;
res2_r <= 'b0 ;
end
else if (en) begin
res1_r <= result1 ;
res2_r <= result2 ;
end
end
assign dout = res1_r + res2_r ;
assign dout_en = en_r ;
endmodule
testbench の記述は以下のとおりです。
例
module test ;
reg rstn ;
//mul1_hs
reg hs_clk;
reg hs_en ;
reg [3:0] hs_mul1 ;
reg [3:0] hs_mul2 ;
wire hs_dout_en ;
wire [8:0] hs_dout ;
//mul1_ls
reg ls_clk = 0;
reg ls_en ;
reg [3:0] ls_mul1 ;
reg [3:0] ls_mul2 ;
reg [3:0] ls_mul3 ;
reg [3:0] ls_mul4 ;
wire ls_dout_en ;
wire [8:0] ls_dout ;
//clock generating
real CYCLE_200MHz = 5 ; //
always begin
hs_clk = 0 ; #(CYCLE_200MHz/2) ;
hs_clk = 1 ; #(CYCLE_200MHz/2) ;
end
always begin
@(posedge hs_clk) ls_clk = ~ls_clk ;
end
//reset generating
initial begin
rstn = 1'b0 ;
#8 rstn = 1'b1 ;
end
//motivation
initial begin
hs_mul1 = 0 ;
hs_mul2 = 16 ;
hs_en = 0 ;
#103 ;
repeat(12) begin
@(negedge hs_clk) ;
hs_en = 1 ;
hs_mul1 = hs_mul1 + 1;
hs_mul2 = hs_mul2 - 1;
end
hs_en = 0 ;
end
initial begin
ls_mul1 = 1 ;
ls_mul2 = 15 ;
ls_mul3 = 2 ;
ls_mul4 = 14 ;
ls_en = 0 ;
#103 ;
@(negedge ls_clk) ls_en = 1;
repeat(5) begin
@(negedge ls_clk) ;
ls_mul1 = ls_mul1 + 2;
ls_mul2 = ls_mul2 - 2;
ls_mul3 = ls_mul3 + 2;
ls_mul4 = ls_mul4 - 2;
end
ls_en = 0 ;
end
//module instantiation
mul1_hs u_mul1_hs
(
.clk (hs_clk),
.rstn (rstn),
.en (hs_en),
.mul1 (hs_mul1),
.mul2 (hs_mul2),
.dout (hs_dout),
.dout_en (hs_dout_en)
);
mul2_ls u_mul2_ls
(
.clk (ls_clk),
.rstn (rstn),
.en (ls_en),
.mul1 (ls_mul1),
.mul2 (ls_mul2),
.mul3 (ls_mul3),
.mul4 (ls_mul4),
.dout (ls_dout),
.dout_en (ls_dout_en)
);
//simulation finish
always begin
#100;
if ($time >= 1000) begin
#1 ;
$finish ;
end
end
endmodule
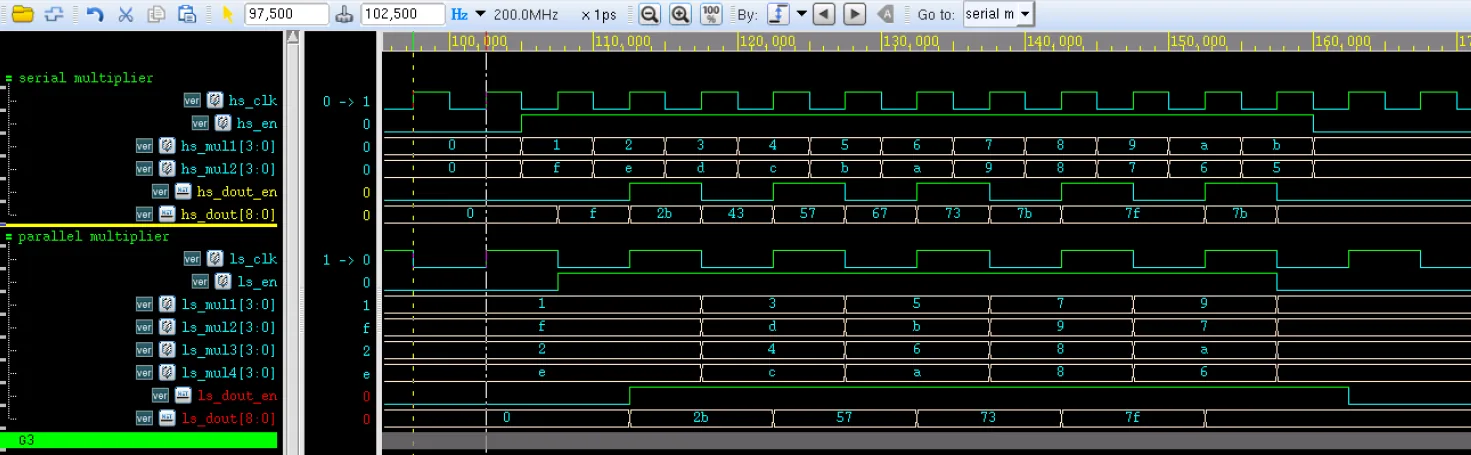
シミュレーション結果は以下のとおりです。
図からわかるように、2つの実装方法の出力結果は一致しますが、並列処理方式では動作周波数が半分になり、消費電力が低減されるとともに、設計面積も増加します。
パイプライン処理
に『Verilog 教程』で述べたように、連続して動作するN段パイプライン設計では、効率が約N倍に向上します。並列設計と同様に、パイプライン設計を採用する場合も、動作周波数を適切に下げて消費電力を削減できます。
別の観点から見ると、パイプライン設計では、長い組み合わせ論理パスをN段のパイプラインに分割できます。パスの長さは元のパス長の1/Nになります。このとき、クロック周波数が変わらなければ、1サイクル内で、元の容量Cを充放電する代わりに、容量C/Nだけを充放電すればよくなります。そのため、同じ周波数要件の下では、より低い電源電圧でシステムを駆動でき、消費電力を削減できます。
ある設計において、クリティカルパスが32bit×32bitの乗算器であると仮定します。この乗算器の全体の容量はC、動作電圧はVです。
パイプラインを追加しない場合、この動作周波数を達成するには、動作電圧はVでなければなりません。
2段パイプライン方式を採用すると、このパスは2つの部分に分割されます。各部分では、全体の容量がC/2になります。元の動作周波数を達成する場合、動作電圧をβV(β<1)に下げることができます。システム全体の消費電力は元のβ^2になります。
パイプラインの具体的な設計方法は、『Verilog 教程』の章の『6.7 Verilog パイプライン』の節を参照してください。
リソース共有と状態エンコーディング
リソース共有
設計内で同じ演算ロジックが複数の場所で使用される場合、リソース共有の方法を使用することで、複数の演算ロジックの重複を避け、リソースの消費を削減できます。
例えば、比較ロジックについて、リソース共有を使用しない場合のコード記述は以下のとおりです。
例
case (mode) :
3'b000: result = 1'b1 ;
3'b001: result = 1'b0 ;
3'b010: result = value1 == value2 ;
3'b011: result = value1 != value2 ;
3'b100: result = value1 > value2 ;
3'b101: result = value1 < value2 ;
3'b110: result = value1 >= value2 ;
3'b111: result = value1 <= value2 ;
endcase
end
上記のコードを最適化した記述は以下のとおりです。
wire equal_con = value1 == value2 ;
wire great_con = value1 > value2 ;
always @(*) begin
case (mode) :
3'b000: result = 1'b1 ;
3'b001: result = 1'b0 ;
3'b010: result = equal_con ;
3'b011: result = equal_con ;
3'b100: result = great_con ;
3'b101: result = !great_con && !equal_con ;
3'b110: result = great_con && equal_con ;
3'b111: result = !great_con ;
endcase
end
1つ目の方法を論理合成で実装する際、コンパイラの最適化が不十分な場合、6つの比較器が必要になる可能性があります。2つ目のリソース共有の方法では、同じ論理機能を2つの比較器だけで実現できるため、ある程度消費電力を削減できます。
状態エンコーディング
頻繁に変化する信号では、トグル率が比較的高く、消費電力も比較的大きくなります。状態エンコーディングを利用してスイッチング活動を減らし、消費電力を削減できます。
例えば、高速カウンタが動作する際、バイナリ符号の代わりにグレイコードを使用すると、各時点で1bitのデータだけが反転するため、トグル率が下がり、消費電力も低下します。
例えば、ステートマシンを設計する際、状態遷移の前後で状態エンコーディングの差が1bitだけであると、トグル率も低減されます。
オペランド分離
オペランド分離の原理:ある期間、データパスの出力が不要な場合、入力を固定値に設定すると、データパス部分でトグルが発生せず、消費電力が低下します。
乗算器の回路図は以下のとおりです。
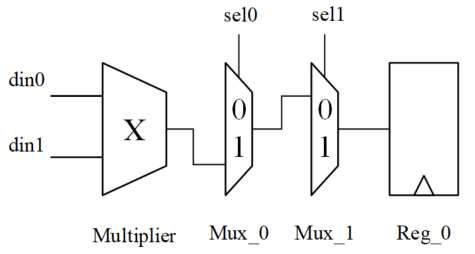
sel0 = 0 または sel1 = 1 の場合、乗算器 Multiplier の出力結果は2つのMuxを通過してレジスタの入力端に到達できません。つまり、レジスタは現在の乗算結果を保存できないため、この乗算演算は不要です。このような条件下では、オペランド分離を採用して乗算器を動作させず静的状態に保つことで、消費電力も節約できます。
上記の回路を最適化すると、以下の図のようになります。
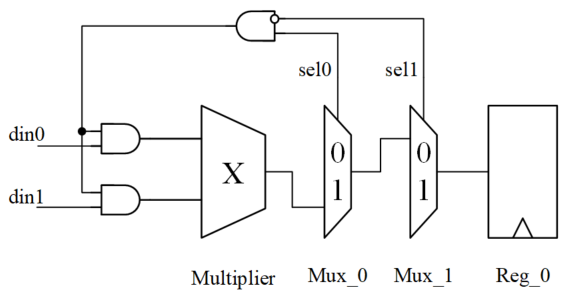
オペランド分離後、sel0 = 0 または sel1 = 1 の場合、乗算器の入力端は常に0になり、信号トグルが発生しません。乗算器は余分な無効動作を行わないため、消費電力が低下します。
一般に、オペランド分離の操作はコードの論理合成時に行われます。このプロセスは、多くの場合、人が設定でき、コンパイラが自動的に認識できます。もちろん、RTL回路を記述する際に十分考慮された優れたコードスタイルは、オペランド分離の実現をより助け、消費電力の削減につながります。
乗算器がオペランド分離を使用していない場合の Verilog コード記述は以下のとおりです。
例
module oper_isolation1
(
input clk , //100MHz
input [1:0] sel ,
input [3:0] din1 , //data in
input [3:0] din2 , //data in
output reg [7:0] dout
);
reg [7:0] res ;
always @(*) begin
res = din1 * din2 ;
end
always @(posedge clk) begin
if (sel == 2'b01) begin
dout <= res ;
end
end
endmodule
乗算器がオペランド分離を使用する場合の Verilog コード記述は以下のとおりです。
例
module oper_isolation2
(
input clk , //100MHz
input [1:0] sel ,
input [3:0] din1 , //data in
input [3:0] din2 , //data in
output reg [7:0] dout
);
wire [3:0] mul1 = sel == 2'b01 ? din1 : 0 ;
wire [3:0] mul2 = sel == 2'b01 ? din2 : 0 ;
reg [7:0] res ;
always @(*) begin
res = mul1 * mul2 ;
end
always @(posedge clk) begin
if (sel == 2'b01) begin
dout <= res ;
end
end
endmodule
本章のソースコードダウンロード
Download