Le tableau suivant montre le pourcentage de réduction de puissance réalisable à différents niveaux de conception numérique. Après le niveau RTL, la quantité de réduction de puissance est déjà très limitée.
| Niveau de conception | Degré d'amélioration |
|---|---|
| Niveau système | 50% ~ 90% |
| Niveau RTL | 20% ~ 50% |
| Niveau porte | 10% ~ 15% |
| Niveau transistor | 5% ~ 10% |
| Niveau layout | < 5% |
En tant que pseudo-codeur qui écrit du Verilog, on peut participer à certains travaux de réduction de puissance au niveau système, mais l'accent doit être mis sur la réduction de puissance au niveau RTL.
Ce qui suit est divisé en 2 sections pour présenter les méthodes courantes de réduction de la puissance au niveau RTL.
Parallélisme et pipeline
Pour un module fonctionnel, il peut être implémenté de manière parallèle ou de manière pipeline. Les deux méthodes échangent des ressources contre de la vitesse. Une utilisation flexible de ces deux méthodes dans certaines situations peut réduire la consommation d'énergie.
Traitement parallèle
Le traitement parallèle peut gérer plusieurs instructions d'exécution simultanément, ce qui rend l'exécution plus efficace. Par conséquent, dans des conditions qui répondent aux exigences de travail, l'adoption du traitement parallèle peut réduire la fréquence de fonctionnement du système et diminuer la consommation d'énergie.
Par exemple, les descriptions de code pour utiliser 1 multiplicateur et 2 multiplicateurs (parallèle) afin de mettre en œuvre 4 opérations de multiplication-accumulation de données sont les suivantes :
Exemple
//1 multiplicateur, haute vitesse
module mul1_hs
(
input clk , //200MHz
input rstn ,
input en ,
input [3:0] mul1 , //données en entrée
input [3:0] mul2 , //données en entrée
output dout_en ,
output [8:0] dout
);
reg flag ;
reg en_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
flag <= 1'b0 ;
en_r <= 1'b0 ;
end
else if (en) begin
flag <= ~flag ;
en_r <= 1'b1 ;
end
else begin
flag <= 1'b0 ;
en_r <= 1'b0 ;
end
end
wire [7:0] result = mul1 * mul2 ;
// activation de la sortie de données
reg [7:0] res1_r, res2_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
res1_r <= 'b0 ;
res2_r <= 'b0 ;
end
else if (en & !flag) begin
res1_r <= result ;
end
else if (en & flag) begin
res2_r <= result ;
end
end
assign dout_en = en_r & !flag ;
assign dout = res1_r + res2_r ;
endmodule
//===========================================
// 2 multiplier2, faible vitesse
module mul2_ls
(
input clk , //100MHz
input rstn ,
input en ,
input [3:0] mul1 , //données en entrée
input [3:0] mul2 , //données en entrée
input [3:0] mul3 , //données d'entrée
input [3:0] mul4 , //données d'entrée
output dout_en,
output [8:0] dout
);
wire [7:0] result1 = mul1 * mul2 ;
wire [7:0] result2 = mul3 * mul4 ;
//retard de en
reg en_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
en_r <= 1'b0 ;
end
else begin
en_r <= en ;
end
end
// activation de la sortie de données
reg [7:0] res1_r, res2_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
res1_r <= 'b0 ;
res2_r <= 'b0 ;
end
else if (en) begin
res1_r <= result1 ;
res2_r <= result2 ;
end
end
assign dout = res1_r + res2_r ;
assign dout_en = en_r ;
endmodule
Le banc de test est décrit comme suit.
Exemple
module test ;
reg rstn ;
//mul1_hs
reg hs_clk;
reg hs_en ;
reg [3:0] hs_mul1 ;
reg [3:0] hs_mul2 ;
wire hs_dout_en ;
wire [8:0] hs_dout ;
//mul1_ls
reg ls_clk = 0;
reg ls_en ;
reg [3:0] ls_mul1 ;
reg [3:0] ls_mul2 ;
reg [3:0] ls_mul3 ;
reg [3:0] ls_mul4 ;
wire ls_dout_en ;
wire [8:0] ls_dout ;
//génération d'horloge
real CYCLE_200MHz = 5 ; //
always begin
hs_clk = 0 ; #(CYCLE_200MHz/2) ;
hs_clk = 1 ; #(CYCLE_200MHz/2) ;
end
always begin
@(posedge hs_clk) ls_clk = ~ls_clk ;
end
//génération de reset
initial begin
rstn = 1'b0 ;
#8 rstn = 1'b1 ;
end
//motivation
initial begin
hs_mul1 = 0 ;
hs_mul2 = 16 ;
hs_en = 0 ;
#103 ;
repeat(12) begin
@(negedge hs_clk) ;
hs_en = 1 ;
hs_mul1 = hs_mul1 + 1;
hs_mul2 = hs_mul2 - 1;
end
hs_en = 0 ;
end
initial begin
ls_mul1 = 1 ;
ls_mul2 = 15 ;
ls_mul3 = 2 ;
ls_mul4 = 14 ;
ls_en = 0 ;
#103 ;
@(negedge ls_clk) ls_en = 1;
repeat(5) begin
@(negedge ls_clk) ;
ls_mul1 = ls_mul1 + 2;
ls_mul2 = ls_mul2 - 2;
ls_mul3 = ls_mul3 + 2;
ls_mul4 = ls_mul4 - 2;
end
ls_en = 0 ;
end
//instanciation de module
mul1_hs u_mul1_hs
(
.clk (hs_clk),
.rstn (rstn),
.en (hs_en),
.mul1 (hs_mul1),
.mul2 (hs_mul2),
.dout (hs_dout),
.dout_en (hs_dout_en)
);
mul2_ls u_mul2_ls
(
.clk (ls_clk),
.rstn (rstn),
.en (ls_en),
.mul1 (ls_mul1),
.mul2 (ls_mul2),
.mul3 (ls_mul3),
.mul4 (ls_mul4),
.dout (ls_dout),
.dout_en (ls_dout_en)
);
//fin de simulation
always begin
#100;
if ($time >= 1000) begin
#1 ;
$finish ;
end
end
endmodule
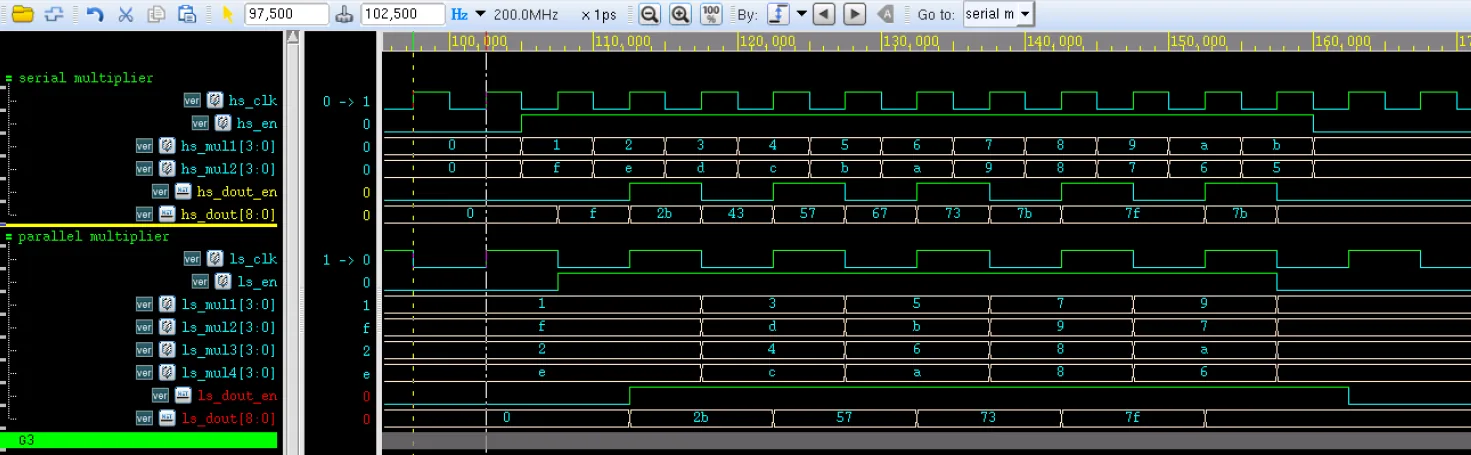
Les résultats de la simulation sont les suivants.
On peut voir sur la figure que les deux méthodes d'implémentation produisent les mêmes résultats de sortie, mais la méthode de traitement parallèle réduit de moitié la fréquence de fonctionnement, de sorte que la consommation d'énergie diminuera, tandis que la surface de conception augmentera également.
Pipeline
Dans"Verilog Tutorial"Il a été décrit qu'une conception de pipeline à N étages fonctionnant en continu améliore l'efficacité d'un facteur d'environ N. Comme dans la conception parallèle, lors de l'utilisation d'une conception pipeline, la fréquence de fonctionnement peut également être réduite de manière appropriée afin de diminuer la consommation d'énergie.
D'un autre point de vue, une conception pipeline peut diviser un long chemin combinatoire en N étages de pipeline. La longueur du chemin est réduite à 1/N de la longueur de chemin d'origine. À ce moment, si la fréquence d'horloge reste inchangée, pendant un cycle, seule la capacité C/N doit être chargée et déchargée, au lieu de la capacité d'origine C. Par conséquent, pour une même exigence de fréquence, une tension d'alimentation plus faible peut être utilisée pour piloter le système, ce qui réduit la consommation d'énergie.
Supposons que dans une conception, le chemin critique soit un multiplicateur 32 bits par 32 bits. La capacité globale de ce multiplicateur est C, et la tension de fonctionnement est V.
Sans pipeline, pour atteindre cette fréquence de fonctionnement, la tension de fonctionnement doit être V.
Lors de l'utilisation d'un pipeline à deux étages, le chemin est divisé en deux parties. Pour chaque partie, la capacité globale devient C/2. Pour atteindre la fréquence de fonctionnement d'origine, la tension de fonctionnement peut être réduite à βV (β<1). La consommation d'énergie de l'ensemble du système est réduite à β^2 de l'original.
Pour des méthodes spécifiques de conception de pipeline, veuillez vous référer à"Verilog Tutorial"dans le chapitre"6.7 Verilog Pipeline"section.
Partage de ressources et encodage d'états
Partage de ressources
Lorsqu'une même logique d'opération est utilisée à plusieurs endroits dans une conception, le partage de ressources peut être utilisé pour éviter la duplication de plusieurs blocs logiques d'opération et réduire la consommation de ressources.
Par exemple, pour une logique de comparaison, la description de code sans partage de ressources est la suivante :
Exemple
case (mode) :
3'b000: result = 1'b1 ;
3'b001: result = 1'b0 ;
3'b010: result = value1 == value2 ;
3'b011: result = value1 != value2 ;
3'b100: result = value1 > value2 ;
3'b101: result = value1 < value2 ;
3'b110: result = value1 >= value2 ;
3'b111: result = value1 <= value2 ;
endcase
end
Le code ci-dessus est optimisé et décrit comme suit :
wire equal_con = value1 == value2 ;
wire great_con = value1 > value2 ;
always @(*) begin
case (mode) :
3'b000: result = 1'b1 ;
3'b001: result = 1'b0 ;
3'b010: result = equal_con ;
3'b011: result = equal_con ;
3'b100: result = great_con ;
3'b101: result = !great_con && !equal_con ;
3'b110: result = great_con && equal_con ;
3'b111: result = !great_con ;
endcase
end
Lorsque la première méthode est synthétisée, si l’optimisation du compilateur n’est pas bien faite, 6 comparateurs peuvent être nécessaires. La seconde méthode de partage de ressources ne nécessite que 2 comparateurs pour réaliser la même fonction logique, réduisant ainsi la consommation d’énergie dans une certaine mesure.
Encodage des états
Pour certains signaux changeant fréquemment, le taux de basculement est relativement élevé et la consommation d’énergie est relativement importante. L’encodage des états peut être utilisé pour réduire l’activité de commutation et abaisser la consommation d’énergie.
Par exemple, lorsqu’un compteur haute vitesse fonctionne, l’utilisation du code Gray au lieu de l’encodage binaire ne fait basculer qu’un seul bit de données à tout moment, ce qui réduit le taux de basculement et abaisse ainsi la consommation d’énergie.
Par exemple, lors de la conception d’une machine d’état, si l’encodage des états avant et après une transition d’état ne diffère que de 1 bit, le taux de basculement sera également réduit.
Isolation des opérandes
Principe de l'isolation des opérandes : si la sortie d'un chemin de données est inutile pendant une certaine période, fixer l'entrée à une valeur fixe empêche les commutations dans le chemin de données, ce qui réduit la consommation d'énergie.
Un schéma du circuit multiplicateur est présenté ci-dessous.
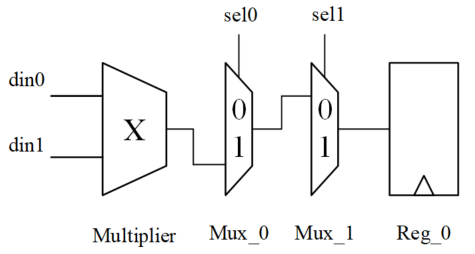
Lorsque sel0 = 0 ou sel1 = 1, la sortie du multiplicateur ne peut pas atteindre l'entrée du registre à travers les deux multiplexeurs. Autrement dit, le registre ne peut pas stocker le résultat actuel du multiplicateur, donc cette opération de multiplication est inutile. Dans de telles conditions, l'isolation des opérandes peut être utilisée pour maintenir le multiplicateur inactif et statique, ce qui permet aussi d'économiser de l'énergie.
Une optimisation du circuit ci-dessus est présentée dans la figure suivante.
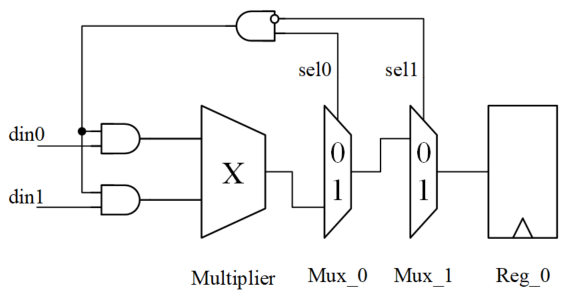
Après isolation des opérandes, lorsque sel0 = 0 ou sel1 = 1, l'entrée du multiplicateur est toujours 0, aucune commutation de signal ne se produit, et le multiplicateur n'effectue pas de travail supplémentaire inutile, de sorte que la consommation d'énergie est réduite.
De manière générale, l'isolation des opérandes a lieu lors de la synthèse logique. Ce processus est souvent configurable manuellement et peut être reconnu automatiquement par le compilateur. Bien entendu, un bon style de codage qui prend soigneusement en compte ces aspects lors de l'écriture de circuits RTL est plus propice à la mise en œuvre de l'isolation des opérandes et donc à la réduction de la consommation d'énergie.
Lorsque le multiplicateur n'utilise pas l'isolation des opérandes, la description du code Verilog est la suivante :
Exemple
module oper_isolation1
(
input clk , //100MHz
input [1:0] sel ,
input [3:0] din1 , //données en entrée
input [3:0] din2 , //données en entrée
output reg [7:0] dout
);
reg [7:0] res ;
always @(*) begin
res = din1 * din2 ;
end
always @(posedge clk) begin
if (sel == 2'b01) begin
dout <= res ;
end
end
endmodule
Lorsque le multiplicateur utilise l'isolation des opérandes, la description du code Verilog est la suivante :
Exemple
module oper_isolation2
(
input clk , //100MHz
input [1:0] sel ,
input [3:0] din1 , //données en entrée
input [3:0] din2 , //données en entrée
output reg [7:0] dout
);
wire [3:0] mul1 = sel == 2'b01 ? din1 : 0 ;
wire [3:0] mul2 = sel == 2'b01 ? din2 : 0 ;
reg [7:0] res ;
always @(*) begin
res = mul1 * mul2 ;
end
always @(posedge clk) begin
if (sel == 2'b01) begin
dout <= res ;
end
end
endmodule
Téléchargement du code source pour ce chapitre
Téléchargement