Die folgende Tabelle zeigt den Prozentsatz der Stromverbrauchsreduzierung, der auf verschiedenen Ebenen des digitalen Entwurfs erreichbar ist. Nach der RTL-Ebene ist das Ausmaß der Stromverbrauchsreduzierung bereits sehr begrenzt.
| Entwurfsebene | Verbesserungsgrad |
|---|---|
| Systemebene | 50% ~ 90% |
| RTL-Ebene | 20% ~ 50% |
| Gatterebene | 10% ~ 15% |
| Transistorebene | 5% ~ 10% |
| Layout-Ebene | < 5% |
Als Pseudo-Coder, der Verilog schreibt, kann man an einigen Arbeiten zur Stromverbrauchsreduzierung auf Systemebene mitwirken, aber der Schwerpunkt sollte auf der Reduzierung des Stromverbrauchs auf RTL-Ebene liegen.
Das Folgende ist in 2 Abschnitte unterteilt, um gängige Methoden zur Leistungsreduzierung auf RTL-Ebene vorzustellen.
Parallelität und Pipelining
Ein Funktionsmodul kann parallel oder pipelined implementiert werden. Beide Methoden tauschen Ressourcen gegen Geschwindigkeit. Der flexible Einsatz dieser beiden Methoden kann in bestimmten Situationen die Leistungsaufnahme senken.
Parallele Verarbeitung
Parallele Verarbeitung kann mehrere Ausführungsanweisungen gleichzeitig bearbeiten, was die Ausführung effizienter macht. Daher kann die Einführung paralleler Verarbeitung unter Bedingungen, die die Arbeitsanforderungen erfüllen, die Systembetriebsfrequenz senken und die Leistungsaufnahme verringern.
Zum Beispiel lauten die Codebeschreibungen für die Verwendung von 1 Multiplizierer und 2 Multiplizierern (parallel) zur Implementierung von 4 Daten-Multiply-Accumulate-Operationen wie folgt:
Beispiel
//1 Multiplizierer, hohe Geschwindigkeit
module mul1_hs
(
input clk , //200MHz
input rstn ,
input en ,
input [3:0] mul1 , //Daten in
input [3:0] mul2 , //Daten in
output dout_en ,
output [8:0] dout
);
reg flag ;
reg en_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
flag <= 1'b0 ;
en_r <= 1'b0 ;
end
else if (en) begin
flag <= ~flag ;
en_r <= 1'b1 ;
end
else begin
flag <= 1'b0 ;
en_r <= 1'b0 ;
end
end
wire [7:0] result = mul1 * mul2 ;
// Datenausgabe-Freigabe
reg [7:0] res1_r, res2_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
res1_r <= 'b0 ;
res2_r <= 'b0 ;
end
else if (en & !flag) begin
res1_r <= result ;
end
else if (en & flag) begin
res2_r <= result ;
end
end
assign dout_en = en_r & !flag ;
assign dout = res1_r + res2_r ;
endmodule
//===========================================
// 2 multiplier2, niedrige Geschwindigkeit
module mul2_ls
(
input clk , //100MHz
input rstn ,
input en ,
input [3:0] mul1 , //Daten in
input [3:0] mul2 , //Daten in
input [3:0] mul3 , //Dateneingang
input [3:0] mul4 , //Dateneingang
output dout_en,
output [8:0] dout
);
wire [7:0] result1 = mul1 * mul2 ;
wire [7:0] result2 = mul3 * mul4 ;
//en Verzögerung
reg en_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
en_r <= 1'b0 ;
end
else begin
en_r <= en ;
end
end
// Datenausgabe-Freigabe
reg [7:0] res1_r, res2_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
res1_r <= 'b0 ;
res2_r <= 'b0 ;
end
else if (en) begin
res1_r <= result1 ;
res2_r <= result2 ;
end
end
assign dout = res1_r + res2_r ;
assign dout_en = en_r ;
endmodule
Die Testbench ist wie folgt beschrieben.
Beispiel
module test ;
reg rstn ;
//mul1_hs
reg hs_clk;
reg hs_en ;
reg [3:0] hs_mul1 ;
reg [3:0] hs_mul2 ;
wire hs_dout_en ;
wire [8:0] hs_dout ;
//mul1_ls
reg ls_clk = 0;
reg ls_en ;
reg [3:0] ls_mul1 ;
reg [3:0] ls_mul2 ;
reg [3:0] ls_mul3 ;
reg [3:0] ls_mul4 ;
wire ls_dout_en ;
wire [8:0] ls_dout ;
//Takterzeugung
real CYCLE_200MHz = 5 ; //
always begin
hs_clk = 0 ; #(CYCLE_200MHz/2) ;
hs_clk = 1 ; #(CYCLE_200MHz/2) ;
end
always begin
@(posedge hs_clk) ls_clk = ~ls_clk ;
end
//Reset-Erzeugung
initial begin
rstn = 1'b0 ;
#8 rstn = 1'b1 ;
end
//Motivation
initial begin
hs_mul1 = 0 ;
hs_mul2 = 16 ;
hs_en = 0 ;
#103 ;
repeat(12) begin
@(negedge hs_clk) ;
hs_en = 1 ;
hs_mul1 = hs_mul1 + 1;
hs_mul2 = hs_mul2 - 1;
end
hs_en = 0 ;
end
initial begin
ls_mul1 = 1 ;
ls_mul2 = 15 ;
ls_mul3 = 2 ;
ls_mul4 = 14 ;
ls_en = 0 ;
#103 ;
@(negedge ls_clk) ls_en = 1;
repeat(5) begin
@(negedge ls_clk) ;
ls_mul1 = ls_mul1 + 2;
ls_mul2 = ls_mul2 - 2;
ls_mul3 = ls_mul3 + 2;
ls_mul4 = ls_mul4 - 2;
end
ls_en = 0 ;
end
//Modulinstanziierung
mul1_hs u_mul1_hs
(
.clk (hs_clk),
.rstn (rstn),
.en (hs_en),
.mul1 (hs_mul1),
.mul2 (hs_mul2),
.dout (hs_dout),
.dout_en (hs_dout_en)
);
mul2_ls u_mul2_ls
(
.clk (ls_clk),
.rstn (rstn),
.en (ls_en),
.mul1 (ls_mul1),
.mul2 (ls_mul2),
.mul3 (ls_mul3),
.mul4 (ls_mul4),
.dout (ls_dout),
.dout_en (ls_dout_en)
);
//Simulationsende
always begin
#100;
if ($time >= 1000) begin
#1 ;
$finish ;
end
end
endmodule
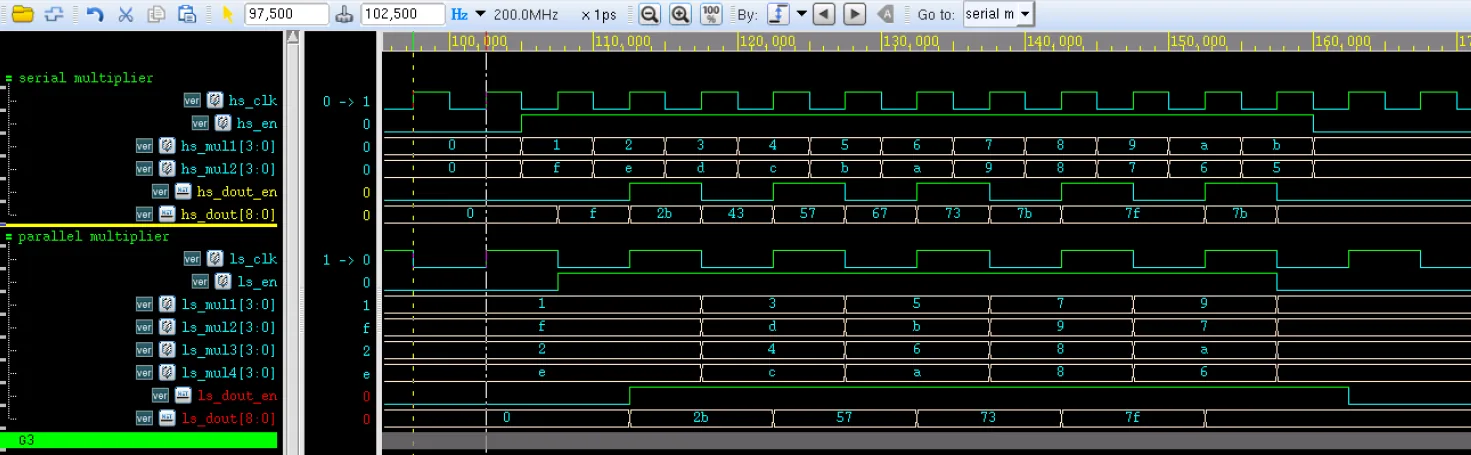
Die Simulationsergebnisse sind wie folgt.
Aus der Abbildung ist ersichtlich, dass die beiden Implementierungsmethoden dieselben Ausgabeergebnisse liefern, aber die parallele Verarbeitungsmethode die Betriebsfrequenz halbiert, wodurch die Leistungsaufnahme sinkt, während die Entwurfsfläche ebenfalls zunimmt.
Pipelining
In„Verilog Tutorial“wurde beschrieben, dass ein kontinuierlich arbeitendes N-stufiges Pipeline-Design die Effizienz um etwa den Faktor N verbessert. Wie beim parallelen Design kann bei Verwendung eines Pipeline-Designs auch die Betriebsfrequenz angemessen reduziert werden, um die Leistungsaufnahme zu senken.
Aus einer anderen Perspektive kann ein Pipeline-Design einen langen kombinatorischen Pfad in N Pipeline-Stufen unterteilen. Die Pfadlänge wird auf 1/N der ursprünglichen Pfadlänge verkürzt. Wenn die Taktfrequenz zu diesem Zeitpunkt unverändert bleibt, muss innerhalb eines Zyklus nur die Kapazität C/N geladen und entladen werden statt der ursprünglichen Kapazität C. Daher kann bei gleicher Frequenzanforderung eine niedrigere Versorgungsspannung verwendet werden, um das System zu betreiben, wodurch die Leistungsaufnahme reduziert wird.
Angenommen, in einem Design ist der kritische Pfad ein 32-Bit-mal-32-Bit-Multiplizierer. Die Gesamtkapazität dieses Multiplizierers ist C und die Betriebsspannung ist V.
Ohne Pipelining sollte die Betriebsspannung V betragen, um diese Betriebsfrequenz zu erreichen.
Bei Verwendung einer zweistufigen Pipeline wird der Pfad in zwei Teile geteilt. Für jeden Teil wird die Gesamtkapazität zu C/2. Um die ursprüngliche Betriebsfrequenz zu erreichen, kann die Betriebsspannung auf βV (β<1) reduziert werden. Die Leistungsaufnahme des gesamten Systems wird auf β^2 des ursprünglichen Werts reduziert.
Für spezifische Pipeline-Designmethoden wird bitte auf„Verilog Tutorial“im Kapitel„6.7 Verilog Pipeline“ verwiesen.-Abschnitt weggelassen werden.
Ressourcenteilung und Zustandskodierung
Ressourcenteilung
Wenn dieselbe Operationslogik an mehreren Stellen in einem Design verwendet wird, kann Ressourcenteilung verwendet werden, um die Duplizierung mehrerer Operationslogikblöcke zu vermeiden und den Ressourcenverbrauch zu reduzieren.
Beispielsweise lautet für eine Vergleichslogik die Codebeschreibung ohne Ressourcenteilung wie folgt:
Beispiel
case (mode) :
3'b000: result = 1'b1 ;
3'b001: result = 1'b0 ;
3'b010: result = value1 == value2 ;
3'b011: result = value1 != value2 ;
3'b100: result = value1 > value2 ;
3'b101: result = value1 < value2 ;
3'b110: result = value1 >= value2 ;
3'b111: result = value1 <= value2 ;
endcase
end
Der obige Code ist optimiert und wird wie folgt beschrieben:
wire equal_con = value1 == value2 ;
wire great_con = value1 > value2 ;
always @(*) begin
case (mode) :
3'b000: result = 1'b1 ;
3'b001: result = 1'b0 ;
3'b010: result = equal_con ;
3'b011: result = equal_con ;
3'b100: result = great_con ;
3'b101: result = !great_con && !equal_con ;
3'b110: result = great_con && equal_con ;
3'b111: result = !great_con ;
endcase
end
Wenn die erste Methode synthetisiert wird und die Compiler-Optimierung nicht gut durchgeführt wird, können 6 Komparatoren erforderlich sein. Die zweite Ressourcen-Sharing-Methode benötigt nur 2 Komparatoren, um dieselbe Logikfunktion zu erfüllen, wodurch die Leistungsaufnahme bis zu einem gewissen Grad reduziert wird.
Zustandskodierung
Bei einigen sich häufig ändernden Signalen ist die Umschaltrate relativ hoch und die Leistungsaufnahme relativ groß. Die Zustandskodierung kann verwendet werden, um die Schaltaktivität zu verringern und die Leistungsaufnahme zu senken.
Wenn beispielsweise ein Hochgeschwindigkeitszähler arbeitet, bewirkt die Verwendung von Gray-Code anstelle der Binärkodierung, dass zu jedem Zeitpunkt nur 1 Bit der Daten umschaltet, wodurch die Umschaltrate verringert und dadurch die Leistungsaufnahme gesenkt wird.
Wenn beispielsweise eine Zustandsmaschine entworfen wird, wird die Umschaltrate ebenfalls verringert, wenn sich die Zustandskodierung vor und nach einem Zustandsübergang nur um 1 Bit unterscheidet.
Operandenisolation
Prinzip der Operandenisolation: Wenn die Ausgabe eines Datenpfads während eines bestimmten Zeitraums ungenutzt ist, verhindert das Setzen des Eingangs auf einen festen Wert das Umschalten im Datenpfad, wodurch der Stromverbrauch reduziert wird.
Ein Schaltbild eines Multiplizierers ist unten dargestellt.
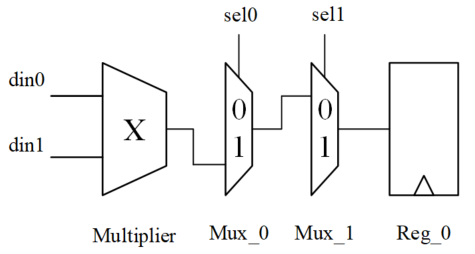
Wenn sel0 = 0 oder sel1 = 1, kann die Ausgabe des Multiplizierers den Eingang des Registers nicht über die beiden Multiplexer erreichen. Das heißt, das Register kann das aktuelle Multiplikationsergebnis nicht speichern, daher ist diese Multiplikationsoperation unnötig. Unter solchen Bedingungen kann Operandenisolation verwendet werden, um den Multiplizierer inaktiv und statisch zu halten, was ebenfalls Energie spart.
Eine Optimierung der obigen Schaltung ist in der folgenden Abbildung dargestellt.
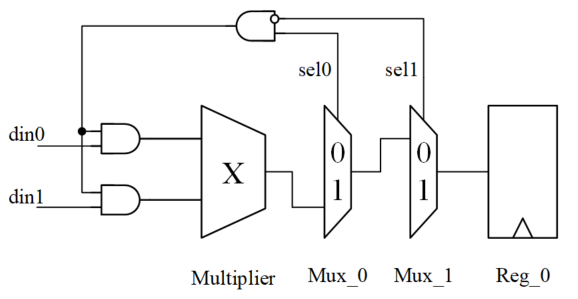
Nach der Operandenisolation ist bei sel0 = 0 oder sel1 = 1 der Eingang des Multiplizierers immer 0, es findet kein Signalumschalten statt, und der Multiplizierer führt keine zusätzliche ungültige Arbeit aus, sodass der Stromverbrauch reduziert wird.
Im Allgemeinen erfolgt die Operandenisolation während der Logiksynthese. Dieser Prozess ist oft manuell konfigurierbar und kann vom Compiler automatisch erkannt werden. Natürlich ist ein guter Codierungsstil, der diese Aspekte beim Schreiben von RTL-Schaltungen gründlich berücksichtigt, förderlicher für die Implementierung der Operandenisolation und damit für die Reduzierung des Stromverbrauchs.
Wenn der Multiplizierer keine Operandenisolation verwendet, lautet die Verilog-Codebeschreibung wie folgt:
Beispiel
module oper_isolation1
(
input clk , //100MHz
input [1:0] sel ,
input [3:0] din1 , //Daten in
input [3:0] din2 , //Daten in
output reg [7:0] dout
);
reg [7:0] res ;
always @(*) begin
res = din1 * din2 ;
end
always @(posedge clk) begin
if (sel == 2'b01) begin
dout <= res ;
end
end
endmodule
Wenn der Multiplizierer Operandenisolation verwendet, lautet die Verilog-Codebeschreibung wie folgt:
Beispiel
module oper_isolation2
(
input clk , //100MHz
input [1:0] sel ,
input [3:0] din1 , //Daten in
input [3:0] din2 , //Daten in
output reg [7:0] dout
);
wire [3:0] mul1 = sel == 2'b01 ? din1 : 0 ;
wire [3:0] mul2 = sel == 2'b01 ? din2 : 0 ;
reg [7:0] res ;
always @(*) begin
res = mul1 * mul2 ;
end
always @(posedge clk) begin
if (sel == 2'b01) begin
dout <= res ;
end
end
endmodule
Quellcode-Download für dieses Kapitel
Herunterladen