Случайные числа
В Verilog системная задача $random(seed) используется для генерации случайных чисел, где seed — это зерно генератора случайных чисел.
Разные значения seed дают разные случайные числа. Если seed одинаков, сгенерированные случайные числа также одинаковы.
Можно присвоить seed начальное значение или опустить параметр seed; начальное значение seed по умолчанию равно 0.
Следующий код показывает, как вызвать $random без использования параметра seed, а также с указанием и изменением seed:
Пример
integer seed ;
initial begin
seed = 2 ;
#30 ;
seed = 10 ;
end
// без seed
reg [15:0] randnum_noseed ;
always@(posedge clk) begin
randnum_noseed <= $random(); // Без указания seed
end
//с seed
reg [15:0] randnum_wtseed ;
always@(posedge clk) begin
randnum_wtseed <= $random(seed); // Указать seed
end
Временная диаграмма моделирования выглядит следующим образом.
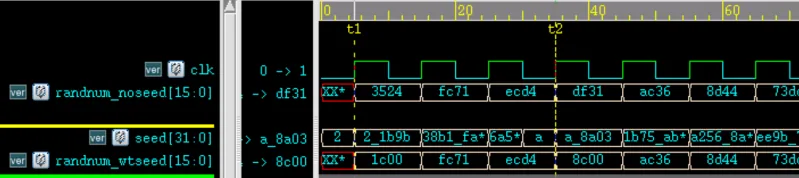
Независимо от того, присвоено ли начальное значение, каждый раз при генерации случайного числа значение seed изменяется, и случайное число изменяется соответственно.
Каждый раз, когда значение seed изменяется, текущее выходное случайное значение изменяется; однако в следующем состоянии поведение случайного числа возвращается к внутренней случайной последовательности, генерируемой системой.
Например, на диаграмме моделирования в моменты времени t1 и t2 значения seed различны, поэтому сгенерированные случайные числа также различны. Но в других тактовых циклах сгенерированные случайные числа одинаковы.
Рекомендуется не указывать опцию seed при вызове системной задачи $random или использовать переменную для передачи параметра при указании опции seed.
Не рекомендуется записывать константу в параметр seed при вызове $random. В этом случае значение seed фиксировано, и может быть сгенерировано только одно случайное число. Например, следующий стиль кодирования не рекомендуется:
randnum_wtseed <= $random(2); //不建议将常数项指定给 seed
Можно использовать операцию взятия по модулю, чтобы ограничить случайные числа определённым диапазоном данных. Например:
Пример
parameter MAX_NUM = 512;
parameter MIN_NUM = 256;
reg [15:0] num_range1, num_range2, num_range3 ;
always@(posedge clk) begin
// Сгенерированные случайные числа находятся в диапазоне от -511 до 511, ±(MAX_NUM-1)
num_range1 <= $random() % MAX_NUM;
// Сгенерированные случайные числа находятся в диапазоне от 0 до 511, (0 ~ MAX_NUM-1)
num_range2 <= {$random()} % MAX_NUM;
// Сгенерированные случайные числа находятся в диапазоне от MIN_NUM до MAX_NUM, включая границы
num_range3 <= MIN_NUM + {$random()} % (MAX_NUM-MIN_NUM+1);
end
Случайные числа отображаются в знаковом десятичном формате. Первые несколько результатов данных выглядят следующим образом:

Распределения вероятностей
Verilog предоставляет множество системных задач, которые генерируют данные в соответствии с определёнными вероятностными распределениями. Краткое описание таково:
| Системная задача | Формат вызова | Описание задачи |
|---|---|---|
| Равномерное распределение | $dist_uniform(seed, start, end); | start и end — это начало и конец данных |
| Нормальное распределение | $dist_normal (seed, mean, std_dev); | mean — это математическое ожидание, std_dev — стандартное отклонение |
| Распределение Пуассона | $dist_poisson(seed, mean); | mean — это математическое ожидание (равно стандартному отклонению) |
| Экспоненциальное распределение | $dist_exponential(seed , mean); | mean — это количество появлений события за единицу времени |
| Распределение хи-квадрат | $dist_chi_square(seed, free_deg); | free_deg — это число степеней свободы |
| t-распределение | $dist_t(seed, free_deg); | free_deg — это число степеней свободы |
| Распределение Эрланга | $dist_erlang(seed, k_stage, mean); | k_stage — это число этапов, mean — это математическое ожидание |
Равномерное распределение
У равномерного распределения равные вероятности принимать значения в интервалах одинаковой длины.
Функция плотности вероятности и график распределения вероятностей приведены ниже:
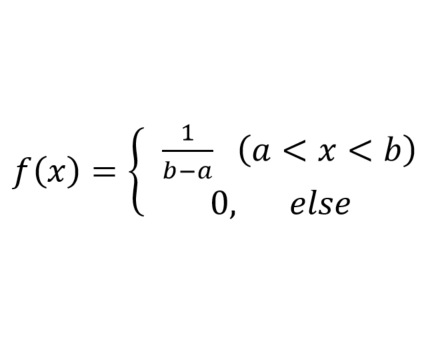
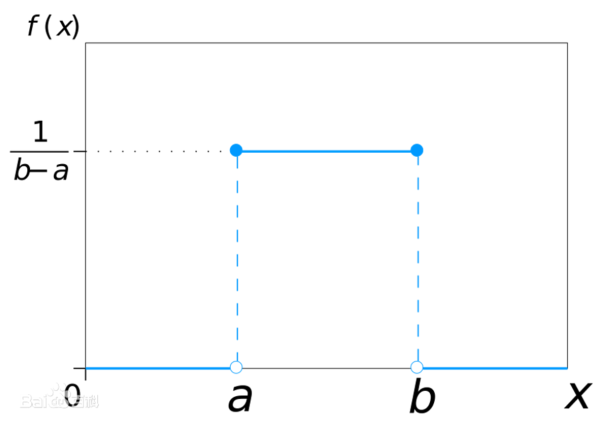
Фактически системная задача $random реализует равномерное распределение.
Код для вызова $dist_uniform для генерации равномерно распределённых данных на интервале (256, 512) выглядит следующим образом:
Пример
reg [15:0] data_uniform;
always@(posedge clk) begin // Генерация случайных чисел между MIN_NUM и MAX_NUM
data_uniform <= $dist_uniform(seed_dis, MIN_NUM, MAX_NUM);
end
Нормальное распределение
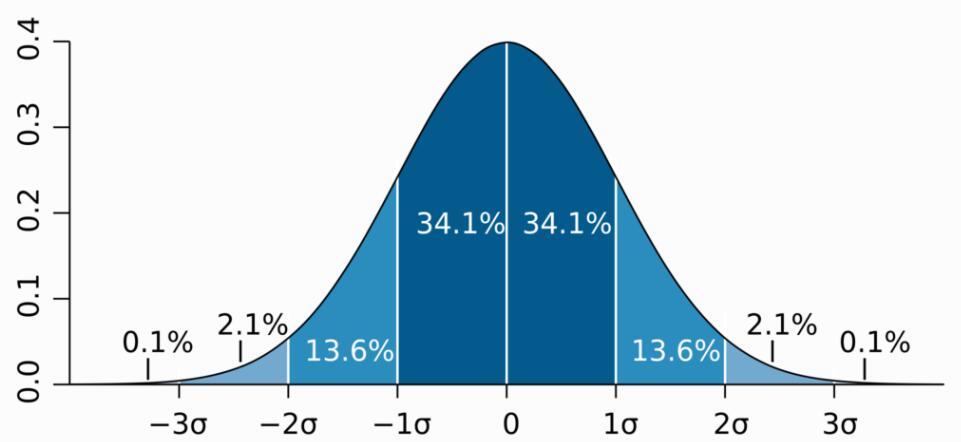
Математическое ожидание нормального распределения равно μ, стандартное отклонение равно σ, обозначается какN (μ, σ²)。
Нормальное распределение с математическим ожиданием 0 и стандартным отклонением 1 называется стандартным нормальным распределением.
Кривая нормального распределения имеет колоколообразную форму, низкая с обеих сторон, высокая в середине и симметричная слева и справа.
Функция плотности вероятности и график распределения нормального распределения выглядят следующим образом:
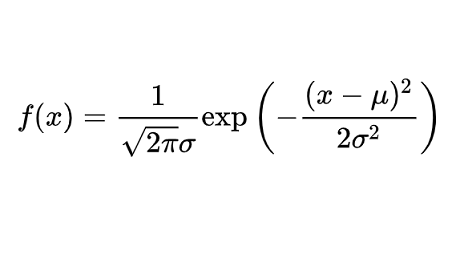
Код для вызова $dist_normal для генерации данных стандартного нормального распределения с математическим ожиданием 0 и стандартным отклонением 1 выглядит следующим образом:
Пример
reg [15:0] data_normal;
always@(posedge clk) begin // Стандартное нормальное распределение с математическим ожиданием 0 и стандартным отклонением 1
data_normal <= $dist_normal(seed_dis, 0, 1);
end
Распределение Пуассона
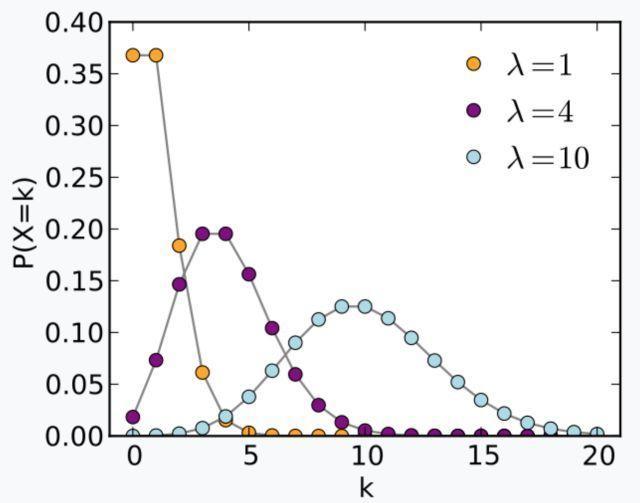
Распределение Пуассона используется для описания вероятности того, что событие произойдет X раз в течение определенного времени или в определенном пространственном диапазоне.
Распределение Пуассона имеет одинаковые математическое ожидание и стандартное отклонение, оба равны λ. Его функция плотности вероятности и график распределения выглядят следующим образом:
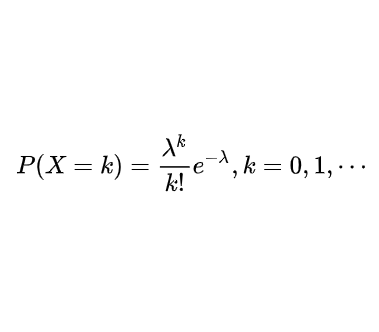
Код для вызова $dist_poisson для генерации данных распределения Пуассона с математическим ожиданием 4 выглядит следующим образом:
Пример
reg [15:0] data_poisson;
always@(posedge clk) begin
data_poisson <= $dist_poisson(seed_dis, 4);
end
Экспоненциальное распределение
Экспоненциальное распределение используется для описания вероятности временного интервала между наступлениями случайных событий в пуассоновском процессе. Пуассоновский процесс — это процесс, в котором события происходят непрерывно и независимо с постоянной средней интенсивностью. Например, временной интервал между прибытиями двух автобусов во время ожидания на автобусной остановке подчиняется экспоненциальному распределению.
Пусть λ>0 — число появлений события за единицу времени (также называемое параметром интенсивности), а x — временной интервал между появлениями событий. Тогда его функция плотности вероятности и график распределения выглядят следующим образом:
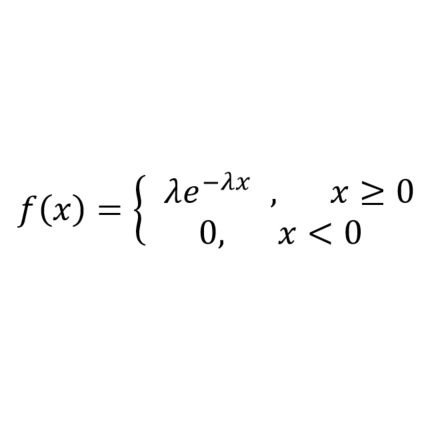
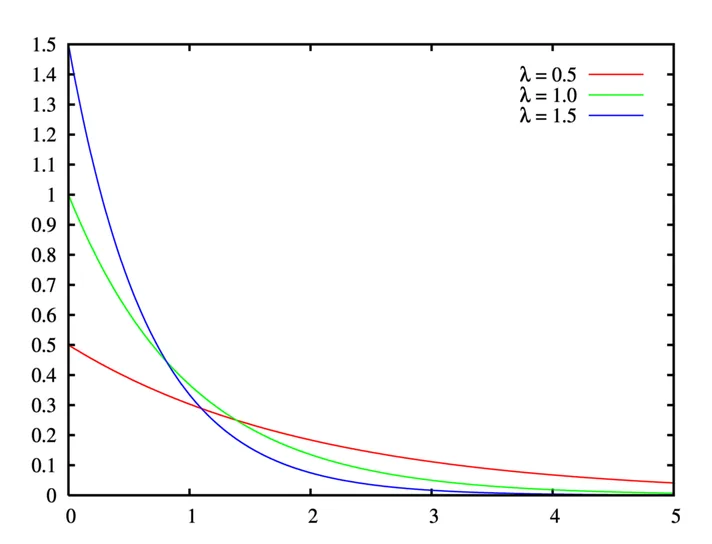
Код для вызова $dist_exponential для генерации данных экспоненциального распределения с параметром интенсивности 1 выглядит следующим образом:
Пример
reg [15:0] data_exp;
always@(posedge clk) begin
data_exp <= $dist_exponential(seed_dis, 1);
end
Распределение хи-квадрат
Закон распределения новой случайной величины, образованной суммой квадратов n случайных величин, следующих стандартному нормальному распределению, называется распределением хи-квадрат, обозначается как , где n называется числом степеней свободы.
Функция плотности вероятности и график распределения хи-квадрат выглядят следующим образом:
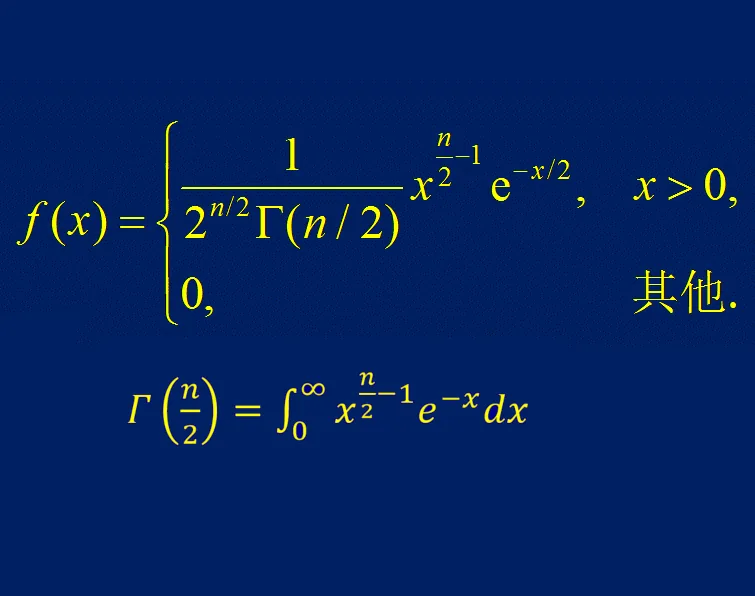
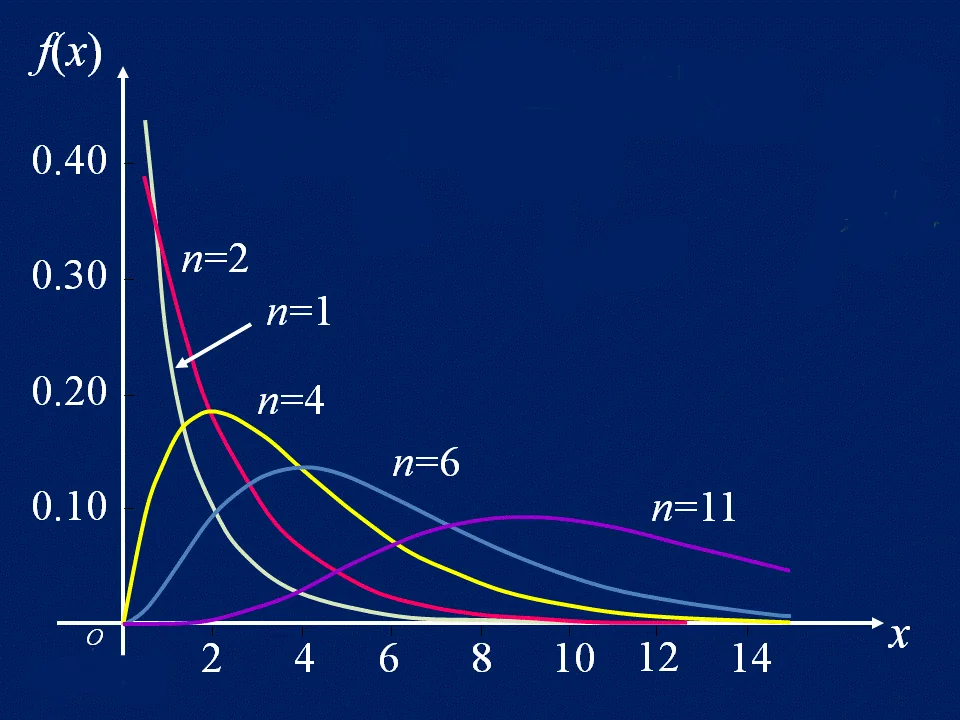
Код для вызова $dist_chi_square для генерации данных распределения хи-квадрат с 6 степенями свободы выглядит следующим образом:
Пример
reg [15:0] data_chi_sq;
always@(posedge clk) begin
data_chi_sq <= $dist_chi_square(seed_dis, 6);
end
t-распределение
Предположим, X следует стандартному нормальному распределению N(0, 1), а Y следует распределению хи-квадратРаспределение ... называется t-распределением с n степенями свободы, обозначается как Z ~ t(n).
t-распределение используется для оценки среднего генеральной совокупности переменной данных, имеющей нормальное распределение с неизвестной дисперсией, на основе малых выборок. Если объем выборки достаточно велик и дисперсия генеральной совокупности известна, то для оценки среднего генеральной совокупности следует использовать нормальное распределение.
t-распределение — это симметричное колоколообразное распределение, похожее на нормальное распределение, но с более тяжелыми хвостами, что означает более высокую вероятность появления значений, значительно меньших среднего. Его функция плотности вероятности и график распределения выглядят следующим образом:
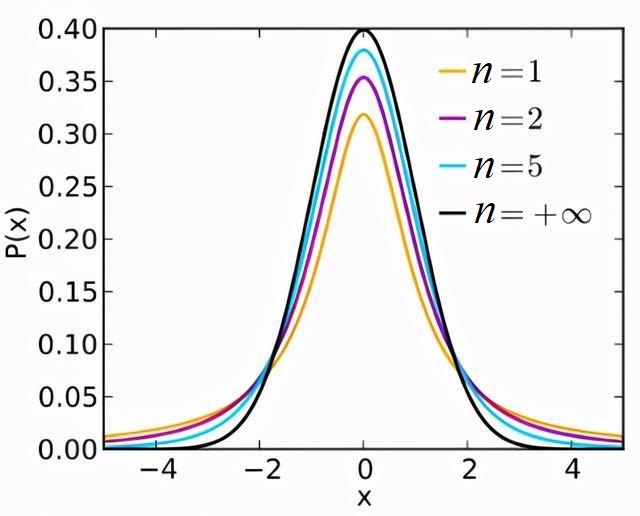
Код вызова $dist_t для генерации данных t-распределения с 5 степенями свободы выглядит следующим образом:
Пример
reg [15:0] data_t;
always@(posedge clk) begin
data_t <= $dist_t(seed_dis, 5);
end
Распределение Эрланга
Пусть V1, V2, ..., Vn взаимно независимы в пуассоновском процессе с параметром λ, и пусть N(t) обозначает число случайных точек в [0, t). Тогда распределение N(t) = V1 + V2 + ... + Vn называется распределением Эрланга.
Распределение Эрланга, как и экспоненциальное распределение, часто используется для представления временного интервала между независимыми случайными событиями. Случайная величина, подчиняющаяся распределению Эрланга, может быть разложена в сумму нескольких случайных величин с экспоненциальным распределением с одним и тем же параметром, что делает распределение Эрланга широко применяемым в теории надежности и теории массового обслуживания.
Функция плотности вероятности и график распределения Эрланга выглядят следующим образом:
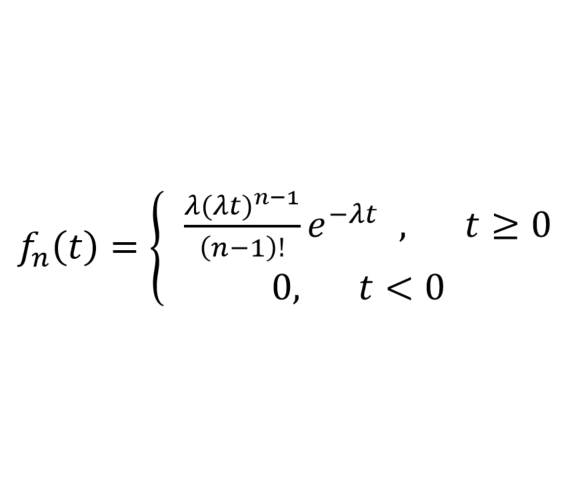
Почему такое лицо? Ты действительно используешь такую нелепую идею, чтобы раздуть распределение Эрланга?
Приведенные выше задачи по распределению вероятностей только перечисляют способы вызова, не анализируя и не проверяя данные. Далее рассказывается, как самостоятельно проанализировать характеристики данных, сгенерированных задачей распределения вероятностей $dist_erlang, с помощью инструмента построения графиков Matlab.
Код вызова $dist_erlang для генерации данных распределения Эрланга порядка 3 и математическим ожиданием 6 выглядит следующим образом:
Пример
reg [15:0] data_erlang;
always@(posedge clk) begin
data_erlang <= $dist_erlang(seed_dis, 3, 6);
end
Анализ данных
Реальность доказывает, что удобнее анализировать знакомые данные распределения. На некоторых платформах встроенные функции, на которые можно ссылаться и которые связаны с распределением Эрланга, встречаются крайне редко. Хорошо понимая, что любви (Erlang) нет, мы всё равно идём за любовью!
Файлы данных Verilog
Сначала сгенерируйте 4 набора данных, следующих распределению Эрланга, в модели Verilog и выведите их в файл.
Пример
integer fd1, fd2, fd3, fd30 ;
initial begin
fd1 = $fopen("data_erlang1.hex", "w");
fd2 = $fopen("data_erlang2.hex", "w");
fd3 = $fopen("data_erlang3.hex", "w");
fd30 = $fopen("data_erlang30.hex", "w");
repeat(1000) begin //Взять 1000 данных для анализа
@(posedge clk) ;
#1 ;
$fdisplay(fd1, "%h", data_erlang1);
$fdisplay(fd2, "%h", data_erlang2);
$fdisplay(fd3, "%h", data_erlang3);
$fdisplay(fd30, "%h", data_erlang30);
end
$fclose(fd1);
$fclose(fd2);
$fclose(fd3);
$fclose(fd30);
end
reg [15:0] data_erlang1;
reg [15:0] data_erlang2;
reg [15:0] data_erlang3;
reg [15:0] data_erlang30;
always@(posedge clk) begin
data_erlang1 <= $dist_erlang(seed_dis, 1, 6);
data_erlang2 <= $dist_erlang(seed_dis, 2, 6);
data_erlang3 <= $dist_erlang(seed_dis, 3, 6);
data_erlang30 <= $dist_erlang(seed_dis, 30, 6);
end
Анализ данных Verilog
В Matlab функцию гистограммы hist можно напрямую использовать для статистического построения и отображения каждого данного, но для распределения вероятностей фактический эффект построения этой функции не очень хорош (приветствуется предложение лучшего способа построения). Здесь функция Matlab tabulate используется для подсчёта каждого данного, а затем обычная функция plot применяется для отображения его процентной доли.
Код для Matlab для чтения данных, сгенерированных модулем Verilog, и отображения графика их распределения выглядит следующим образом.
Пример
%=======================================================
% анализ данных из $dist_erlang в Verilog
%=======================================================
%Считать как строки, затем преобразовать из шестнадцатеричного представления в десятичное.
data_erlang1_hex = textread('data_erlang1.hex', '%s') ;
data_erlang2_hex = textread('data_erlang2.hex', '%s') ;
data_erlang3_hex = textread('data_erlang3.hex', '%s') ;
data_erlang30_hex = textread('data_erlang30.hex', '%s') ;
data_erlang1 = hex2dec(data_erlang1_hex);
data_erlang2 = hex2dec(data_erlang2_hex);
data_erlang3 = hex2dec(data_erlang3_hex);
data_erlang30 = hex2dec(data_erlang30_hex);
%Подсчитайте статистику и постройте график.
num_erlang1 = tabulate(data_erlang1) ;
num_erlang2 = tabulate(data_erlang2) ;
num_erlang3 = tabulate(data_erlang3) ;
num_erlang30 = tabulate(data_erlang30) ;
figure; plot(num_erlang1(:,1)/6, num_erlang1(:,3));
hold on; plot(num_erlang2(:,1)/6, num_erlang2(:,3), 'r');
hold on; plot(num_erlang3(:,1)/6, num_erlang3(:,3), 'g');
hold on; plot(num_erlang30(:,1)/6, num_erlang30(:,3), 'y');
legend('n=1', 'n=2', 'n=3', 'n=30');
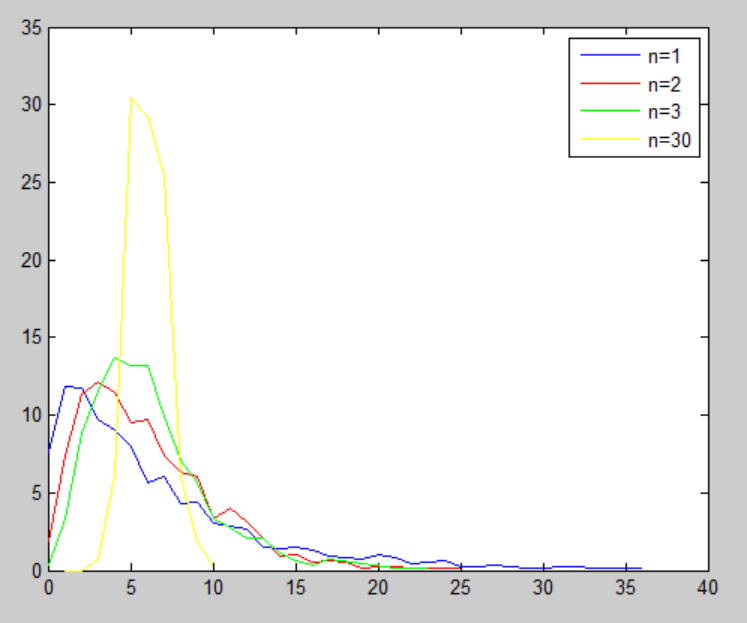
График распределения данных Эрланга, сгенерированный моделью Verilog, показан ниже.
Математическое ожидание распределения Эрланга
Важно отметить, что параметр λ — это математическое ожидание распределения Пуассона, а не математическое ожидание распределения Эрланга.
В системной задаче Verilog $dist_erlang(seed, k_stage, mean) третий параметр — это математическое ожидание. Если напрямую подставить это математическое ожидание в параметр λ, вы получите неверные результаты распределения.
Ниже приведён простой (ленивый) вывод (для справки) математического ожидания распределения Эрланга.
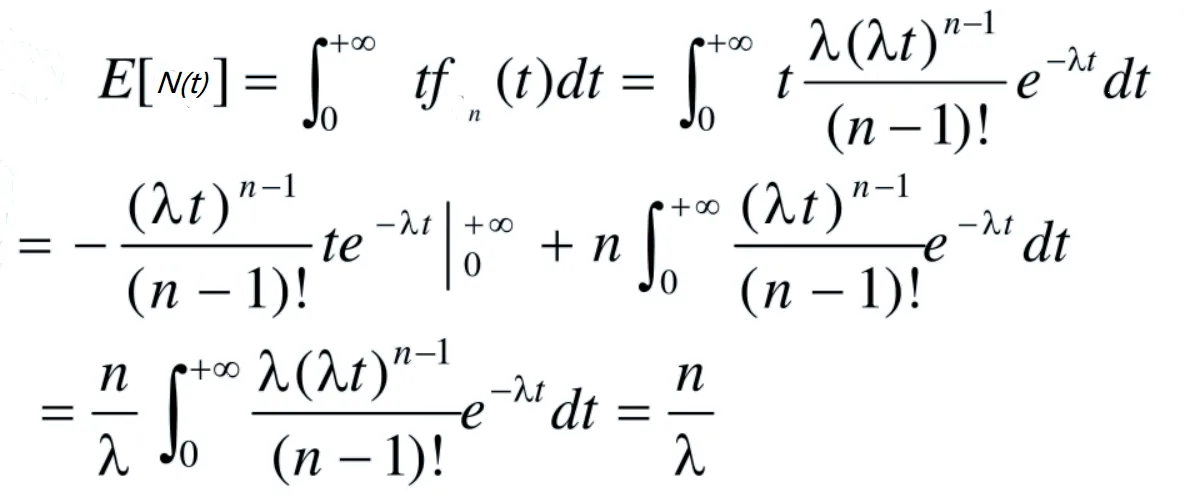
Прилагается процесс вывода дисперсии распределения Эрланга.
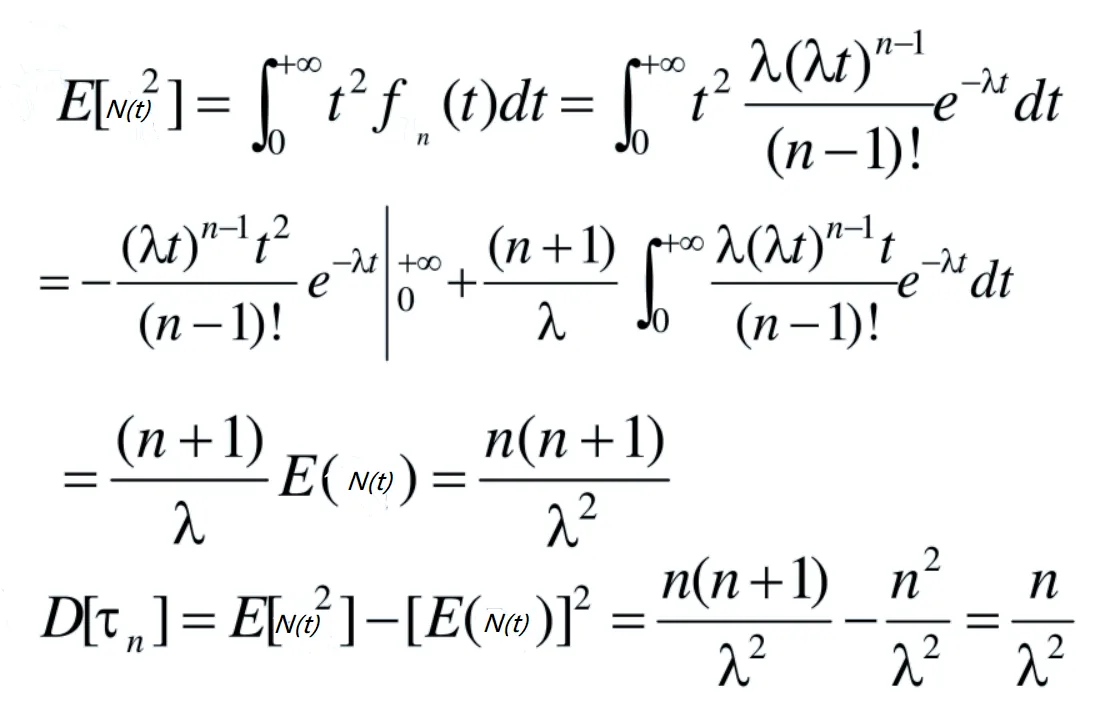
Теоретическое распределение в Matlab
Используя встроенную функцию Matlab random, можно генерировать данные различных типов распределений, но, к сожалению, распределения Эрланга среди них нет.
Далее используйте функцию плотности распределения вероятностей, чтобы сгенерировать данные, следующие распределению Эрланга.
Здесь математическое ожидание в модели Verilog равно 6, поэтому фактический параметр λ = n/6.
Код для генерации данных распределения Эрланга в Matlab выглядит следующим образом.
Пример
%=======================================================
% генерация данных распределения Эрланга
%=======================================================
NUM = 400 ;
EXPECT = 6 ;
for n=[1, 2, 3, 30] //Генерация 4 наборов данных
lamda = n/EXPECT; //Преобразование математического ожидания
t = (0:NUM-1)*0.1 ;
pt(n,:) = (lamda).^n *(t).^(n-1)/factorial(n-1) .* exp(-lamda * t) ;
end
figure; plot(t, pt(1,:)*100);
hold on;plot(t, pt(2,:)*100, 'r');
hold on;plot(t, pt(3,:)*100, 'g');
hold on;plot(t, pt(n,:)*100, 'y');
xlabel('t');
ylabel('f(t) / 100%');
legend('n=1', 'n=2', 'n=3', 'n=30');
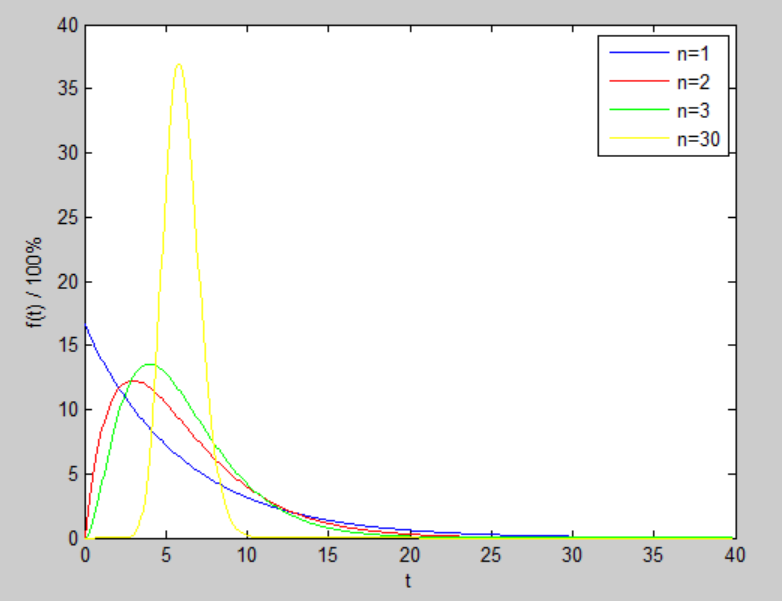
График распределения данных Эрланга, сгенерированный Matlab, показан ниже.
При сравнении с данными, сгенерированными моделью Verilog, диапазон распределения, вероятность распределения и тенденция кривой распределения у обоих в основном совпадают. Единственное отличие состоит в том, что Verilog генерирует данные с большими временными интервалами, поэтому график распределения не является гладкой кривой.
Скачать исходный код для этой главы
Скачать