Ключевые слова: конвейер, умножитель
Заметное преимущество языков описания аппаратуры заключается в параллелизме выполнения команд. Несколько операторов могут параллельно обрабатывать данные нескольких сигналов в одном тактовом цикле.
Однако, когда данные вводятся последовательно, параллелизм выполнения команд не проявляет своего преимущества. Кроме того, во многих случаях некоторые вычисления не могут быть завершены за один или два тактовых цикла. Если каждый последовательно вводимый элемент данных должен ждать завершения предыдущего вычисления, прежде чем начать следующее вычисление, эффективность довольно низкая. Конвейеризация — это решение проблемы низкой эффективности последовательных вычислений при многотактовой обработке.
Конвейер
Основная идея конвейеризации состоит в разбиении повторяющегося процесса на несколько подпроцессов, каждый из которых реализуется выделенным функциональным блоком. Несколько процессов обработки сдвинуты во времени и последовательно проходят через функциональные ступени, так что каждый подпроцесс может выполняться параллельно с другими подпроцессами.
Предположим, процесс стирки белья в прачечной самообслуживания разделён на 4 этапа: сбор белья, стирка, сушка и раскладывание по шкафам. Каждый этап занимает полчаса, поэтому одна стирка белья занимает 2 часа.
Рассмотрим худший случай: в прачечной самообслуживания есть только одна стиральная машина, одна сушильная машина и один шкаф. Если партия белья доставляется каждые полчаса, и каждый раз приходится ждать 2 часа, пока предыдущая партия закончит стирку, то стирка 4 партий белья занимает 8 часов.
Схема выглядит следующим образом:

Модернизируйте оборудование этой прачечной самообслуживания, установив в общей сложности 4 комплекта прачечного оборудования, и увеличьте персонал до 4 человек, каждый из которых отвечает за один этап процесса стирки. Таким образом, каждую партию белья один и тот же человек может своевременно загружать в разные стиральные машины. Поскольку график сдвинут, каждую партию белья одни и те же люди могут стирать, сушить и складывать в шкафы, используя разное оборудование и промежутки времени (полчаса). Схема выглядит следующим образом.

Видно, что стирка 4 партий белья занимает всего 3.5 часа, что значительно повышает эффективность.
Фактически, через 2 часа первый комплект прачечного оборудования завершает процесс стирки и простаивает. Если в это время подать 5-ю партию белья, первый комплект оборудования сможет снова начать работу. По аналогии, пока партии белья непрерывно подаются, 4 комплекта прачечного оборудования могут непрерывно выполнять процесс очистки для всего белья. За исключением первой партии, которая занимает 2 часа, после этого одна партия белья будет стираться и завершаться каждые полчаса.
Чем больше партий белья, тем очевиднее экономия времени. Если имеется N партий белья, требуемое время составляет (4+N) получасов.
Конечно, модернизированный процесс стирки также имеет недостатки. Увеличение количества оборудования и персонала повышает инвестиционные затраты, уменьшает оставшееся пространство в прачечной самообслуживания и делает рабочее состояние более загруженным.
Подобно процессу стирки, путь обработки данных также можно рассматривать как производственную линию. Каждый блок цифровой обработки на этом пути можно рассматривать как этап, который вносит задержку.
Конвейерная организация вычислений систематически разделяет путь на цифровые обрабатывающие блоки (ступени) и вставляет регистры между обрабатывающими блоками для временного хранения промежуточных данных. Разделённые блоки могут выполняться параллельно по ступеням, не влияя друг на друга. Следовательно, конвейерная организация в конечном итоге может повысить пропускную способность данных, то есть увеличить скорость обработки данных.
Недостаток конвейерной организации заключается в том, что каждая ступень обработки требует дополнительных регистров для сохранения промежуточных состояний вычислений, а несколько инструкций, выполняемых параллельно, неизбежно увеличивают энергопотребление.
Далее разрабатывается умножитель и проводится сравнение между применением и неприменением конвейерной организации.
Общая разработка умножителя
Введение
Возможно, кто-то спросит: разве не быстрее и не проще напрямую использовать знак умножения*для выполнения умножения двух чисел?
Если у вас есть это сомнение, значит, ваше понимание языков описания аппаратуры всё ещё недостаточно. Как упоминалось ранее, Verilog описывает аппаратные схемы. При непосредственном использовании знака умножения для выполнения процесса умножения компилятор во время компиляции отображает это выражение умножения на умножитель по умолчанию, но его структура неизвестна.
Например, при проектировании на FPGA можно напрямую вызвать IP-ядро для генерации высокопроизводительного умножителя. Когда разрядность мала, результат может быть выдан в течение одного такта; когда разрядность велика, его также можно выдать конвейерным способом. При условии, что требования могут быть удовлетворены, можно осторожно использовать*или напрямую вызвать IP для выполнения операции умножения.
Но IP-ядро умножителя также имеет много недостатков, таких как ограничения по разрядности, неизвестные тайминги и т. д. Особенно использование знака умножения может заложить большую скрытую опасность, связанную с неопределённостью цифрового проектирования.
Во многих случаях умножение на константу реализуется в форме сдвига и сложения, например:
Пример
A = (A<<1) + A ; // соответствует A * 3
A = (A<<3) + (A<<2) + (A<<1) + A ; // соответствует A * 15
Регистр сдвига и сумматор могут выполнить операцию умножения на 3. Но умножение на 15 требует 3 регистра сдвига и 3 сумматора (конечно, умножение на 15 также можно выполнить с помощью сдвига и вычитания).
Иногда цифровая схема не может выполнить сложение нескольких переменных одновременно в пределах одного такта. Поэтому в цифровом проектировании самая безопасная операция сложения — складывать одновременно только 2 элемента данных; наихудший вариант проектирования — складывать одновременно 4 или более элементов данных.
Если проект содержит операцию, которая одновременно складывает 4 элемента данных, то эта часть проекта опасна и может вызвать нарушения временных требований.
На этом этапе становится необходимым конвейерный умножитель с настраиваемыми параметрами проектирования и управляемыми временными характеристиками.
Принцип проектирования
Подобно умножению десятичных чисел, процесс умножения 13 и 5 показан ниже:
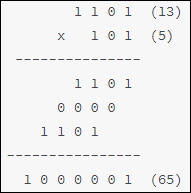
Из этого видно, что множимое сдвигается и накапливается в соответствии с соответствующим битом множителя, тем самым завершая процесс умножения.
Если предположить, что за один такт можно выполнить только одно накопление, минимальное количество тактов для одного умножения в точности равно разрядности множителя. Поэтому рекомендуется использовать в качестве множителя число с меньшей разрядностью, тогда период вычисления будет короче.
Проектирование умножителя
Учитывая, что каждая операция умножения может выводить только один результат (неконвейерный вариант), код проекта выглядит следующим образом.
Пример
#(параметр N=4,
параметр M=4)
(
input clk,
input rstn,
input data_rdy , // разрешение ввода данных
input [N-1:0] mult1, // множимое
input [M-1:0] mult2, // множитель
output res_rdy , // разрешение вывода данных
output [N+M-1:0] res // результат умножения
);
// счётчик вычислений
reg [31:0] cnt ;
// счётчик циклов умножения
wire [31:0] cnt_temp = (cnt == M)? 'b0 : cnt + 1'b1 ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
cnt <= 'b0 ;
end
else if (data_rdy) begin // начать подсчет, когда данные разрешены
cnt <= cnt_temp ;
end
else if (cnt != 0 ) begin // предотвратить слишком короткую длительность входного разрешения
cnt <= cnt_temp ;
end
else begin
cnt <= 'b0 ;
end
end
//умножить
reg [M-1:0] mult2_shift ;
reg [M+N-1:0] mult1_shift ;
reg [M+N-1:0] mult1_acc ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
mult2_shift <= 'b0 ;
mult1_shift <= 'b0 ;
mult1_acc <= 'b0 ;
end
else if (data_rdy && cnt=='b0) begin // инициализация
mult1_shift <= {{(N){1'b0}}, mult1} << 1 ;
mult2_shift <= mult2 >> 1 ;
mult1_acc <= mult2[0] ? {{(N){1'b0}}, mult1} : 'b0 ;
end
else if (cnt != M) begin
mult1_shift <= mult1_shift << 1 ; // множимое, умноженное на 2
mult2_shift <= mult2_shift >> 1 ; // сдвинуть множитель вправо для удобства проверки
// проверить, равен ли соответствующий бит множителя 1; если 1, накапливать
mult1_acc <= mult2_shift[0] ? mult1_acc + mult1_shift : mult1_acc ;
end
else begin
mult2_shift <= 'b0 ;
mult1_shift <= 'b0 ;
mult1_acc <= 'b0 ;
end
end
//результаты
reg [M+N-1:0] res_r ;
reg res_rdy_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
res_r <= 'b0 ;
res_rdy_r <= 'b0 ;
end
else if (cnt == M) begin
res_r <= mult1_acc ; // вывести результат в конце циклов умножения
res_rdy_r <= 1'b1 ;
end
else begin
res_r <= 'b0 ;
res_rdy_r <= 'b0 ;
end
end
assign res_rdy = res_rdy_r;
assign res = res_r;
endmodule
testbench
Пример
module test ;
параметр N = 8 ;
параметр M = 4 ;
reg clk, rstn;
//синхросигнал
always begin
clk = 0 ; #5 ;
clk = 1 ; #5 ;
end
//сброс
initial begin
rstn = 1'b0 ;
#8 ; rstn = 1'b1 ;
end
//без конвейера
reg data_rdy_low ;
reg [N-1:0] mult1_low ;
reg [M-1:0] mult2_low ;
wire [M+N-1:0] res_low ;
wire res_rdy_low ;
// использовать задачу для периодического стимула
task mult_data_in ;
input [M+N-1:0] mult1_task, mult2_task ;
begin
wait(!test.u_mult_low.res_rdy) ; //не состояние выхода
@(negedge clk ) ;
data_rdy_low = 1'b1 ;
mult1_low = mult1_task ;
mult2_low = mult2_task ;
@(negedge clk ) ;
data_rdy_low = 1'b0 ;
wait(test.u_mult_low.res_rdy) ; //проверить состояние выхода
end
endtask
//драйвер
initial begin
#55 ;
mult_data_in(25, 5 ) ;
mult_data_in(16, 10 ) ;
mult_data_in(10, 4 ) ;
mult_data_in(15, 7) ;
mult_data_in(215, 9) ;
end
mult_low #(.N(N), .M(M))
u_mult_low
(
.clk (clk),
.rstn (rstn),
.data_rdy (data_rdy_low),
.mult1 (mult1_low),
.mult2 (mult2_low),
.res_rdy (res_rdy_low),
.res (res_low));
//завершение моделирования
initial begin
forever begin
#100;
if ($time >= 10000) $finish ;
end
end
endmodule // test
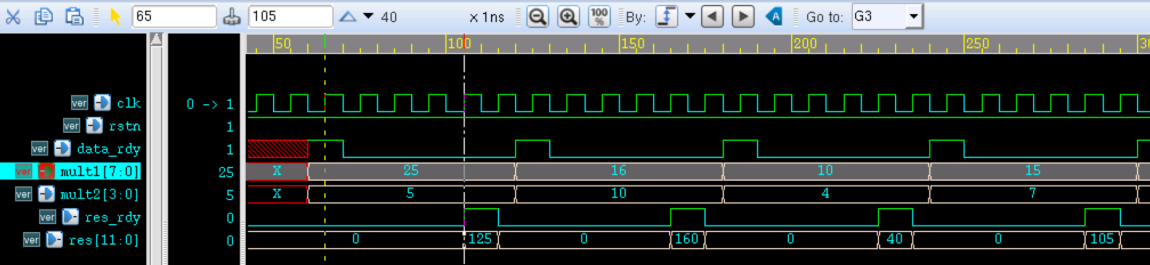
Результаты моделирования следующие.
Как видно из рисунка, два входных элемента данных получают правильный результат умножения после задержки в 4 цикла. Включая время задержки ввода промежуточных данных, вычисление 4 умножений занимает около 20 тактов.
Проектирование конвейерного умножителя
Далее промежуточные состояния процесса выполнения умножения сохраняются, чтобы обеспечить конвейерную работу. Код проекта приведён ниже.
Файл кода для процесса вычисления одного накопления выглядит следующим образом (mult_cell.v):
Пример
#(параметр N=4,
параметр M=4)
(
input clk,
input rstn,
input en,
input [M+N-1:0] mult1, // множимое
input [M-1:0] mult2, // множитель
input [M+N-1:0] mult1_acci, // предыдущий результат накопления
output reg [M+N-1:0] mult1_o, // сохранённое значение после сдвига множимого
output reg [M-1:0] mult2_shift, // сохранённое значение после сдвига множителя
output reg [N+M-1:0] mult1_acco, // текущий результат накопления
output reg rdy );
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
rdy <= 'b0 ;
mult1_o <= 'b0 ;
mult1_acco <= 'b0 ;
mult2_shift <= 'b0 ;
end
else if (en) begin
rdy <= 1'b1 ;
mult2_shift <= mult2 >> 1 ;
mult1_o <= mult1 << 1 ;
if (mult2[0]) begin
// накапливать, если соответствующий бит множителя равен 1
mult1_acco <= mult1_acci + mult1 ;
end
else begin
mult1_acco <= mult1_acci ; // оставить, если соответствующий бит множителя равен 1
end
end
else begin
rdy <= 'b0 ;
mult1_o <= 'b0 ;
mult1_acco <= 'b0 ;
mult2_shift <= 'b0 ;
end
end
endmodule
Инстанцирование верхнего уровня
Многократное инстанцирование модулей обеспечивает многократное накопление. Файл кода выглядит следующим образом (mult_man.v):
Пример
#(параметр N=4,
параметр M=4)
(
input clk,
input rstn,
input data_rdy ,
input [N-1:0] mult1,
input [M-1:0] mult2,
output res_rdy ,
output [N+M-1:0] res );
wire [N+M-1:0] mult1_t [M-1:0] ;
wire [M-1:0] mult2_t [M-1:0] ;
wire [N+M-1:0] mult1_acc_t [M-1:0] ;
wire [M-1:0] rdy_t ;
// Первое инстанцирование эквивалентно инициализации; оператор generate нельзя использовать
mult_cell #(.N(N), .M(M))
u_mult_step0
(
.clk (clk),
.rstn (rstn),
.en (data_rdy),
.mult1 ({{(M){1'b0}}, mult1}),
.mult2 (mult2),
.mult1_acci ({(N+M){1'b0}}),
//выход
.mult1_acco (mult1_acc_t[0]),
.mult2_shift (mult2_t[0]),
.mult1_o (mult1_t[0]),
.rdy (rdy_t[0]) );
// Множественные экземпляры модулей используют оператор generate
genvar i ;
generate
for(i=1; i<=M-1; i=i+1) begin: mult_stepx
mult_cell #(.N(N), .M(M))
u_mult_step
(
.clk (clk),
.rstn (rstn),
.en (rdy_t[i-1]),
.mult1 (mult1_t[i-1]),
.mult2 (mult2_t[i-1]),
// Предыдущий результат накопления используется в качестве входа для следующего накопления
.mult1_acci (mult1_acc_t[i-1]),
//выход
.mult1_acco (mult1_acc_t[i]),
.mult1_o (mult1_t[i]), // передача состояния сдвига множимого
.mult2_shift (mult2_t[i]), // передача состояния сдвига множителя
.rdy (rdy_t[i]) );
end
endgenerate
assign res_rdy = rdy_t[M-1];
assign res = mult1_acc_t[M-1];
endmodule
testbench
Добавьте следующее описание моделирования в тестбенч примера проектирования неконвейерного умножителя, чтобы получить результаты моделирования конвейерной операции умножения.
2 канала данных непрерывно и последовательно вводятся, и включён модуль самопроверки для автоматического определения правильности результатов умножения.
Пример
reg [N-1:0] mult1 ;
reg [M-1:0] mult2 ;
wire res_rdy ;
wire [N+M-1:0] res ;
//драйвер
initial begin
#55 ;
@(negedge clk ) ;
data_rdy = 1'b1 ;
mult1 = 25; mult2 = 5;
#10 ; mult1 = 16; mult2 = 10;
#10 ; mult1 = 10; mult2 = 4;
#10 ; mult1 = 15; mult2 = 7;
mult2 = 7; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 1; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 15; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 3; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 11; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 4; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 9; repeat(32) #10 mult1 = mult1 + 1 ;
end
// сдвиг входных данных для удобной последующей проверки
reg [N-1:0] mult1_ref [M-1:0];
reg [M-1:0] mult2_ref [M-1:0];
always @(posedge clk) begin
mult1_ref[0] <= mult1 ;
mult2_ref[0] <= mult2 ;
end
genvar i ;
generate
for(i=1; i<=M-1; i=i+1) begin
always @(posedge clk) begin
mult1_ref[i] <= mult1_ref[i-1];
mult2_ref[i] <= mult2_ref[i-1];
end
end
endgenerate
// самопроверка
reg error_flag ;
always @(posedge clk) begin
# 1 ;
if (mult1_ref[M-1] * mult2_ref[M-1] != res && res_rdy) begin
error_flag <= 1'b1 ;
end
else begin
error_flag <= 1'b0 ;
end
end
//создание экземпляра модуля
mult_man #(.N(N), .M(M))
u_mult
(
.clk (clk),
.rstn (rstn),
.data_rdy (data_rdy),
.mult1 (mult1),
.mult2 (mult2),
.res_rdy (res_rdy),
.res (res));
Результаты моделирования
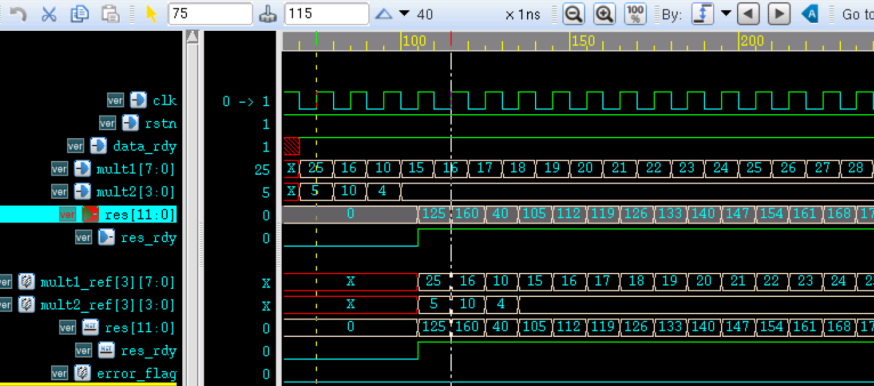
Результаты моделирования за первые несколько десятков тактовых циклов приведены ниже.
Как видно из рисунка, сигнал проверки результата моделирования error_flag остаётся равным 0, что указывает на правильность проектирования умножителя.
Данные непрерывно вводятся последовательно под управлением тактового сигнала. После задержки в 4 тактовых цикла результаты умножения также непрерывно выводятся на каждом тактовом цикле без дополнительной задержки, обеспечивая конвейерную работу.
По сравнению с обычными умножителями, не использующими конвейеризацию, эффективность умножения значительно повысилась.
Однако регистровых ресурсов конвейерный умножитель использует также примерно в 4 раза больше, чем предыдущий неконвейерный.
Таким образом, вопрос о том, применять ли в цифровом проекте конвейерную организацию, нужно рассматривать с точки зрения как ресурсов, так и эффективности.
Скачать исходный код
Скачать