Wie maschinelles Lernen funktioniert
Die Kernidee des maschinellen Lernens (ML) besteht darin, Computer dazu zu befähigen,aus Daten zu lernenund daraus Muster oder Regelmäßigkeiten abzuleiten, ohne sich auf explizit geschriebene Regeln oder Code zu verlassen.
Einfach ausgedrückt besteht der Workflow des maschinellen Lernens darin, Maschinen durch historische Daten ihre Entscheidungs- und Vorhersagefähigkeiten automatisch verbessern zu lassen.
Der Workflow des maschinellen Lernens lässt sich in die folgenden Schritte vereinfachen:
- Daten sammeln: Bereiten Sie Daten mit Merkmalen und Labels vor.
- Modell auswählen: Wählen Sie je nach Aufgabe einen geeigneten Algorithmus für maschinelles Lernen.
- Modell trainieren: Lassen Sie das Modell Muster aus Daten lernen und den Fehler minimieren.
- Bewerten und validieren: Bewerten Sie die Leistung des Modells anhand des Testsets und optimieren Sie es.
- Das Modell bereitstellen: Das trainierte Modell auf reale Szenarien zur Vorhersage anwenden.
- Kontinuierliche Verbesserung: Wenn neue Daten auftauchen, muss das Modell regelmäßig aktualisiert und optimiert werden.
Dieser Prozess ermöglicht es Computern, automatisch aus Erfahrung zu lernen und bei verschiedenen Aufgaben zunehmend genaue Vorhersagen zu treffen.
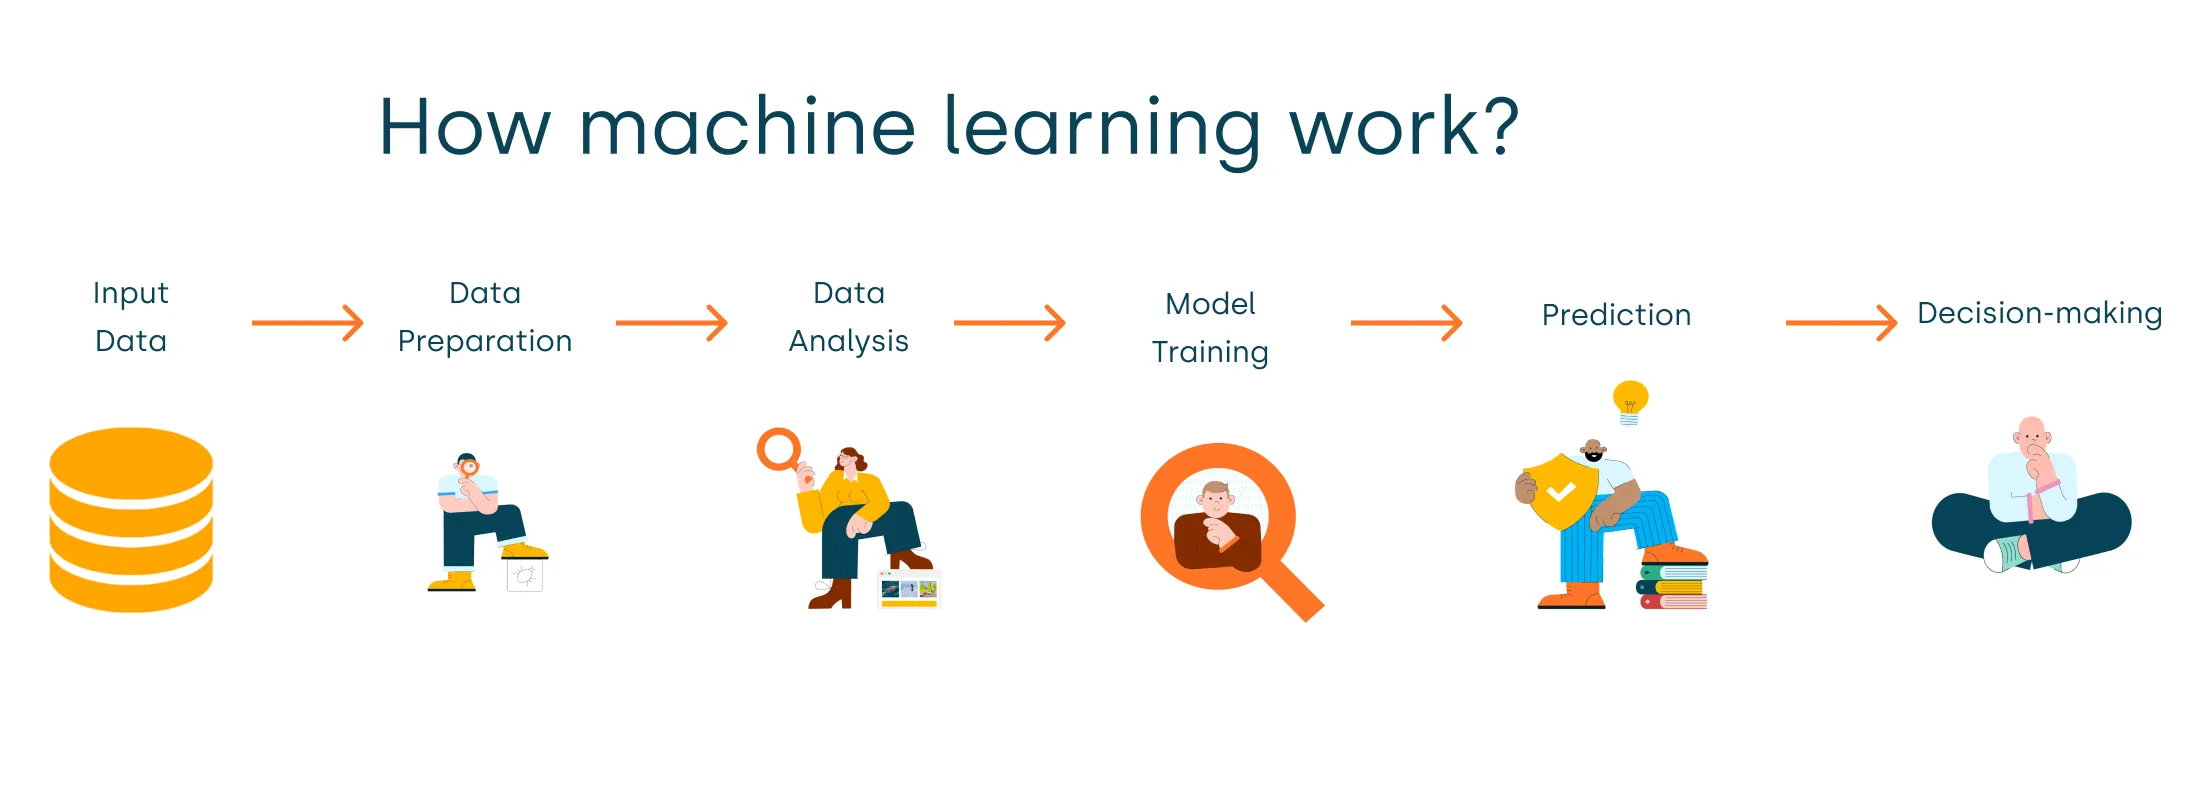
Wir können verstehen, wie maschinelles Lernen funktioniert, anhand der folgenden Aspekte:
1. Dateneingabe: Daten sind die Grundlage des Lernens
Der erste Schritt im maschinellen Lernen ist die Datenerfassung. Ohne Daten kann ein Modell für maschinelles Lernen nicht trainiert werden. Daten umfassen typischerweise "Eingabemerkmale" und "Labels":
-
Eingabemerkmale:Dies sind die Informationen, die das Modell für Vorhersage oder Klassifizierung verwendet. In einem Hauspreisvorhersageproblem können Eingabemerkmale beispielsweise die Fläche des Hauses, die Lage, die Anzahl der Schlafzimmer usw. sein.
-
Labels:Ein Label ist das Ergebnis, das wir vorhersagen oder klassifizieren möchten, normalerweise eine Zahl oder eine Kategorie. In einem Hauspreisvorhersageproblem ist das Label beispielsweise der Hauspreis.
Das Ziel eines Modells für maschinelles Lernen ist es, die Beziehung zwischen Eingabemerkmalen und Labels aus den Daten zu finden und auf Grundlage dieser Beziehungen Vorhersagen zu treffen.
2. Modellauswahl: Wählen Sie einen geeigneten Lernalgorithmus
Modelle für maschinelles Lernen (auch Algorithmen genannt) sind Werkzeuge, die Computern helfen, aus Daten zu lernen und Vorhersagen zu treffen. Je nach Art der Daten und der Aufgabe umfassen gängige Modelle für maschinelles Lernen:
-
Modelle für überwachtes Lernen:Wenn gelabelte Daten vorliegen, trifft das Modell Vorhersagen, indem es die Beziehung zwischen Eingaben und Labels lernt. Zum Beispiel:Lineare Regression、Logistische Regression、Support-Vektor-Maschine (SVM)undEntscheidungsbaum。
-
Unüberwachte Lernmodelle:Ohne beschriftete Daten lernt das Modell, indem es die Struktur oder Muster in den Daten untersucht. Zum BeispielK-means-Clustering、Hauptkomponentenanalyse (PCA)。
-
Modelle des bestärkenden Lernens:Das Modell lernt optimales Verhalten durch Belohnungen und Bestrafungen, während es mit der Umgebung interagiert. Zum BeispielQ-Learning、Deep Reinforcement Learning(Deep Q-Networks, DQN).
3. Trainingsprozess: Das Modell aus Daten lernen lassen
Während der Trainingsphase "lernt" das Modell die Beziehung zwischen Eingaben und Labels aus historischen Daten, typischerweise indem es eine Verlustfunktion minimiert, um die Parameter des Modells zu optimieren. Der Trainingsprozess lässt sich in den folgenden Schritten zusammenfassen:
-
Anfangszustand:Das Modell startet mit zufälligen Werten. Zum Beispiel werden die Gewichte eines neuronalen Netzwerks zufällig initialisiert.
-
Vorhersagen berechnen:Für jede Eingabe erstellt das Modell eine Vorhersage. Dies geschieht, indem die Eingabedaten an das Modell übergeben und die Ausgabe berechnet wird.
-
Den Fehler (Verlust) berechnen:Der Fehler ist die Differenz zwischen der vorhergesagten Ausgabe des Modells und dem tatsächlichen Label. Bei Regressionsproblemen kann der Fehler beispielsweise mit dem Mean Squared Error (MSE) gemessen werden.
-
Das Modell optimieren:Durch die Verwendung von Optimierungsalgorithmen wie Backpropagation (in neuronalen Netzwerken) oder Gradientenabstieg werden die Parameter des Modells (z. B. Gewichte neuronaler Netzwerke) kontinuierlich angepasst, um den Fehler zu minimieren. Dieser Prozess heißtTraining, bis das Modell relativ genaue Vorhersagen auf den Trainingsdaten treffen kann.
4. Validierung und Evaluierung: Die Leistung des Modells testen
Nach Abschluss des Trainingsprozesses müssen wir die Leistung des Modells bewerten. Um ein Overfitting des Modells an die Trainingsdaten zu vermeiden, teilen wir die Daten inTrainingssetundTestsetauf, wobei:
- Trainingsset:Der Teil der Daten, der zum Trainieren des Modells verwendet wird.
- Testset:Der Teil der Daten, der zur Bewertung der Leistung des Modells verwendet wird und normalerweise nicht am Trainingsprozess beteiligt ist.
Häufige Bewertungsmetriken sind:
- Genauigkeit:Der Anteil korrekter Klassifizierungen in einem Klassifikationsproblem.
- Mittlerer quadratischer Fehler (MSE):Der Durchschnitt der quadrierten Differenzen zwischen vorhergesagten Werten und wahren Werten in Regressionsproblemen.
- Präzision und Recall:Wird bei binären Klassifikationsproblemen verwendet, insbesondere wenn die Klassen unausgewogen sind.
- F1-Score:Das harmonische Mittel aus Präzision und Recall, das die Leistung des Klassifikators umfassend berücksichtigt.
5. Optimierung und Tuning: Die Genauigkeit des Modells verbessern
Wenn die Leistung des Modells auf dem Testset unzufriedenstellend ist, kann eine weitere Optimierung erforderlich sein. Dies umfasst normalerweise:
-
Hyperparameter abstimmen:Zum Beispiel Lernrate, Regularisierungskoeffizient, Baumtiefe usw. Diese Hyperparameter beeinflussen die Lernfähigkeit des Modells.
-
Modellauswahl und Ensemble:Verschiedene Modelle oder Modellensembles ausprobieren (z. B. Ensemble-Lernmethoden wie Random Forest, XGBoost usw.), um die Genauigkeit zu verbessern.
-
Daten-Augmentierung:Erweitern des Trainingsdatensatzes, zum Beispiel durch Operationen wie Drehen und Spiegeln von Bildern, um dem Modell zu helfen, die Generalisierung zu verbessern.
6. Modellbereitstellung und Vorhersage: Anwendung in der realen Welt
Sobald das Modell bei Trainings- und Testdaten gute Leistungen erbringt, kann es in realen Anwendungen eingesetzt werden:
-
Modellbereitstellung:Das trainierte Modell in Systeme wie Anwendungen, Websites, Server usw. einbetten, damit Benutzer es verwenden können.
-
Echtzeitvorhersage:In realen Umgebungen werden neue Daten in das Modell eingespeist, und das Modell trifft Echtzeitvorhersagen oder -klassifikationen basierend auf zuvor gelernten Mustern.
7. Kontinuierliches Lernen und Modellaktualisierung:
Systeme für maschinelles Lernen sind normalerweise nicht in einem Schritt abgeschlossen. In realen Anwendungen werden im Laufe der Zeit ständig neue Daten generiert, daher muss das Modell regelmäßig aktualisiert und neu trainiert werden, um seine Vorhersagefähigkeit zu erhalten. Dies kann erreicht werden durchOnline-Lernen、Transferlernenund andere Methoden.
Weitere Erweiterungen