Comment fonctionne l'apprentissage automatique
L'idée centrale de l'apprentissage automatique (ML) est de permettre aux ordinateurs d'apprendre à partir des donnéeset d'en déduire des motifs ou des régularités, sans dépendre de règles ou de code explicitement écrits.
En termes simples, le flux de travail de l'apprentissage automatique consiste à laisser les machines améliorer automatiquement leurs capacités de prise de décision et de prédiction grâce aux données historiques.
Le flux de travail de l'apprentissage automatique peut se résumer aux étapes suivantes :
- Collecter des données: Préparer des données contenant des caractéristiques et des étiquettes.
- Sélectionner un modèle: Choisir un algorithme d'apprentissage automatique approprié en fonction de la tâche.
- Entraîner le modèle: Laisser le modèle apprendre des motifs à partir des données et minimiser l'erreur.
- Évaluer et valider: Évaluer les performances du modèle à l'aide de l'ensemble de test, et l'optimiser.
- Déployer le modèle: Appliquer le modèle entraîné à des scénarios réels pour la prédiction.
- Amélioration continue: À mesure que de nouvelles données apparaissent, le modèle doit être régulièrement mis à jour et optimisé.
Ce processus permet aux ordinateurs d'apprendre automatiquement à partir de l'expérience et de faire des prédictions de plus en plus précises dans diverses tâches.
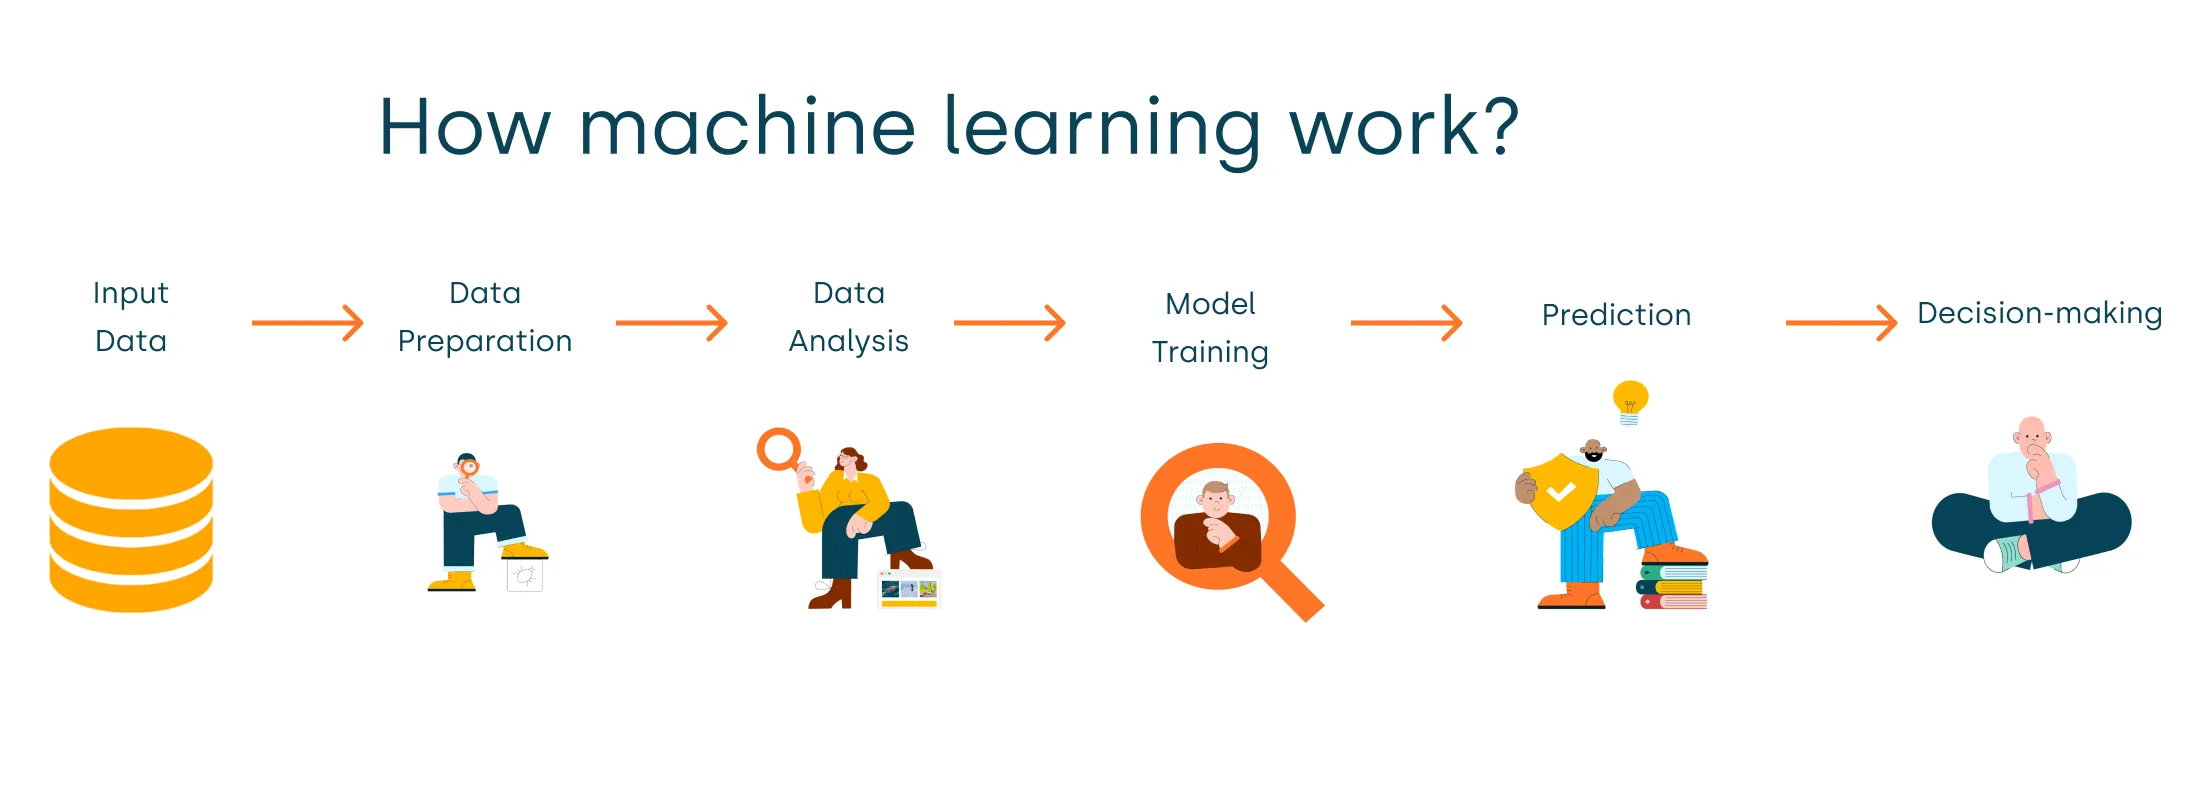
Nous pouvons comprendre le fonctionnement de l'apprentissage automatique à partir des aspects suivants :
1. Entrée des données : les données sont le fondement de l'apprentissage
La première étape de l'apprentissage automatique est la collecte de données. Sans données, un modèle d'apprentissage automatique ne peut pas être entraîné. Les données comprennent généralement « caractéristiques d'entrée » et « étiquettes » :
-
Caractéristiques d'entrée :Ce sont les informations que le modèle utilise pour la prédiction ou la classification. Par exemple, dans un problème de prédiction du prix d'une maison, les caractéristiques d'entrée peuvent être la surface de la maison, son emplacement, le nombre de chambres, etc.
-
Étiquettes :Une étiquette est le résultat que nous voulons prédire ou classer, généralement un nombre ou une catégorie. Par exemple, dans un problème de prédiction du prix d'une maison, l'étiquette est le prix de la maison.
L'objectif d'un modèle d'apprentissage automatique est de trouver la relation entre les caractéristiques d'entrée et les étiquettes à partir des données, et de faire des prédictions sur la base de ces relations.
2. Sélection du modèle : choisir un algorithme d'apprentissage approprié
Les modèles d'apprentissage automatique (également appelés algorithmes) sont des outils qui aident les ordinateurs à apprendre à partir de données et à faire des prédictions. Selon la nature des données et de la tâche, les modèles d'apprentissage automatique courants comprennent :
-
Modèles d'apprentissage supervisé :À partir de données étiquetées, le modèle fait des prédictions en apprenant la relation entre les entrées et les étiquettes. Par exemple,Régression linéaire、Régression logistique、Machine à vecteurs de support (SVM)etArbre de décision。
-
Modèles d'apprentissage non supervisé :Sans données étiquetées, le modèle apprend en explorant la structure ou les motifs des données. Par exemple,Partitionnement K-means、Analyse en composantes principales (ACP)。
-
Modèles d'apprentissage par renforcement :Le modèle apprend un comportement optimal grâce à des récompenses et des punitions en interagissant avec l'environnement. Par exemple,Q-learning、Apprentissage par renforcement profond(Réseaux Q profonds, DQN)。
3. Processus d'entraînement : laisser le modèle apprendre à partir des données
Pendant la phase d'entraînement, le modèle « apprend » la relation entre les entrées et les étiquettes à partir de données historiques, généralement en minimisant une fonction de perte pour optimiser les paramètres du modèle. Le processus d'entraînement peut être résumé dans les étapes suivantes :
-
État initial :Le modèle commence avec des valeurs aléatoires. Par exemple, les poids d'un réseau de neurones sont initialisés de manière aléatoire.
-
Calculer les prédictions :Pour chaque entrée, le modèle effectue une prédiction. Cela se fait en transmettant les données d'entrée au modèle et en calculant la sortie.
-
Calculer l'erreur (perte) :L'erreur est la différence entre la sortie prédite du modèle et l'étiquette réelle. Par exemple, pour les problèmes de régression, l'erreur peut être mesurée à l'aide de l'erreur quadratique moyenne (MSE).
-
Optimiser le modèle :En utilisant des algorithmes d'optimisation tels que la rétropropagation (dans les réseaux de neurones) ou la descente de gradient, les paramètres du modèle (par exemple, les poids du réseau de neurones) sont continuellement ajustés pour minimiser l'erreur. Ce processus est appeléentraînement, jusqu'à ce que le modèle puisse faire des prédictions relativement précises sur les données d'entraînement.
4. Validation et évaluation : tester les performances du modèle
Une fois le processus d'entraînement terminé, nous devons évaluer les performances du modèle. Pour éviter que le modèle ne surajuste les données d'entraînement, nous divisons les données enensemble d'entraînementetensemble de test, où :
- Ensemble d'entraînement :La partie des données utilisée pour entraîner le modèle.
- Ensemble de test :La partie des données utilisée pour évaluer les performances du modèle, généralement non impliquée dans le processus d'entraînement.
Les métriques d'évaluation courantes incluent :
- Exactitude :La proportion de classifications correctes dans un problème de classification.
- Erreur quadratique moyenne (MSE) :La moyenne des carrés des différences entre les valeurs prédites et les valeurs réelles dans les problèmes de régression.
- Précision et rappel :Utilisées dans les problèmes de classification binaire, en particulier lorsque les classes sont déséquilibrées.
- Score F1 :La moyenne harmonique de la précision et du rappel, prenant globalement en compte les performances du classifieur.
5. Optimisation et réglage : améliorer l'exactitude du modèle
Si les performances du modèle sur l'ensemble de test ne sont pas satisfaisantes, une optimisation supplémentaire peut être nécessaire. Cela inclut généralement :
-
Réglage des hyperparamètres :Par exemple, le taux d'apprentissage, le coefficient de régularisation, la profondeur de l'arbre, etc. Ces hyperparamètres influencent la capacité d'apprentissage du modèle.
-
Sélection et ensemble de modèles :Essayer différents modèles ou ensembles de modèles (comme les méthodes d'apprentissage ensembliste telles que Random Forest, XGBoost, etc.) pour améliorer l'exactitude.
-
Augmentation des données :Élargir l'ensemble de données d'entraînement, par exemple en effectuant des opérations comme la rotation et le retournement sur les images, pour aider le modèle à améliorer sa généralisation.
6. Déploiement et prédiction du modèle : application dans le monde réel
Une fois que le modèle offre de bonnes performances sur les données d'entraînement et de test, il peut être déployé dans des applications réelles :
-
Déploiement du modèle :Intégrer le modèle entraîné dans des systèmes tels que des applications, des sites web, des serveurs, etc., afin que les utilisateurs puissent l'utiliser.
-
Prédiction en temps réel :Dans des environnements réels, de nouvelles données sont fournies au modèle, et le modèle effectue des prédictions ou classifications en temps réel en se basant sur les motifs précédemment appris.
7. Apprentissage continu et mise à jour du modèle :
Les systèmes d'apprentissage automatique ne sont généralement pas achevés en une seule fois. Dans les applications réelles, au fil du temps, de nouvelles données sont constamment générées, donc le modèle doit être régulièrement mis à jour et réentraîné pour maintenir sa capacité de prédiction. Cela peut être réalisé grâce àl'apprentissage en ligne、l'apprentissage par transfertet d'autres méthodes.
Autres extensions