Машинное обучение и искусственный интеллект
Связь между искусственным интеллектом, машинным обучением и глубоким обучением
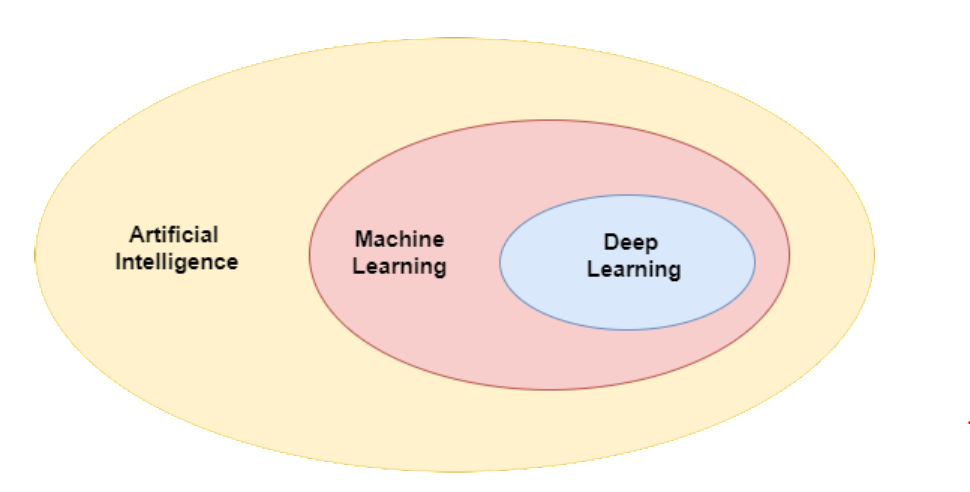
Представьте русскую матрёшку: большая кукла содержит среднюю куклу, а средняя кукла содержит маленькую куклу. Связь между искусственным интеллектом, машинным обучением и глубоким обучением точно такая же:
- Искусственный интеллект (ИИ): самая большая кукла, самое широкое понятие
- Машинное обучение (ML): средняя кукла, часть ИИ
- Глубокое обучение (DL): самая маленькая кукла, часть машинного обучения
Что такое искусственный интеллект (ИИ)?
Искусственный интеллект— это широкое понятие, которое относится к технологиям, позволяющим машинам демонстрировать интеллект, подобный человеческому. Подобно тому как человеческий интеллект включает такие способности, как рассуждение, обучение, восприятие и понимание языка, ИИ также пытается наделить машины этими возможностями.
Цели ИИ:
- Имитировать мыслительные процессы человека
- Решать задачи, для выполнения которых требуется человеческий интеллект
- Превосходят человеческие возможности в определённых областях
Примеры ИИ:
- Программы для игры в шахматы (такие как AlphaGo)
- Голосовые помощники (такие как Siri, Xiao Ai)
- Беспилотные автомобили
Место машинного обучения (ML) в ИИ
Машинное обучение— это один из методов достижения искусственного интеллекта, но не единственный. Подобно тому как есть несколько способов готовить (жарка, варка, приготовление на пару, запекание), существует также несколько подходов к реализации ИИ.
Характеристики машинного обучения:
- Не требует ручного написания всех правил
- Автоматически выявляет закономерности в данных
- Подходит для решения сложных задач, в которых правила трудно определить явно
Традиционный ИИ против машинного обучения:
| Традиционный подход к ИИ | Подход машинного обучения |
|---|---|
| Экспертные системы: правила, написанные вручную | Изучение правил на основе данных |
| Логическое рассуждение: на основе явных правил | Распознавание образов: поиск закономерностей в данных |
| Подходит для задач с чётко определёнными правилами | Подходит для сложных, неоднозначных задач |
Глубокое обучение (DL) и машинное обучение
Глубокое обучение— это раздел машинного обучения, который использует многослойные нейронные сети для изучения сложных закономерностей в данных.
Характеристики глубокого обучения:
- Использует многослойные нейронные сети («deep» означает множество слоёв)
- Особенно подходит для обработки неструктурированных данных, таких как изображения, аудио и текст
- Требует больших объёмов данных и вычислительных ресурсов
История развития и эволюция
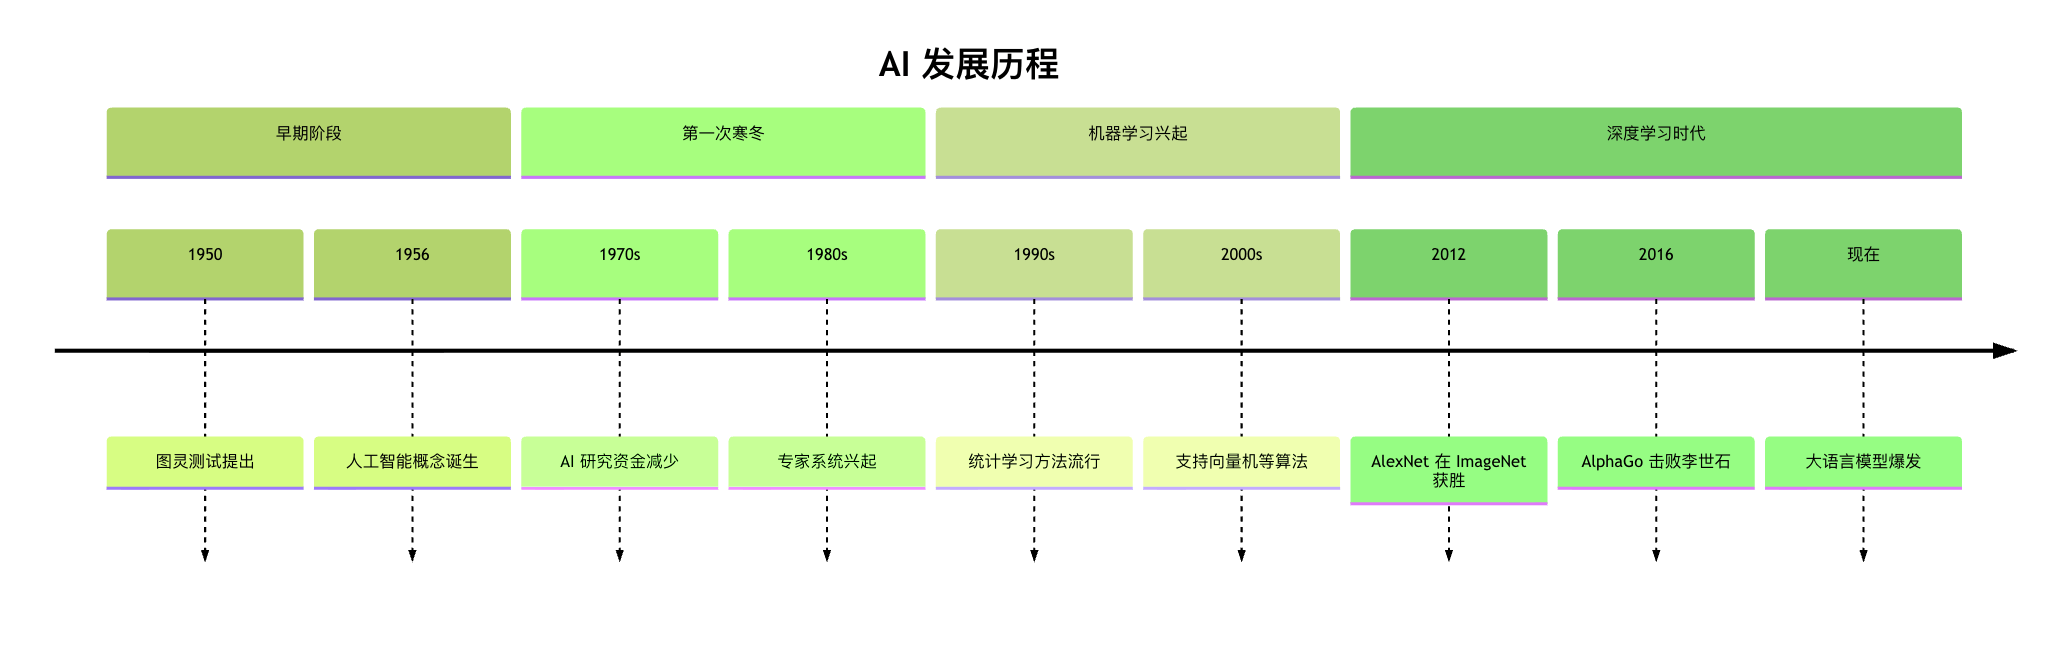
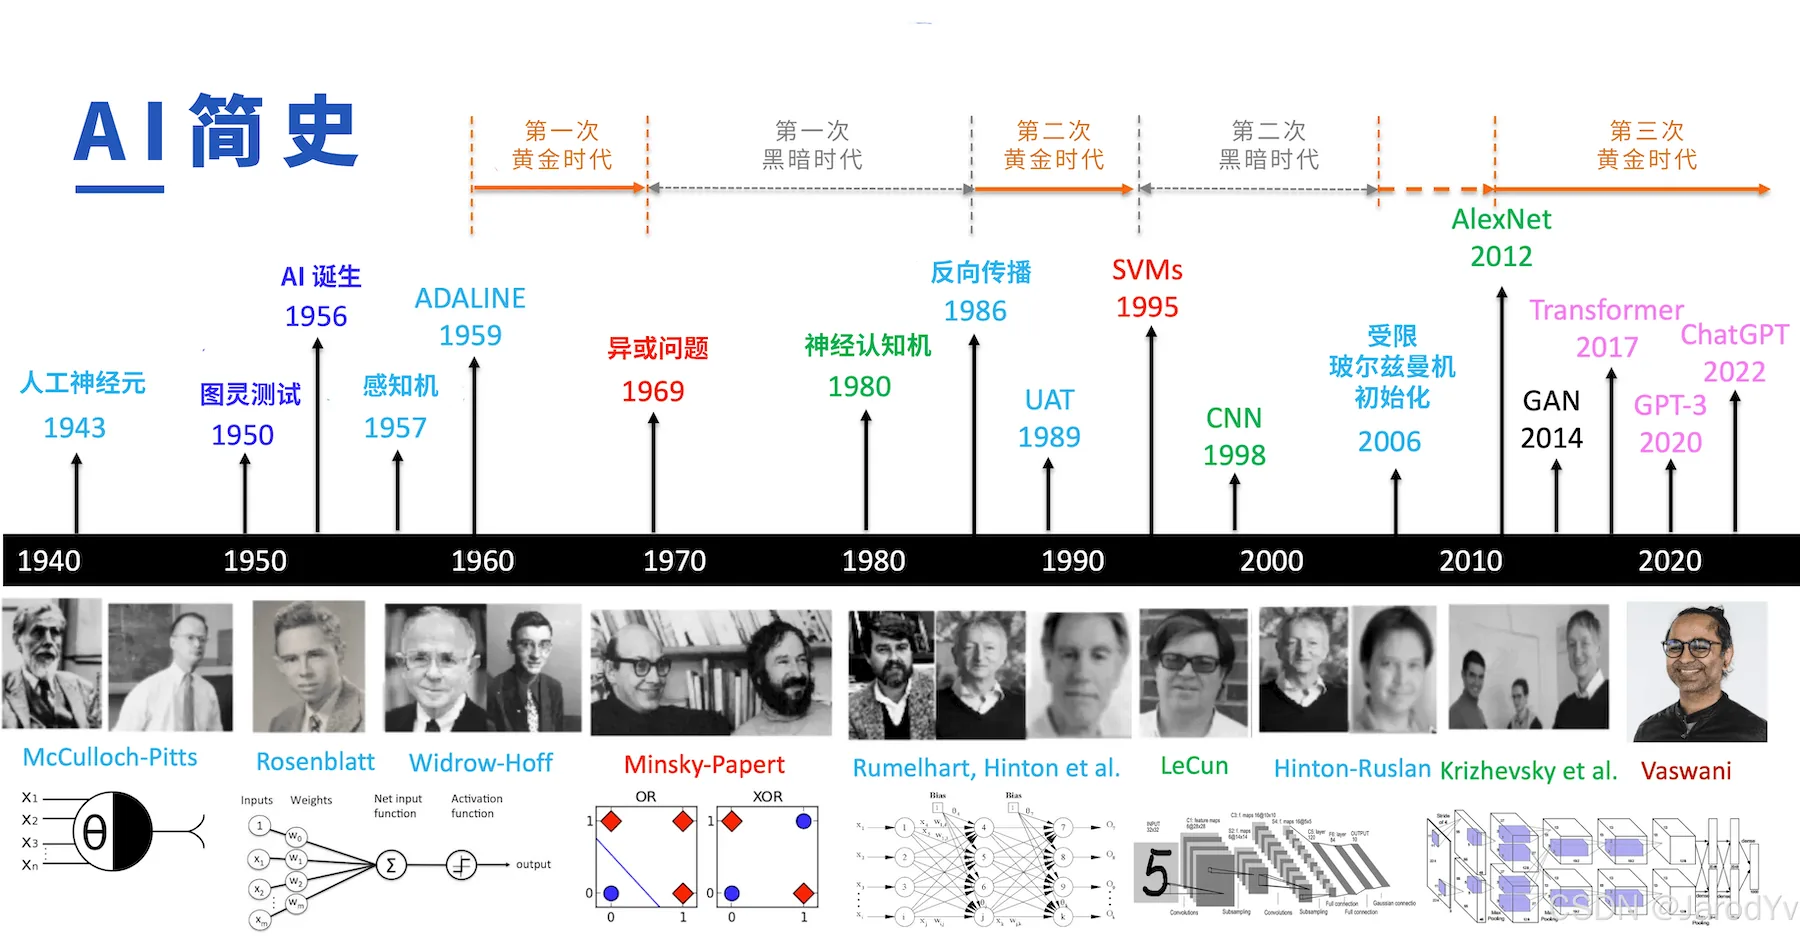
- Ранний ИИ (1950-е–1970-е): в основном полагался на вручную написанные правила и логические рассуждения
- Подъём машинного обучения (1980-е–2000-е): началось обучение на данных, но признаки требовали ручного проектирования
- Эпоха глубокого обучения (2010-е–настоящее время): автоматически изучает признаки, справляется с более сложными задачами
Пример
Давайте рассмотрим простой пример, демонстрирующий различия между традиционными методами, машинным обучением и глубоким обучением — попытка распознать рукописные цифры.
Метод 1: традиционный подход (на основе правил)
Пример
# Это только концептуальный пример; на практике этот метод работает очень плохо
def recognize_digit_by_rules(image):
"""
Распознавание цифр на основе ручных правил (упрощённый пример)
"""
# Правило 1: Подсчитать количество чёрных пикселей на изображении
black_pixels = count_black_pixels(image)
# Правило 2: Вычислить положение центроида изображения
center_x, center_y = calculate_center(image)
# Правило 3: Обнаружить определённые особенности формы
has_circle = detect_circle(image)
has_straight_line = detect_straight_line(image)
# Суждение на основе правил
if has_circle and black_pixels < 50:
return "0"
elif has_straight_line and center_y < image_height/2:
return "7"
# ... дополнительные правила
else:
return "Невозможно распознать"
# Проблема: правила с трудом охватывают все случаи, и они очень хрупкие
Метод 2: подход машинного обучения
Пример
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score
# 1. Ручное проектирование признаков (это ограничение традиционного машинного обучения)
def extract_features(image):
"""
Признаки, спроектированные вручную
"""
features = []
# Признак 1: доля чёрных пикселей
features.append(count_black_pixels(image) / total_pixels)
# Признак 2: центроид изображения
center_x, center_y = calculate_center(image)
features.extend([center_x, center_y])
# Признак 3: плотность краёв
features.append(calculate_edge_density(image))
# ... ещё признаки, разработанные вручную
return features
# 2. Извлечение признаков из всех обучающих данных
X_train = [extract_features(img) for img in train_images]
y_train = train_labels
# 3. Обучение модели
model = RandomForestClassifier(n_estimators=100)
model.fit(X_train, y_train)
# 4. Тестирование
X_test = [extract_features(img) for img in test_images]
predictions = model.predict(X_test)
print(f"Точность: {accuracy_score(test_labels, predictions):.2f}")
Метод 3: подход глубокого обучения
Пример
import tensorflow as tf
from tensorflow.keras import layers, models
# 1. Построить нейронную сеть
model = models.Sequential([
# Автоматически изучает низкоуровневые признаки (края, текстуры и т. д.)
layers.Conv2D(32, (3, 3), activation='relu', input_shape=(28, 28, 1)),
layers.MaxPooling2D((2, 2)),
# Автоматически изучает признаки среднего уровня (формы, комбинации и т. д.)
layers.Conv2D(64, (3, 3), activation='relu'),
layers.MaxPooling2D((2, 2)),
# Автоматически изучает высокоуровневые признаки (общие закономерности)
layers.Conv2D(64, (3, 3), activation='relu'),
# Слой классификации
layers.Flatten(),
layers.Dense(64, activation='relu'),
layers.Dense(10, activation='softmax') # 10 категорий цифр
])
# 2. Скомпилировать модель
model.compile(optimizer='adam',
loss='sparse_categorical_crossentropy',
metrics=['accuracy'])
# 3. Обучать напрямую на необработанных данных изображений (не нужно вручную создавать признаки)
model.fit(train_images, train_labels, epochs=5,
validation_data=(test_images, test_labels))
# 4. Оценка
test_loss, test_acc = model.evaluate(test_images, test_labels)
print(f"Точность модели глубокого обучения: {test_acc:.2f}")
Сравнение результатов выполнения:
- Традиционный метод: точность около 60-70% (и сложные правила)
- Машинное обучение: точность около 85-92% (требует вручную созданных признаков)
- Глубокое обучение: точность около 98-99% (автоматически изучает признаки)