Schlüsselwörter: Pipeline, Multiplizierer
Ein herausragender Vorteil von Hardwarebeschreibungssprachen ist die Parallelität der Befehlsausführung. Mehrere Anweisungen können mehrere Signaldaten parallel innerhalb desselben Taktzyklus verarbeiten.
Wenn Daten jedoch seriell eingegeben werden, zeigt die Parallelität der Befehlsausführung ihren Vorteil nicht. Darüber hinaus können in vielen Fällen einige Berechnungen nicht innerhalb von ein oder zwei Taktzyklen abgeschlossen werden. Wenn jedes seriell eingegebene Datum warten muss, bis die vorherige Berechnung abgeschlossen ist, bevor die nächste Berechnung beginnt, ist die Effizienz recht niedrig. Pipelining ist die Lösung für die geringe Effizienz serieller Datenberechnung bei mehreren Zyklen.
Pipeline
Die Grundidee des Pipelining besteht darin, einen wiederholten Prozess in mehrere Teilprozesse zu zerlegen, die jeweils von einer dedizierten Funktionseinheit implementiert werden. Mehrere Verarbeitungsprozesse sind zeitlich versetzt und durchlaufen die Funktionsstufen nacheinander, sodass jeder Teilprozess parallel zu anderen Teilprozessen ausgeführt werden kann.
Angenommen, der Prozess des Wäschewaschens in einem Waschsalon ist in 4 Phasen unterteilt: Wäsche sammeln, waschen, trocknen und in Schränke packen. Jede Phase dauert eine halbe Stunde, sodass das Waschen einer Ladung Wäsche 2 Stunden dauert.
Betrachten Sie den Worst Case: Der Waschsalon hat nur eine Waschmaschine, einen Trockner und einen Schrank. Wenn jede halbe Stunde eine Charge Kleidung angeliefert wird und Sie jedes Mal 2 Stunden warten müssen, bis die vorherige Charge fertig gewaschen ist, dann dauert das Waschen von 4 Chargen Kleidung 8 Stunden.
Das Diagramm sieht wie folgt aus:

Rüsten Sie die Ausstattung dieses Waschsalons auf, indem Sie insgesamt 4 Sätze Wäscheausrüstung einführen und das Personal auf 4 Personen erhöhen, wobei jede für eine Stufe des Wäscheprozesses verantwortlich ist. Daher kann jede Charge Kleidung von derselben Person zügig in verschiedene Waschmaschinen gegeben werden. Da die Zeitpunkte versetzt sind, kann jede Charge Kleidung von denselben Personen mit unterschiedlichen Geräten und in unterschiedlichen Zeitfenstern (einer halben Stunde) gewaschen, getrocknet und in Schränke verpackt werden. Das Diagramm sieht wie folgt aus.

Es ist zu sehen, dass das Waschen von 4 Chargen Kleidung nur 3.5 Stunden dauert, was die Effizienz deutlich verbessert.
Tatsächlich ist der erste Satz Wäscheausrüstung nach 2 Stunden mit dem Waschprozess fertig und steht still. Wenn zu diesem Zeitpunkt eine 5. Charge Kleidung eingegeben wird, kann der erste Satz Ausrüstung wieder mit der Arbeit beginnen. Analog dazu können die 4 Sätze Wäscheausrüstung, solange kontinuierlich Kleidungschargen eingegeben werden, den Reinigungsprozess für alle Kleidung kontinuierlich abschließen. Mit Ausnahme der ersten Charge, die 2 Stunden dauert, wird danach alle halbe Stunde eine Charge Kleidung gewaschen und abgeschlossen.
Je mehr Chargen Kleidung es gibt, desto deutlicher ist die eingesparte Zeit. Wenn es N Chargen Kleidung gibt, beträgt die benötigte Zeit (4+N) halbe Stunden.
Natürlich hat der aufgerüstete Wäscheprozess auch Nachteile. Die Zunahme von Ausrüstung und Personal erhöht die Investitionskosten, verringert den verbleibenden Platz im Waschsalon und lässt den Arbeitszustand beschäftigter erscheinen.
Ähnlich wie beim Waschprozess kann auch der Datenverarbeitungspfad als Produktionslinie betrachtet werden. Jede digitale Verarbeitungseinheit auf dem Pfad kann als eine Stufe betrachtet werden, die Verzögerung einführt.
Das Pipeline-Design unterteilt den Pfad systematisch in digitale Verarbeitungseinheiten (Stufen) und fügt Register zwischen den Verarbeitungseinheiten ein, um Zwischendaten vorübergehend zu speichern. Die unterteilten Einheiten können stufenweise parallel ausgeführt werden, ohne sich gegenseitig zu beeinflussen. Daher kann das Pipeline-Design letztendlich den Datendurchsatz verbessern, das heißt, die Datenverarbeitungsgeschwindigkeit erhöhen.
Der Nachteil des Pipeline-Designs besteht darin, dass jede Verarbeitungsstufe zusätzliche Register benötigt, um Zwischenberechnungszustände zu speichern, und mehrere parallel ausgeführte Befehle zwangsläufig den Stromverbrauch erhöhen.
Als Nächstes wird ein Multiplizierer entworfen und ein Vergleich zwischen der Verwendung und Nichtverwendung des Pipeline-Designs angestellt.
Allgemeines Multiplizierer-Design
Einführung
Vielleicht wird sich jemand fragen: Ist es nicht schneller und einfacher, direkt das Multiplikationszeichen*zu verwenden, um zwei Zahlen zu multiplizieren?
Wenn Sie diesen Zweifel haben, bedeutet das, dass Ihr Verständnis von Hardwarebeschreibungssprachen noch unzureichend ist. Wie bereits erwähnt, beschreibt Verilog Hardware-Schaltungen. Wenn das Multiplikationszeichen direkt verwendet wird, um den Multiplikationsvorgang durchzuführen, bildet der Compiler diesen Multiplikationsausdruck während der Kompilierung auf einen Standard-Multiplizierer ab, dessen Struktur jedoch unbekannt ist.
Zum Beispiel kann im FPGA-Design ein IP-Core direkt aufgerufen werden, um einen Hochleistungs-Multiplizierer zu erzeugen. Bei kleiner Bitbreite kann das Ergebnis innerhalb eines Zyklus ausgegeben werden; bei großer Bitbreite kann es ebenfalls auf Pipeline-Weise ausgegeben werden. Unter der Voraussetzung, dass die Anforderungen erfüllt werden können, können Sie vorsichtig verwenden*oder direkt das IP aufrufen, um die Multiplikationsoperation durchzuführen.
Aber Multiplizierer-IP hat auch viele Mängel, wie Bitbreitenbeschränkungen, unbekanntes Timing usw. Insbesondere die Verwendung des Multiplikationszeichens kann für die Unsicherheit des digitalen Designs eine große versteckte Gefahr bergen.
In vielen Fällen wird die Multiplikation mit Konstanten in Form von Verschieben und Addieren implementiert, zum Beispiel:
Beispiel
A = (A<<1) + A ; // entspricht A * 3
A = (A<<3) + (A<<2) + (A<<1) + A ; // entspricht A * 15
Ein Schieberegister und ein Addierer können die Operation der Multiplikation mit 3 abschließen. Die Multiplikation mit 15 erfordert jedoch 3 Schieberegister und 3 Addierer (natürlich kann die Multiplikation mit 15 auch durch Verschieben und Subtrahieren erfolgen).
Manchmal kann eine digitale Schaltung die Addition mehrerer Variablen nicht gleichzeitig innerhalb eines Zyklus abschließen. Daher ist in der Digitaltechnik die sicherste Additionsoperation, nur 2 Datenwerte gleichzeitig zu addieren; das schlechteste Design ist, 4 oder mehr Datenwerte gleichzeitig zu addieren.
Wenn das Design eine Operation enthält, die 4 Datenwerte gleichzeitig addiert, dann ist dieser Teil des Designs gefährlich und kann Timing-Verletzungen verursachen.
An diesem Punkt wird ein Pipeline-Multiplizierer mit konfigurierbaren Entwurfsparametern und steuerbarem Timing erforderlich.
Entwurfsprinzip
Ähnlich wie bei der Dezimalmultiplikation ist der Prozess der Multiplikation von 13 und 5 unten dargestellt:
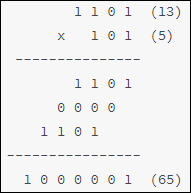
Daraus ist ersichtlich, dass der Multiplikand entsprechend dem entsprechenden Bit des Multiplikators verschoben und akkumuliert wird, wodurch der Multiplikationsprozess abgeschlossen wird.
Unter der Annahme, dass pro Zyklus nur eine Akkumulation abgeschlossen werden kann, entspricht die minimale Anzahl an Taktzyklen für eine Multiplikation genau der Bitbreite des Multiplikators. Daher wird empfohlen, die Zahl mit der kleineren Bitbreite als Multiplikator zu verwenden, wodurch die Berechnungsdauer kürzer ist.
Multiplizierer-Entwurf
In Anbetracht dessen, dass jede Multiplikationsoperation nur ein Ergebnis ausgeben kann (nicht gepipelinetes Design), lautet der Designcode wie folgt.
Beispiel
#(Parameter N=4,
Parameter M=4)
(
input clk,
input rstn,
input data_rdy , // Dateneingabe-Freigabe
input [N-1:0] mult1, // Multiplikand
input [M-1:0] mult2, // Multiplikator
output res_rdy , // Datenausgabe-Freigabe
output [N+M-1:0] res // Multiplikationsergebnis
);
// Zähler berechnen
reg [31:0] cnt ;
// Zähler für Multiplikationszyklen
wire [31:0] cnt_temp = (cnt == M)? 'b0 : cnt + 1'b1 ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
cnt <= 'b0 ;
end
else if (data_rdy) begin // Zählung starten, wenn Daten aktiviert sind
cnt <= cnt_temp ;
end
else if (cnt != 0 ) begin // verhindern, dass die Eingangsfreigabedauer zu kurz ist
cnt <= cnt_temp ;
end
else begin
cnt <= 'b0 ;
end
end
//multiplizieren
reg [M-1:0] mult2_shift ;
reg [M+N-1:0] mult1_shift ;
reg [M+N-1:0] mult1_acc ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
mult2_shift <= 'b0 ;
mult1_shift <= 'b0 ;
mult1_acc <= 'b0 ;
end
else if (data_rdy && cnt=='b0) begin // Initialisierung
mult1_shift <= {{(N){1'b0}}, mult1} << 1 ;
mult2_shift <= mult2 >> 1 ;
mult1_acc <= mult2[0] ? {{(N){1'b0}}, mult1} : 'b0 ;
end
else if (cnt != M) begin
mult1_shift <= mult1_shift << 1 ; // Multiplikand mit 2 multipliziert
mult2_shift <= mult2_shift >> 1 ; // Multiplikator nach rechts verschieben, um die Beurteilung zu erleichtern
// prüfen, ob das entsprechende Bit des Multiplikators 1 ist; falls 1, akkumulieren
mult1_acc <= mult2_shift[0] ? mult1_acc + mult1_shift : mult1_acc ;
end
else begin
mult2_shift <= 'b0 ;
mult1_shift <= 'b0 ;
mult1_acc <= 'b0 ;
end
end
// Ergebnisse
reg [M+N-1:0] res_r ;
reg res_rdy_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
res_r <= 'b0 ;
res_rdy_r <= 'b0 ;
end
else if (cnt == M) begin
res_r <= mult1_acc ; // das Ergebnis am Ende der Multiplikationszyklen ausgeben
res_rdy_r <= 1'b1 ;
end
else begin
res_r <= 'b0 ;
res_rdy_r <= 'b0 ;
end
end
assign res_rdy = res_rdy_r;
assign res = res_r;
endmodule
testbench
Beispiel
module test ;
Parameter N = 8 ;
Parameter M = 4 ;
reg clk, rstn;
//Takt
always begin
clk = 0 ; #5 ;
clk = 1 ; #5 ;
end
// Zurücksetzen
initial begin
rstn = 1'b0 ;
#8 ; rstn = 1'b1 ;
end
// keine Pipeline
reg data_rdy_low ;
reg [N-1:0] mult1_low ;
reg [M-1:0] mult2_low ;
wire [M+N-1:0] res_low ;
wire res_rdy_low ;
// eine Task für periodischen Stimulus verwenden
task mult_data_in ;
input [M+N-1:0] mult1_task, mult2_task ;
begin
wait(!test.u_mult_low.res_rdy) ; //nicht Ausgabezustand
@(negedge clk ) ;
data_rdy_low = 1'b1 ;
mult1_low = mult1_task ;
mult2_low = mult2_task ;
@(negedge clk ) ;
data_rdy_low = 1'b0 ;
wait(test.u_mult_low.res_rdy) ; //den Ausgabezustand testen
end
endtask
//Treiber
initial begin
#55 ;
mult_data_in(25, 5 ) ;
mult_data_in(16, 10 ) ;
mult_data_in(10, 4 ) ;
mult_data_in(15, 7) ;
mult_data_in(215, 9) ;
end
mult_low #(.N(N), .M(M))
u_mult_low
(
.clk (clk),
.rstn (rstn),
.data_rdy (data_rdy_low),
.mult1 (mult1_low),
.mult2 (mult2_low),
.res_rdy (res_rdy_low),
.res (res_low));
//Simulationsende
initial begin
forever begin
#100;
if ($time >= 10000) $finish ;
end
end
endmodule // test
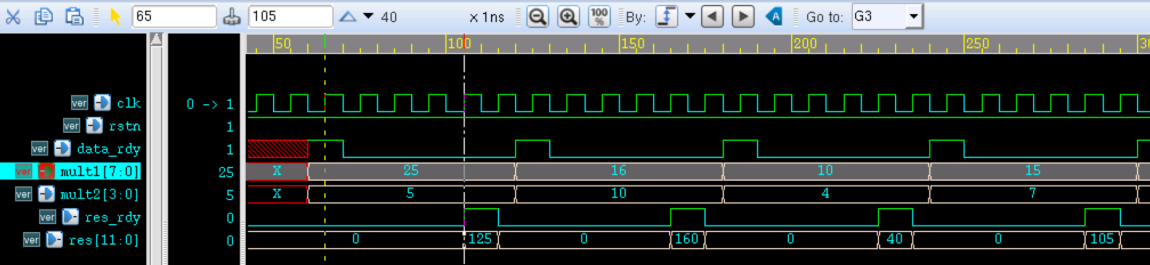
Die Simulationsergebnisse sind wie folgt.
Wie aus der Abbildung ersichtlich ist, erhalten die beiden Eingabedaten nach einer Verzögerung von 4 Zyklen das korrekte Multiplikationsergebnis. Einschließlich der Verzögerungszeit der Zwischendaten-Eingabe dauert die Berechnung von 4 Multiplikationen etwa 20 Taktzyklen.
Design eines Pipeline-Multiplizierers
Als Nächstes werden die Zwischenzustände des Multiplikationsausführungsprozesses gespeichert, um den Pipeline-Betrieb zu ermöglichen. Der Entwurfscode lautet wie folgt.
Die Codedatei für einen einzelnen Akkumulationsberechnungsvorgang lautet wie folgt (mult_cell.v):
Beispiel
#(Parameter N=4,
Parameter M=4)
(
input clk,
input rstn,
input en,
input [M+N-1:0] mult1, // Multiplikand
input [M-1:0] mult2, // Multiplikator
input [M+N-1:0] mult1_acci, // vorheriges Akkumulationsergebnis
output reg [M+N-1:0] mult1_o, // gespeicherter Wert nach Verschiebung des Multiplikanden
output reg [M-1:0] mult2_shift, // gespeicherter Wert nach Verschiebung des Multiplikators
output reg [N+M-1:0] mult1_acco, // aktuelles Akkumulationsergebnis
output reg rdy );
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
rdy <= 'b0 ;
mult1_o <= 'b0 ;
mult1_acco <= 'b0 ;
mult2_shift <= 'b0 ;
end
else if (en) begin
rdy <= 1'b1 ;
mult2_shift <= mult2 >> 1 ;
mult1_o <= mult1 << 1 ;
if (mult2[0]) begin
// akkumulieren, wenn das entsprechende Bit des Multiplikators 1 ist
mult1_acco <= mult1_acci + mult1 ;
end
else begin
mult1_acco <= mult1_acci ; // beibehalten, wenn das entsprechende Bit des Multiplikators 1 ist
end
end
else begin
rdy <= 'b0 ;
mult1_o <= 'b0 ;
mult1_acco <= 'b0 ;
mult2_shift <= 'b0 ;
end
end
endmodule
Top-Level-Instanziierung
Mehrere Modulinstanziierungen führen mehrere Akkumulationen aus. Die Codedatei ist wie folgt (mult_man.v):
Beispiel
#(Parameter N=4,
Parameter M=4)
(
input clk,
input rstn,
input data_rdy ,
input [N-1:0] mult1,
input [M-1:0] mult2,
output res_rdy ,
output [N+M-1:0] res );
wire [N+M-1:0] mult1_t [M-1:0] ;
wire [M-1:0] mult2_t [M-1:0] ;
wire [N+M-1:0] mult1_acc_t [M-1:0] ;
wire [M-1:0] rdy_t ;
// Die erste Instanziierung entspricht einer Initialisierung; die generate-Anweisung kann nicht verwendet werden
mult_cell #(.N(N), .M(M))
u_mult_step0
(
.clk (clk),
.rstn (rstn),
.en (data_rdy),
.mult1 ({{(M){1'b0}}, mult1}),
.mult2 (mult2),
.mult1_acci ({(N+M){1'b0}}),
//Ausgabe
.mult1_acco (mult1_acc_t[0]),
.mult2_shift (mult2_t[0]),
.mult1_o (mult1_t[0]),
.rdy (rdy_t[0]) );
// Mehrere Modulinstanziierungen verwenden die generate-Anweisung
genvar i ;
generate
for(i=1; i<=M-1; i=i+1) begin: mult_stepx
mult_cell #(.N(N), .M(M))
u_mult_step
(
.clk (clk),
.rstn (rstn),
.en (rdy_t[i-1]),
.mult1 (mult1_t[i-1]),
.mult2 (mult2_t[i-1]),
// Das vorherige Akkumulationsergebnis wird als Eingabe für die nächste Akkumulation verwendet
.mult1_acci (mult1_acc_t[i-1]),
//Ausgabe
.mult1_acco (mult1_acc_t[i]),
.mult1_o (mult1_t[i]), // Zustandsübertragung der Multiplikandenverschiebung
.mult2_shift (mult2_t[i]), // Zustandsübertragung der Multiplikatorverschiebung
.rdy (rdy_t[i]) );
end
endgenerate
assign res_rdy = rdy_t[M-1];
assign res = mult1_acc_t[M-1];
endmodule
testbench
Fügen Sie die folgende Simulationsbeschreibung zum Testbench des nicht gepipelineten Multiplizierer-Designbeispiels hinzu, um die Simulationsergebnisse der gepipelineten Multiplikationsoperation zu erhalten.
Die 2 Datenkanäle werden kontinuierlich und seriell eingegeben, und ein selbstprüfendes Modul ist enthalten, um die Korrektheit der Multiplikationsergebnisse automatisch zu ermitteln.
Beispiel
reg [N-1:0] mult1 ;
reg [M-1:0] mult2 ;
wire res_rdy ;
wire [N+M-1:0] res ;
//Treiber
initial begin
#55 ;
@(negedge clk ) ;
data_rdy = 1'b1 ;
mult1 = 25; mult2 = 5;
#10 ; mult1 = 16; mult2 = 10;
#10 ; mult1 = 10; mult2 = 4;
#10 ; mult1 = 15; mult2 = 7;
mult2 = 7; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 1; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 15; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 3; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 11; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 4; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 9; repeat(32) #10 mult1 = mult1 + 1 ;
end
// Eingabedaten für eine bequeme spätere Überprüfung verschieben
reg [N-1:0] mult1_ref [M-1:0];
reg [M-1:0] mult2_ref [M-1:0];
always @(posedge clk) begin
mult1_ref[0] <= mult1 ;
mult2_ref[0] <= mult2 ;
end
genvar i ;
generate
for(i=1; i<=M-1; i=i+1) begin
always @(posedge clk) begin
mult1_ref[i] <= mult1_ref[i-1];
mult2_ref[i] <= mult2_ref[i-1];
end
end
endgenerate
// Selbstprüfung
reg error_flag ;
always @(posedge clk) begin
# 1 ;
if (mult1_ref[M-1] * mult2_ref[M-1] != res && res_rdy) begin
error_flag <= 1'b1 ;
end
else begin
error_flag <= 1'b0 ;
end
end
//Modulinstanziierung
mult_man #(.N(N), .M(M))
u_mult
(
.clk (clk),
.rstn (rstn),
.data_rdy (data_rdy),
.mult1 (mult1),
.mult2 (mult2),
.res_rdy (res_rdy),
.res (res));
Simulationsergebnisse
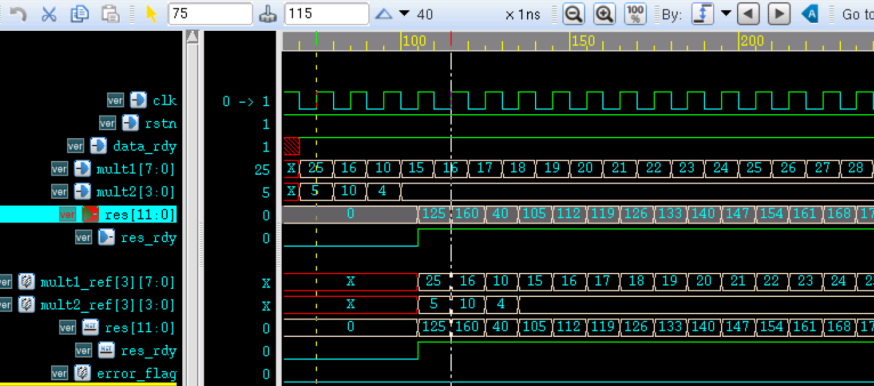
Die Simulationsergebnisse der ersten paar Dutzend Taktzyklen sind wie folgt.
Wie aus der Abbildung ersichtlich ist, bleibt das Prüfsignal des Simulationsergebnisses error_flag auf 0, was anzeigt, dass das Multiplizierer-Design korrekt ist.
Daten werden unter Taktsteuerung kontinuierlich seriell eingegeben. Nach einer Verzögerung von 4 Taktzyklen werden auch die Multiplikationsausgabeergebnisse kontinuierlich in jedem Taktzyklus ohne zusätzliche Verzögerung ausgegeben, wodurch ein Pipeline-Betrieb realisiert wird.
Im Vergleich zu allgemeinen Multiplizierern, die keine Pipelines verwenden, wurde die Multiplikationseffizienz stark verbessert.
Die vom Pipeline-Multiplizierer verwendeten Registerressourcen sind jedoch auch etwa 4-mal so groß wie die des vorherigen nicht gepipelineten.
Daher muss bei einem digitalen Entwurf, ob ein Pipeline-Design verwendet wird, sowohl hinsichtlich der Ressourcen als auch der Effizienz abgewogen werden.
Quellcode-Download
Herunterladen