Zufallszahlen
In Verilog wird die Systemaufgabe $random(seed) zum Erzeugen von Zufallszahlen verwendet, wobei seed der Startwert für die Zufallszahl ist.
Unterschiedliche Seed-Werte erzeugen unterschiedliche Zufallszahlen. Wenn der Seed derselbe ist, sind auch die erzeugten Zufallszahlen dieselben.
Sie können seed einen Anfangswert zuweisen oder die seed-Option weglassen; der Standard-Anfangswert von seed ist 0.
Der folgende Code zeigt, wie man $random ohne Verwendung der seed-Option aufruft und wie man den Seed angibt und ändert:
Beispiel
integer seed ;
initial begin
seed = 2 ;
#30 ;
seed = 10 ;
end
//kein Seed
reg [15:0] randnum_noseed ;
always@(posedge clk) begin
randnum_noseed <= $random(); // Ohne Angabe des Zufallsseeds
end
//mit Seed
reg [15:0] randnum_wtseed ;
always@(posedge clk) begin
randnum_wtseed <= $random(seed); // Zufallsseed angeben
end
Die Simulationswellenform ist wie folgt.
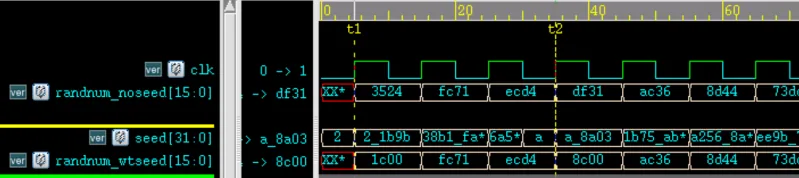
Unabhängig davon, ob ein Anfangswert zugewiesen wird, ändert sich jedes Mal, wenn eine Zufallszahl erzeugt wird, der Seed-Wert, und die Zufallszahl ändert sich entsprechend.
Jedes Mal, wenn der Seed-Wert geändert wird, ändert sich der aktuell ausgegebene Zufallswert; im nächsten Zustand kehrt der Trend der Zufallszahl jedoch zur internen, vom System erzeugten Zufallssequenz zurück.
Zum Beispiel sind im Simulationsdiagramm zu den Zeitpunkten t1 und t2 die Zufallsseeds unterschiedlich, sodass auch die erzeugten Zufallszahlen unterschiedlich sind. In anderen Taktzyklen sind die erzeugten Zufallszahlen jedoch gleich.
Es wird empfohlen, beim Aufruf der Systemtask $random die Seed-Option nicht anzugeben oder, wenn die Seed-Option angegeben wird, eine Variable zur Parameterübergabe zu verwenden.
Es wird nicht empfohlen, beim Aufruf von $random eine Konstante in den Seed-Parameter zu schreiben. In diesem Fall ist der Seed-Wert fest, und es kann nur eine Zufallszahl erzeugt werden. Zum Beispiel wird der folgende Programmierstil nicht empfohlen:
randnum_wtseed <= $random(2); //不建议将常数项指定给 seed
Sie können die Modulo-Operation verwenden, um Zufallszahlen auf einen bestimmten Datenbereich zu begrenzen. Zum Beispiel:
Beispiel
Parameter MAX_NUM = 512;
Parameter MIN_NUM = 256;
reg [15:0] num_range1, num_range2, num_range3 ;
always@(posedge clk) begin
// Die generierten Zufallszahlen reichen von -511 bis 511, ±(MAX_NUM-1)
num_range1 <= $random() % MAX_NUM;
// Die generierten Zufallszahlen reichen von 0 bis 511, (0 ~ MAX_NUM-1)
num_range2 <= {$random()} % MAX_NUM;
// Die generierten Zufallszahlen reichen von MIN_NUM bis MAX_NUM, einschließlich der Grenzen
num_range3 <= MIN_NUM + {$random()} % (MAX_NUM-MIN_NUM+1);
end
Die Zufallszahlen werden im vorzeichenbehafteten Dezimalformat angezeigt. Die ersten paar Datenergebnisse lauten wie folgt:

Wahrscheinlichkeitsverteilungen
Verilog bietet viele Systemaufgaben, die Daten gemäß bestimmten Wahrscheinlichkeitsverteilungen erzeugen. Eine kurze Beschreibung lautet wie folgt:
| Systemaufgabe | Aufrufformat | Aufgabenbeschreibung |
|---|---|---|
| Gleichverteilung | $dist_uniform(seed, start, end); | start und end sind der Anfang und das Ende der Daten |
| Normalverteilung | $dist_normal (seed, mean, std_dev); | mean ist der Erwartungswert, std_dev ist die Standardabweichung |
| Poisson-Verteilung | $dist_poisson(seed, mean); | mean ist der Erwartungswert (gleich der Standardabweichung) |
| Exponentialverteilung | $dist_exponential(seed , mean); | mean ist die Anzahl der Ereignisse pro Zeiteinheit |
| Chi-Quadrat-Verteilung | $dist_chi_square(seed, free_deg); | free_deg ist die Anzahl der Freiheitsgrade |
| t-Verteilung | $dist_t(seed, free_deg); | free_deg ist die Anzahl der Freiheitsgrade |
| Erlang-Verteilung | $dist_erlang(seed, k_stage, mean); | k_stage ist die Anzahl der Stufen, mean ist der Erwartungswert |
Gleichverteilung
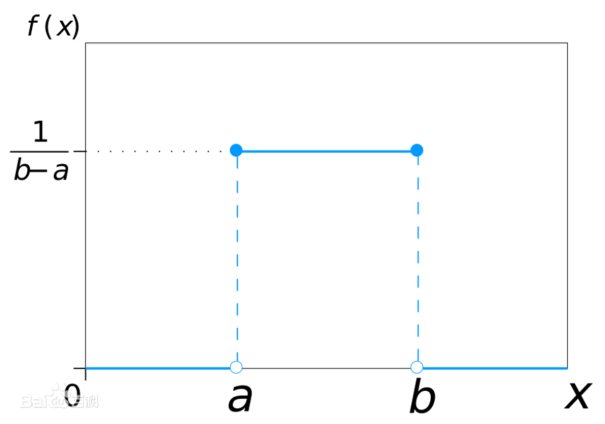
Bei einer Gleichverteilung sind die Wahrscheinlichkeiten, Werte in Intervallen gleicher Länge anzunehmen, gleich.
Die Wahrscheinlichkeitsdichtefunktion und das Wahrscheinlichkeitsverteilungsdiagramm sind wie folgt:
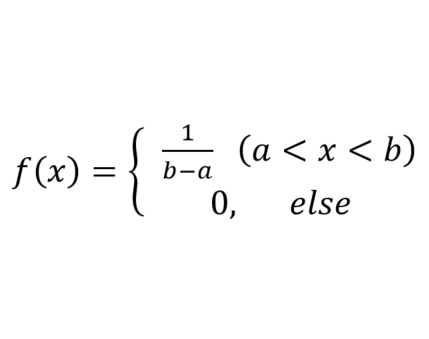
Tatsächlich implementiert die Systemaufgabe $random eine Gleichverteilung.
Der Code zum Aufrufen von $dist_uniform zum Erzeugen gleichverteilter Daten über das Intervall (256, 512) lautet wie folgt:
Beispiel
reg [15:0] data_uniform;
always@(posedge clk) begin // Zufallszahlen zwischen MIN_NUM und MAX_NUM erzeugen
data_uniform <= $dist_uniform(seed_dis, MIN_NUM, MAX_NUM);
end
Normalverteilung
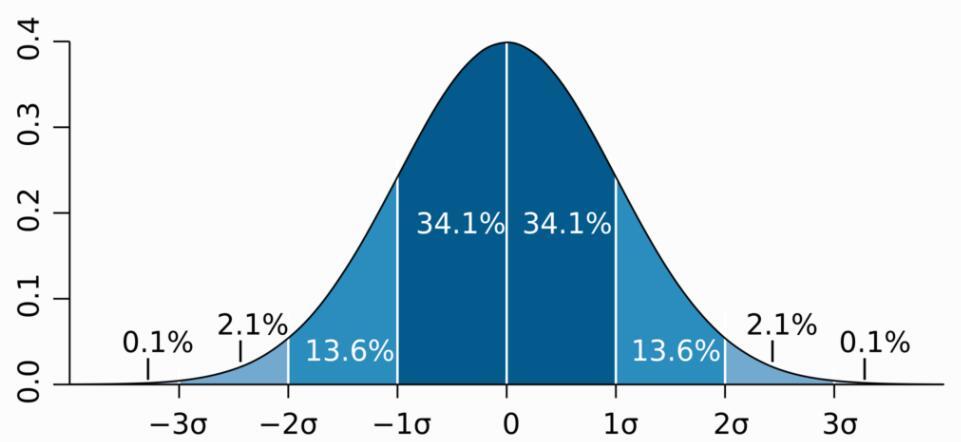
Der mathematische Erwartungswert einer Normalverteilung ist μ, die Standardabweichung ist σ, bezeichnet alsN (μ, σ²)。
Eine Normalverteilung mit mathematischem Erwartungswert 0 und Standardabweichung 1 wird als Standardnormalverteilung bezeichnet.
Die Normalverteilungskurve ist glockenförmig, an beiden Seiten niedrig, in der Mitte hoch und links und rechts symmetrisch.
Die Wahrscheinlichkeitsdichtefunktion und das Verteilungsdiagramm der Normalverteilung sind wie folgt:
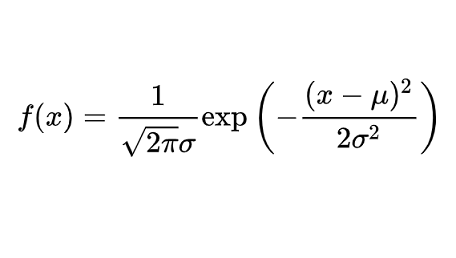
Der Code zum Aufrufen von $dist_normal zum Erzeugen von Standardnormalverteilungsdaten mit Erwartungswert 0 und Standardabweichung 1 lautet wie folgt:
Beispiel
reg [15:0] data_normal;
always@(posedge clk) begin // Standardnormalverteilung mit Erwartungswert 0 und Standardabweichung 1
data_normal <= $dist_normal(seed_dis, 0, 1);
end
Poisson-Verteilung
Die Poisson-Verteilung wird verwendet, um die Wahrscheinlichkeit zu beschreiben, dass ein Ereignis X-mal innerhalb eines bestimmten Zeit- oder Raumbereichs auftritt.
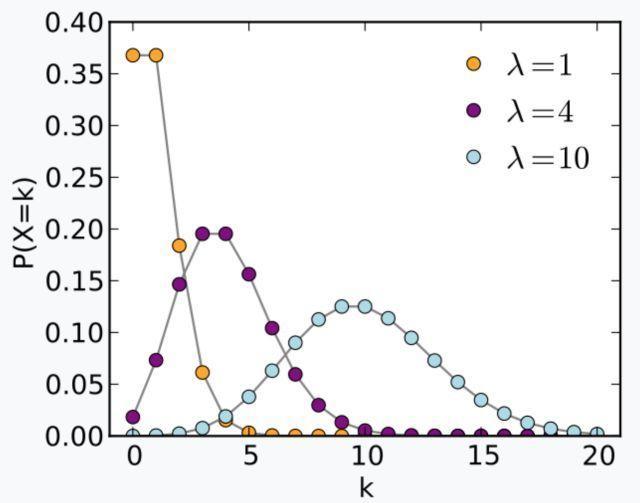
Die Poisson-Verteilung hat denselben mathematischen Erwartungswert und dieselbe Standardabweichung, beide gleich λ. Ihre Wahrscheinlichkeitsdichtefunktion und ihr Verteilungsdiagramm sind wie folgt:
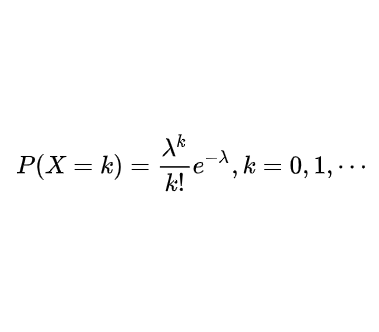
Der Code zum Aufrufen von $dist_poisson zum Generieren von Poisson-Verteilungsdaten mit einem Erwartungswert von 4 ist wie folgt:
Beispiel
reg [15:0] data_poisson;
always@(posedge clk) begin
data_poisson <= $dist_poisson(seed_dis, 4);
end
Exponentialverteilung
Die Exponentialverteilung wird verwendet, um die Wahrscheinlichkeit des Zeitintervalls zwischen dem Auftreten zufälliger Ereignisse in einem Poisson-Prozess zu beschreiben. Ein Poisson-Prozess ist ein Prozess, bei dem Ereignisse kontinuierlich und unabhängig mit einer konstanten Durchschnittsrate auftreten. Zum Beispiel folgt das Zeitintervall zwischen der Ankunft zweier Busse beim Warten an einer Bushaltestelle einer Exponentialverteilung.
Sei λ>0 die Anzahl der Ereignisauftritte pro Zeiteinheit (auch Rateparameter genannt) und x das Zeitintervall zwischen Ereignisauftritten. Dann sind ihre Wahrscheinlichkeitsdichtefunktion und ihr Verteilungsdiagramm wie folgt:
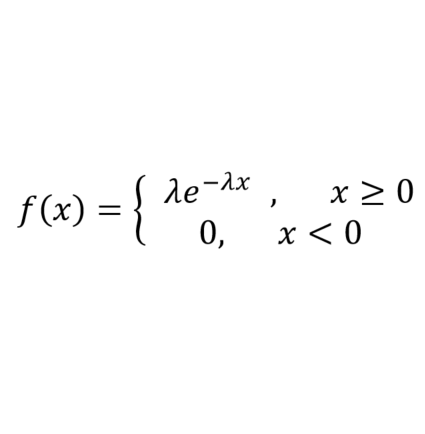
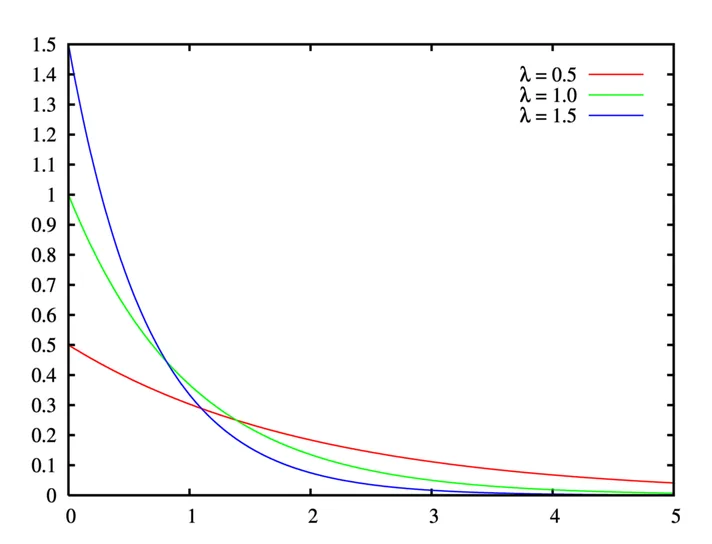
Der Code zum Aufrufen von $dist_exponential zum Generieren von Exponentialverteilungsdaten mit einem Rateparameter von 1 ist wie folgt:
Beispiel
reg [15:0] data_exp;
always@(posedge clk) begin
data_exp <= $dist_exponential(seed_dis, 1);
end
Chi-Quadrat-Verteilung
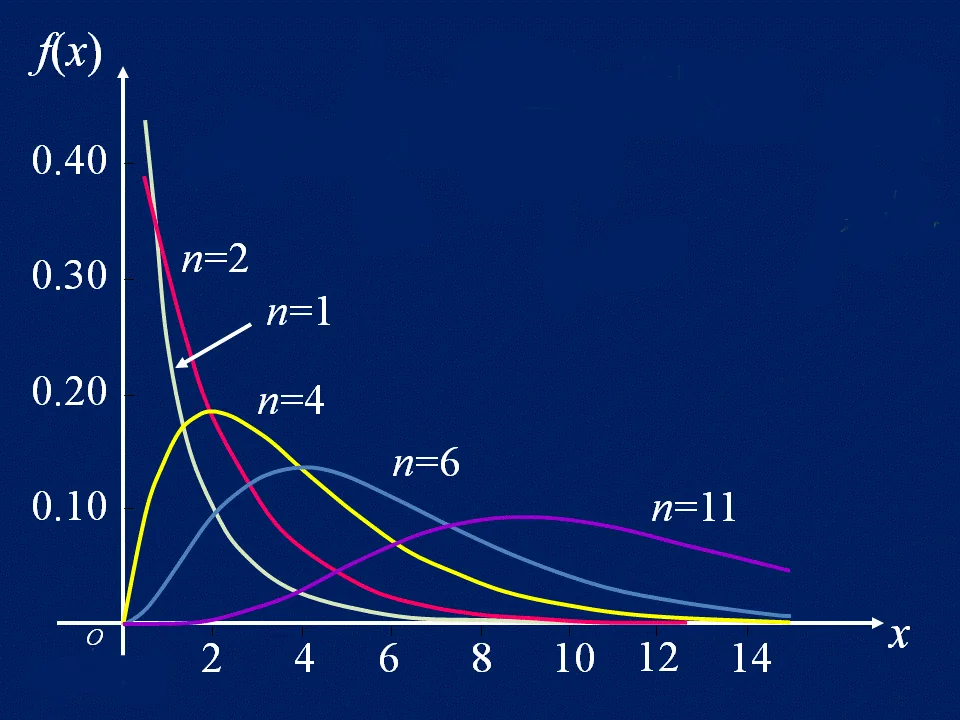
Das Verteilungsgesetz einer neuen Zufallsvariablen, die durch die Summe der Quadrate von n Zufallsvariablen gebildet wird, die der Standardnormalverteilung folgen, wird Chi-Quadrat-Verteilung genannt, bezeichnet als , wobei n als Freiheitsgrade bezeichnet wird.
Die Wahrscheinlichkeitsdichtefunktion und das Verteilungsdiagramm der Chi-Quadrat-Verteilung sind wie folgt:
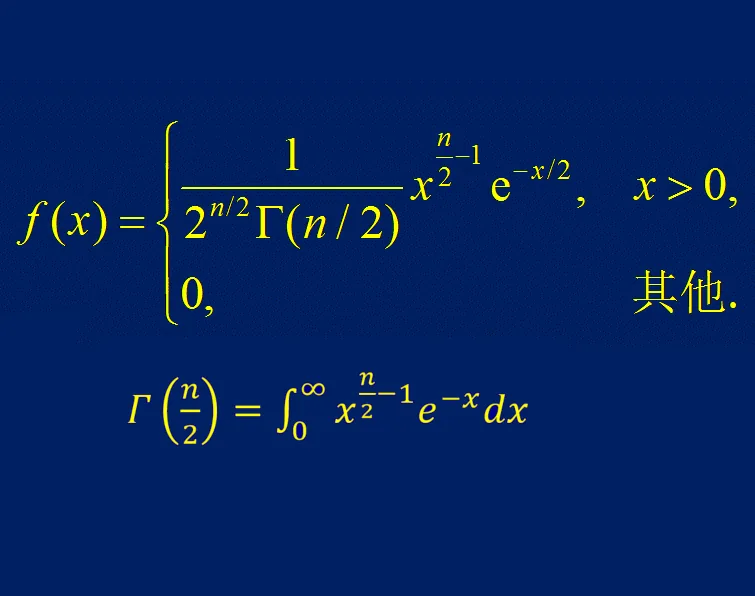
Der Code zum Aufrufen von $dist_chi_square, um Chi-Quadrat-Verteilungsdaten mit 6 Freiheitsgraden zu erzeugen, lautet wie folgt:
Beispiel
reg [15:0] data_chi_sq;
always@(posedge clk) begin
data_chi_sq <= $dist_chi_square(seed_dis, 6);
end
t-Verteilung
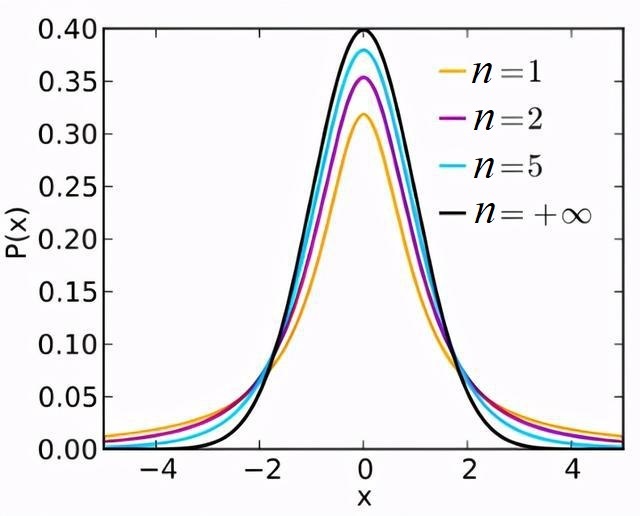
Angenommen, X folgt der Standardnormalverteilung N(0, 1) und Y folgt der Chi-Quadrat-VerteilungDie Verteilung von ... heißt t-Verteilung mit n Freiheitsgraden, bezeichnet als Z ~ t(n).
Die t-Verteilung wird verwendet, um den Populationsmittelwert einer Datenvariable, die normalverteilt mit unbekannter Varianz ist, anhand kleiner Stichproben zu schätzen. Wenn der Stichprobenumfang groß genug ist und die Populationsvarianz bekannt ist, sollte die Normalverteilung verwendet werden, um den Populationsmittelwert zu schätzen.
Die t-Verteilung ist eine symmetrische glockenförmige Verteilung, ähnlich der Normalverteilung, aber mit schwereren Rändern, was bedeutet, dass sie mit größerer Wahrscheinlichkeit Werte weit unter dem Mittelwert erzeugt. Ihre Wahrscheinlichkeitsdichtefunktion und ihr Verteilungsdiagramm sind wie folgt:
Der Code zum Aufrufen von $dist_t zum Generieren von t-Verteilungsdaten mit 5 Freiheitsgraden lautet wie folgt:
Beispiel
reg [15:0] data_t;
always@(posedge clk) begin
data_t <= $dist_t(seed_dis, 5);
end
Erlang-Verteilung
Seien V1, V2, ..., Vn in einem Poisson-Prozess mit Parameter λ gegenseitig unabhängig, und N(t) bezeichne die Anzahl der zufälligen Punkte in [0, t). Dann wird die Verteilung von N(t) = V1 + V2 + ... + Vn als Erlang-Verteilung bezeichnet.
Die Erlang-Verteilung wird, wie die Exponentialverteilung, häufig verwendet, um das Zeitintervall zwischen unabhängigen zufälligen Ereignissen darzustellen. Eine Zufallsvariable, die der Erlang-Verteilung folgt, kann in die Summe mehrerer Zufallsvariablen der Exponentialverteilung mit demselben Parameter zerlegt werden, wodurch die Erlang-Verteilung in der Zuverlässigkeitstheorie und der Warteschlangentheorie weit verbreitet ist.
Die Wahrscheinlichkeitsdichtefunktion und das Verteilungsdiagramm der Erlang-Verteilung sind wie folgt:
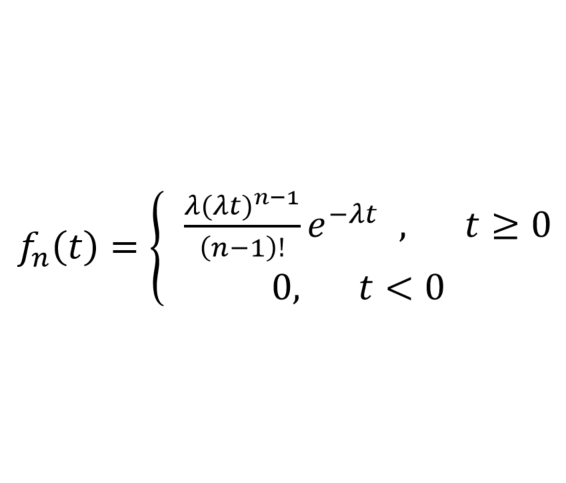
Warum das Gesicht? Du verwendest tatsächlich so eine fruchtige Idee, um die Erlang-Verteilung aufzufüllen?
Die obigen Wahrscheinlichkeitsverteilungsaufgaben listen nur die Aufrufmethoden auf, ohne die Daten zu analysieren oder zu verifizieren. Im Folgenden wird eingeführt, wie Sie das Matlab-Plotwerkzeug verwenden, um die Eigenschaften der von der Wahrscheinlichkeitsverteilungsaufgabe $dist_erlang generierten Daten selbst zu analysieren.
Der Code zum Aufrufen von $dist_erlang zum Generieren von Erlang-Verteilungsdaten mit Ordnung 3 und Erwartungswert 6 lautet wie folgt:
Beispiel
reg [15:0] data_erlang;
always@(posedge clk) begin
data_erlang <= $dist_erlang(seed_dis, 3, 6);
end
Datenanalyse
Die Realität beweist, dass es bequemer ist, vertraute Verteilungsdaten zu analysieren. Auf manchen Plattformen sind referenzierbare integrierte Funktionen im Zusammenhang mit der Erlang-Verteilung äußerst selten. Wohl wissend, dass es keine Liebe (Erlang) gibt, streben wir dennoch nach Liebe!
Verilog-Datendateien
Generieren Sie zuerst 4 Datensätze, die der Erlang-Verteilung folgen, im Verilog-Modell und geben Sie sie in eine Datei aus.
Beispiel
integer fd1, fd2, fd3, fd30 ;
initial begin
fd1 = $fopen("data_erlang1.hex", "w");
fd2 = $fopen("data_erlang2.hex", "w");
fd3 = $fopen("data_erlang3.hex", "w");
fd30 = $fopen("data_erlang30.hex", "w");
repeat(1000) begin //1000 Daten zur Analyse nehmen
@(posedge clk) ;
#1 ;
$fdisplay(fd1, "%h", data_erlang1);
$fdisplay(fd2, "%h", data_erlang2);
$fdisplay(fd3, "%h", data_erlang3);
$fdisplay(fd30, "%h", data_erlang30);
end
$fclose(fd1);
$fclose(fd2);
$fclose(fd3);
$fclose(fd30);
end
reg [15:0] data_erlang1;
reg [15:0] data_erlang2;
reg [15:0] data_erlang3;
reg [15:0] data_erlang30;
always@(posedge clk) begin
data_erlang1 <= $dist_erlang(seed_dis, 1, 6);
data_erlang2 <= $dist_erlang(seed_dis, 2, 6);
data_erlang3 <= $dist_erlang(seed_dis, 3, 6);
data_erlang30 <= $dist_erlang(seed_dis, 30, 6);
end
Verilog-Datenanalyse
In Matlab kann die Histogrammfunktion hist direkt verwendet werden, um jeden Datenpunkt statistisch darzustellen und anzuzeigen, aber für Wahrscheinlichkeitsverteilungen ist der tatsächliche Darstellungseffekt dieser Funktion nicht sehr gut (Vorschläge für eine bessere Darstellungsmethode sind willkommen). Hier wird die Matlab-Funktion tabulate verwendet, um jeden Datenpunkt zu zählen, und dann wird die gewöhnliche Funktion plot verwendet, um seinen prozentualen Anteil anzuzeigen.
Der Matlab-Code zum Einlesen der vom Verilog-Modul erzeugten Daten und zum Anzeigen ihres Verteilungsdiagramms lautet wie folgt.
Beispiel
%=======================================================
% Datenanalyse aus $dist_erlang in Verilog
%=======================================================
%Als Zeichenketten einlesen, dann von Hexadezimal in Dezimal umwandeln.
data_erlang1_hex = textread('data_erlang1.hex', '%s') ;
data_erlang2_hex = textread('data_erlang2.hex', '%s') ;
data_erlang3_hex = textread('data_erlang3.hex', '%s') ;
data_erlang30_hex = textread('data_erlang30.hex', '%s') ;
data_erlang1 = hex2dec(data_erlang1_hex);
data_erlang2 = hex2dec(data_erlang2_hex);
data_erlang3 = hex2dec(data_erlang3_hex);
data_erlang30 = hex2dec(data_erlang30_hex);
%Zählen Sie die Statistiken und stellen Sie sie grafisch dar.
num_erlang1 = tabulate(data_erlang1) ;
num_erlang2 = tabulate(data_erlang2) ;
num_erlang3 = tabulate(data_erlang3) ;
num_erlang30 = tabulate(data_erlang30) ;
figure; plot(num_erlang1(:,1)/6, num_erlang1(:,3));
hold on; plot(num_erlang2(:,1)/6, num_erlang2(:,3), 'r');
hold on; plot(num_erlang3(:,1)/6, num_erlang3(:,3), 'g');
hold on; plot(num_erlang30(:,1)/6, num_erlang30(:,3), 'y');
legend('n=1', 'n=2', 'n=3', 'n=30');
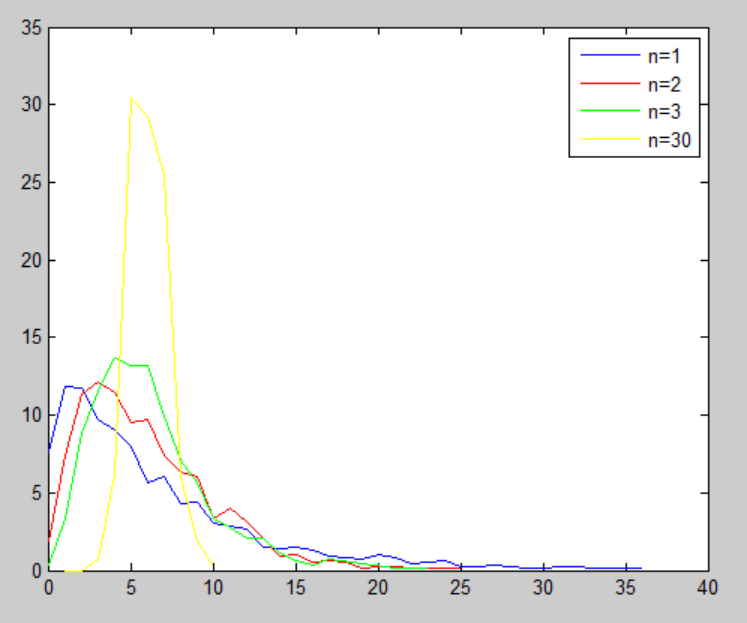
Das vom Verilog-Modell erzeugte Diagramm der Erlang-Datenverteilung ist unten dargestellt.
Erwartungswert der Erlang-Verteilung
Es ist wichtig zu beachten, dass der Parameter λ der Erwartungswert der Poisson-Verteilung ist, nicht der Erwartungswert der Erlang-Verteilung.
In der Verilog-Systemaufgabe $dist_erlang(seed, k_stage, mean) ist der dritte Parameter der Erwartungswert. Wenn Sie den Erwartungswert direkt in den Parameter λ einsetzen, erhalten Sie falsche Verteilungsergebnisse.
Nachfolgend findet sich eine einfache (faule) Herleitung (Referenz) des mathematischen Erwartungswerts der Erlang-Verteilung.
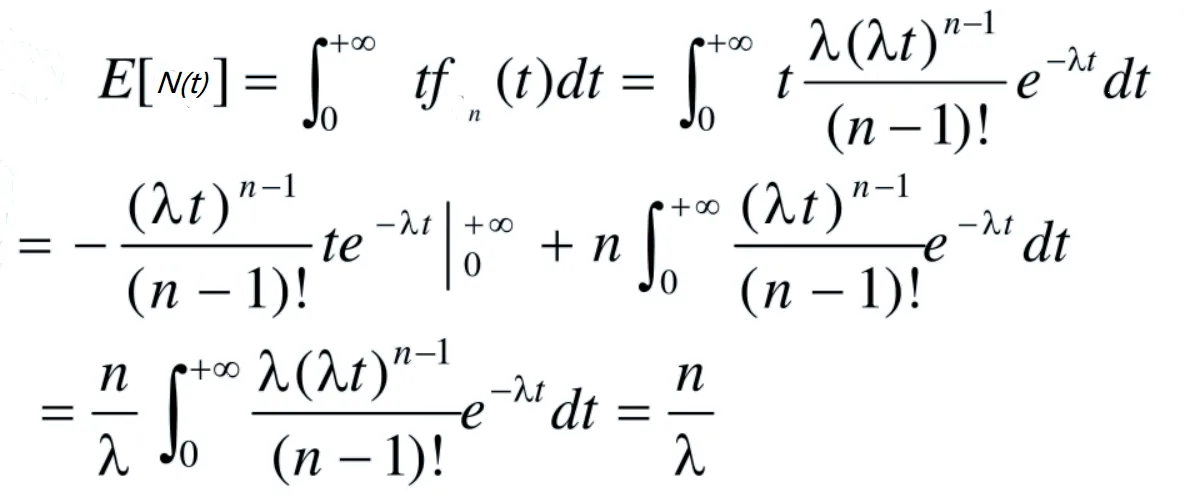
Beigefügt ist der Herleitungsprozess für die Varianz der Erlang-Verteilung.
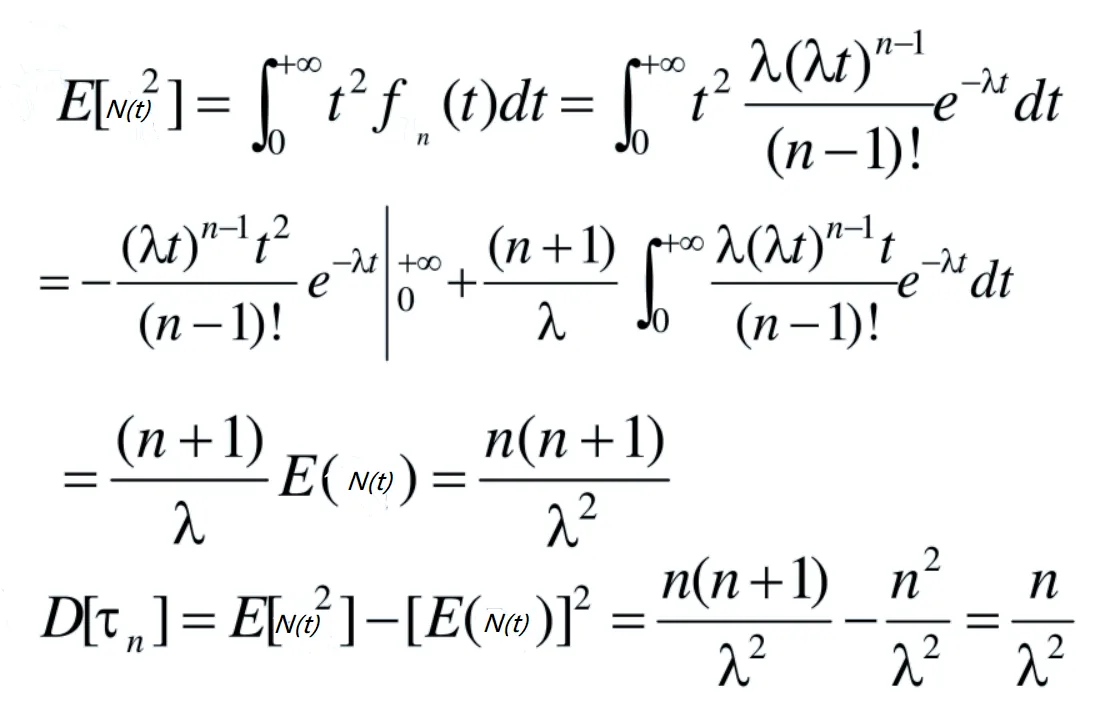
Theoretische Verteilung in Matlab
Mit der in Matlab integrierten Funktion random können Sie verschiedene Arten von verteilten Daten erzeugen, aber leider gibt es keine Erlang-Verteilung.
Verwenden Sie als Nächstes die Wahrscheinlichkeitsdichtefunktion, um Daten zu generieren, die der Erlang-Verteilung folgen.
Hier ist der Erwartungswert im Verilog-Modell 6, daher ist der tatsächliche Parameter λ = n/6.
Der Matlab-Code zur Generierung von Daten der Erlang-Verteilung lautet wie folgt.
Beispiel
%=======================================================
% Generieren von Daten der Erlang-Verteilung
%=======================================================
NUM = 400 ;
EXPECT = 6 ;
for n=[1, 2, 3, 30] //Generiere 4 Datensätze
lamda = n/EXPECT; //Erwartungswertumwandlung
t = (0:NUM-1)*0.1 ;
pt(n,:) = (lamda).^n *(t).^(n-1)/factorial(n-1) .* exp(-lamda * t) ;
end
figure; plot(t, pt(1,:)*100);
hold on;plot(t, pt(2,:)*100, 'r');
hold on;plot(t, pt(3,:)*100, 'g');
hold on;plot(t, pt(n,:)*100, 'y');
xlabel('t');
ylabel('f(t) / 100%');
legend('n=1', 'n=2', 'n=3', 'n=30');
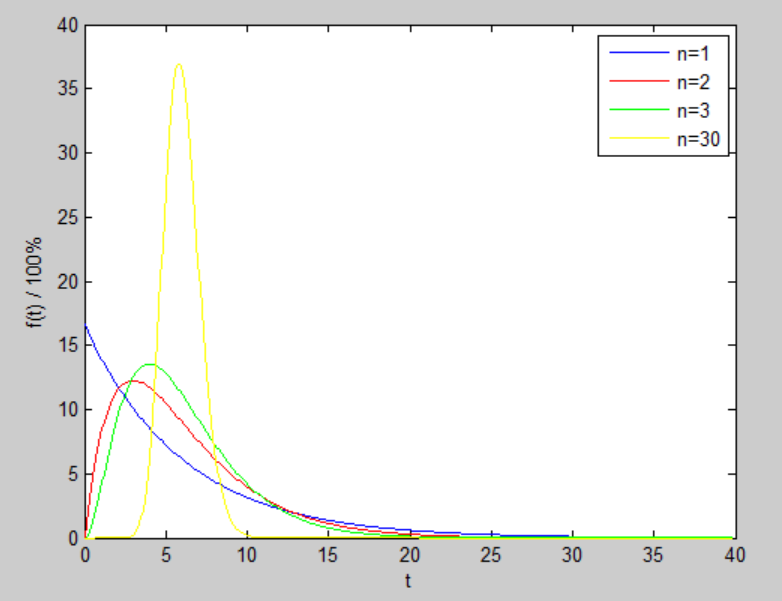
Das von Matlab erzeugte Diagramm der Erlang-Datenverteilung ist unten dargestellt.
Beim Vergleich mit den vom Verilog-Modell erzeugten Daten stimmen Verteilungsbereich, Verteilungswahrscheinlichkeit und Verlauf der Verteilungskurve der beiden grundsätzlich überein. Der einzige Unterschied besteht darin, dass Verilog Daten mit größeren Zeitintervallen erzeugt, sodass das Verteilungsdiagramm keine glatte Kurve ist.
Quellcode-Download für dieses Kapitel
Herunterladen