Terminologie de base de l'apprentissage automatique
Apprendre l'apprentissage automatique, c'est comme apprendre une nouvelle langue ; il faut d'abord maîtriser le vocabulaire de base. Ces termes forment le « système linguistique » de l'apprentissage automatique, et les comprendre est la première étape vers un apprentissage plus approfondi.
Imaginez que vous apprenez à un robot à reconnaître des fruits :
- Données: Images et informations de divers fruits
- Caractéristique: La couleur, la forme, la taille et le goût du fruit
- Étiquette: Le nom de ce fruit (pomme, banane, orange)
- Modèle: La "méthode de reconnaissance des fruits" apprise par le robot
- Entraînement: Le processus consistant à apprendre au robot à reconnaître des fruits
- Inférence: La capacité du robot à reconnaître de nouveaux fruits
Données
Qu'est-ce que les données ?
Les donnéessont la "matière première" de l'apprentissage automatique, tout comme les ingrédients dont un chef a besoin pour cuisiner. Sans données, l'apprentissage automatique ne peut pas se poursuivre.
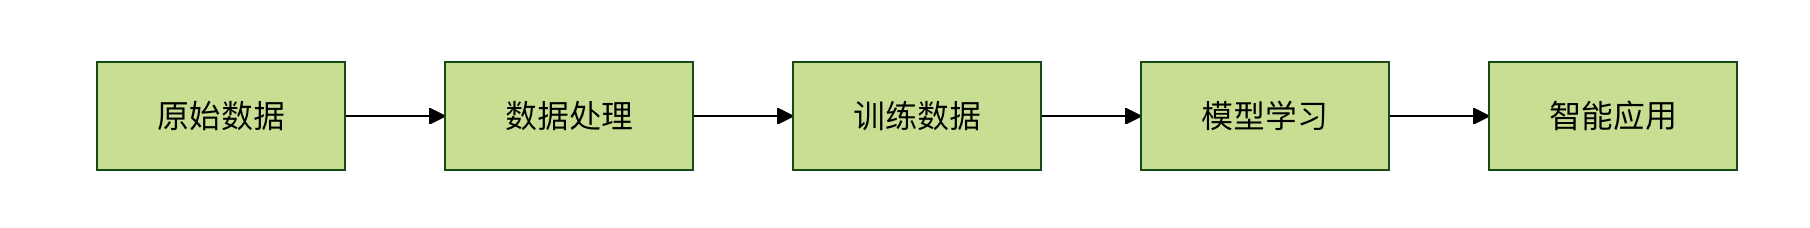
Types de données
1. Données structurées
Caractéristiques: Possède un format clair et une organisation nette, bien ordonné comme un tableau
# Exemple de données structurées : Tableau d'informations sur les étudiantsExemple
students_data = {
'Name': ['Zhang San', 'Li Si', 'Wang Wu'],
'Age': [18, 19, 20],
'Score': [85, 92, 78],
'Class': ['Class 1', 'Class 2', 'Class 1']
}
df = pd.DataFrame(students_data)
print(df)
Sortie:
   姓名  年龄  成绩  班级
0  张三  18  85  一班
1  李四  19  92  二班
2  王五  20  78  一班
2. Données non structurées
Caractéristiques: N'a pas de format fixe et nécessite un traitement spécial
Exemples:
- Texte : commentaires, articles, e-mails
- Images : photos, images médicales
- Audio : parole, musique
- Vidéo : séquences de surveillance, films
# 非结构化数据示例:文本和图像
text_data = "这个产品质量很好,我很满意!"
# image_data = 一张产品的照片
# audio_data = 顾客的语音评价
Importance de la qualité des données
Déchets en entrée, déchets en sortie(Déchets en entrée, déchets en sortie) est un principe important de l'apprentissage automatique. La qualité des données détermine directement les performances du modèle.
Exemple
import numpy as np
import pandas as pd
# Créer des données avec divers problèmes
problematic_data = {
'Price': [100, 200, None, 300, -50], # Valeurs manquantes et valeurs aberrantes
'Rating': [4.5, 'Good', 3.8, 4.2, 5.0], # Types de données incohérents
'Sales': [1000, 1200, 800, 1500, 'Many'] # Mélange de texte et de nombres
}
df = pd.DataFrame(problematic_data)
print("Données problématiques :")
print(df)
print("\nAnalyse des problèmes de données : ")
print(f"Nombre de valeurs manquantes : {df.isnull().sum().sum()}")
print(f"Types de données :\n{df.dtypes}")
Fonctionnalité
Qu'est-ce qu'une caractéristique ?
Une caractéristiqueest un « attribut observable » des données, tout comme décrire les caractéristiques d'une personne : taille, poids, couleur des cheveux, personnalité, etc. En apprentissage automatique, les caractéristiques sont la base des prédictions.
Importance de la sélection des caractéristiques:
- De bonnes caractéristiques peuvent rendre le modèle deux fois plus efficace avec deux fois moins d'effort
- De mauvaises caractéristiques peuvent rendre le modèle deux fois moins efficace avec deux fois plus d'effort
- L'ingénierie des caractéristiques est souvent la clé pour déterminer la performance du modèle
Types de caractéristiques
1. Caractéristiques numériques
Caractéristiques: Peuvent être représentées par des nombres et peuvent subir des opérations mathématiques
# 数值特征示例
numerical_features = {
    '年龄': [25, 30, 35, 40],
    '收入': [5000, 8000, 12000, 15000],
    '身高': [165, 170, 175, 180]
}
2. Caractéristiques catégorielles
Caractéristiques: Représentent différentes catégories et ne peuvent pas subir d'opérations mathématiques
# 类别特征示例
categorical_features = {
    '性别': ['男', '女', '男', '女'],
    '学历': ['本科', '硕士', '博士', '本科'],
    '城市': ['北京', '上海', '广州', '深圳']
}
3. Caractéristiques textuelles
Caractéristiques: nécessite un traitement spécial avant de pouvoir être utilisées par le modèle
# 文本特征示例
text_features = {
    '评论': [
        '这个产品很好用,推荐购买!',
        '质量一般,不太满意。',
        '性价比高,值得入手。'
    ]
}
Exemple d'ingénierie des caractéristiques
Exemple
import pandas as pd
import numpy as np
# Données brutes : informations sur la maison
house_data = {
'Area': [80, 120, 60, 150, 90],
'Number of Bedrooms': [2, 3, 1, 4, 2],
'Year Built': [2000, 2010, 1995, 2015, 2005],
'Price': [200, 350, 150, 500, 280]
}
df = pd.DataFrame(house_data)
# Créer de nouvelles caractéristiques
df['House Age'] = 2023 - df['Year Built'] # Âge de la maison
df['Price per Square Meter'] = df['Price'] / df['Area'] # Prix unitaire
df['Bedroom Area Ratio'] = df['Number of Bedrooms'] / df['Area'] * 100 # Ratio de chambres
print("Données brutes + nouvelles caractéristiques :")
print(df)
# Analyse de l'importance des caractéristiques
correlation = df.corr()['Price'].sort_values(ascending=False)
print("\nCorrélation entre les caractéristiques et le prix : ")
print(correlation)
Étiquette
Qu'est-ce qu'une étiquette ?
L'étiquetteest la « réponse » que nous voulons prédire, tout comme la bonne réponse à une question d'examen. Dans l'apprentissage supervisé, chaque échantillon de données a une étiquette correspondante.
Rôle des étiquettes:
- Guider la direction d'apprentissage du modèle
- Évaluer l'efficacité d'apprentissage du modèle
- Définir le type de problème
Types d'étiquettes
1. Étiquettes de classification
Caractéristiques: valeurs catégorielles discrètes
# 分类标签示例
classification_labels = {
    '邮件类型': ['垃圾邮件', '正常邮件', '垃圾邮件', '正常邮件'],
    '情感倾向': ['正面', '负面', '中性', '正面'],
    '疾病诊断': ['患病', '健康', '健康', '患病']
}
2. Étiquettes de régression
Caractéristiques: valeurs numériques continues
# 回归标签示例
regression_labels = {
    '房价': [250000, 320000, 180000, 450000],
    '温度': [25.5, 28.3, 22.1, 30.0],
    '股票价格': [100.5, 105.2, 98.7, 110.3]
}
Importance de la qualité des étiquettes
# 标签质量问题示例
import numpy as np
# 模拟图像分类任务中的标签问题
image_data = ['cat1.jpg', 'dog1.jpg', 'cat2.jpg', 'dog2.jpg']
problematic_labels = ['猫', '犬', '猫咪', '狗']  # 标签不一致
# 标签标准化
label_mapping = {
    '猫': 'cat', '猫咪': 'cat',
    '犬': 'dog', '狗': 'dog'
}
standardized_labels = [label_mapping[label] for label in problematic_labels]
print("原始标签:", problematic_labels)
print("标准化标签:", standardized_labels)
Modèle
Qu'est-ce qu'un modèle ?
Le modèleest le « motif » ou la « règle » qu'un algorithme d'apprentissage automatique apprend à partir des données, tout comme les connaissances que les élèves apprennent dans les manuels.
Essence d'un modèle:
- Fonction mathématique : caractéristiques d'entrée, prédictions de sortie
- Ensemble de paramètres : représentation concrète des règles apprises
- Règles de décision : comment obtenir une sortie à partir d'une entrée
Représentation d'un modèle
Exemple
import numpy as np
import matplotlib.pyplot as plt
# Données simulées
X = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 6, 8, 10])
# Modèle linéaire : y = w * x + b
# Paramètres appris : w = 2, b = 0
w, b = 2, 0
def linear_model(x):
"""Fonction de modèle linéaire"""
return w * x + b
# Prédiction
predictions = linear_model(X)
# Visualisation
plt.scatter(X, y, color='blue', label='Données réelles')
plt.plot(X, predictions, color='red', label='Prédictions du modèle')
plt.xlabel('Entrée X')
plt.ylabel('Sortie y')
plt.title('Exemple de modèle linéaire')
plt.legend()
plt.grid(True)
plt.show()
print(f"Paramètres du modèle : w = {w}, b = {b}")
print(f"Résultats des prédictions : {predictions}")
Complexité du modèle
Exemple
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
import numpy as np
# Générer des données non linéaires
np.random.seed(42)
X = np.random.rand(20, 1) * 10
y = np.sin(X) + np.random.randn(20, 1) * 0.1
# Modèle simple (linéaire)
simple_model = LinearRegression()
simple_model.fit(X, y)
# Modèle complexe (polynôme de degré élevé)
poly_features = PolynomialFeatures(degree=10)
X_poly = poly_features.fit_transform(X)
complex_model = LinearRegression()
complex_model.fit(X_poly, y)
# Visualisation
X_test = np.linspace(0, 10, 100).reshape(-1, 1)
X_test_poly = poly_features.transform(X_test)
plt.scatter(X, y, color='blue', label='Données d'entraînement')
plt.plot(X_test, simple_model.predict(X_test), color='green', label='Modèle simple')
plt.plot(X_test, complex_model.predict(X_test_poly), color='red', label='Modèle complexe')
plt.xlabel('X')
plt.ylabel('y')
plt.title('Comparaison de la complexité des modèles')
plt.legend()
plt.grid(True)
plt.show()
Entraînement
Qu'est-ce que l'entraînement ?
L'entraînementest le processus par lequel un modèle apprend, tout comme des étudiants acquièrent des connaissances en classe. Pendant l'entraînement, le modèle ajuste continuellement ses paramètres afin que les prédictions se rapprochent de plus en plus des vraies étiquettes.
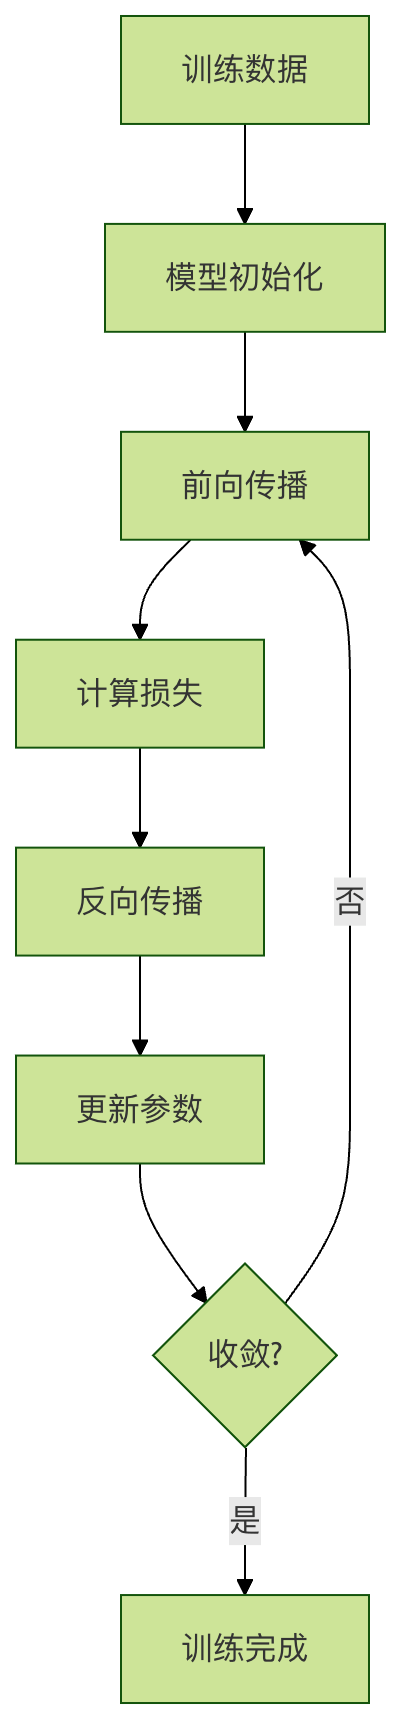
Exemple de processus d'entraînement
Exemple
import numpy as np
import matplotlib.pyplot as plt
# Générer des données d'entraînement
np.random.seed(42)
X = np.random.rand(50, 1) * 10
y = 3 * X + 2 + np.random.randn(50, 1) * 2
# Initialiser les paramètres du modèle
w, b = 0.0, 0.0
learning_rate = 0.01
époques = 100
# Enregistrer le processus d'entraînement
loss_history = []
# Boucle d'entraînement
for epoch in range(epochs):
# Propagation avant
y_pred = w * X + b
# Calculer la perte (erreur quadratique moyenne)
loss = np.mean((y_pred - y) ** 2)
loss_history.append(loss)
# Calculer les gradients
dw = np.mean(2 * X * (y_pred - y))
db = np.mean(2 * (y_pred - y))
# Mettre à jour les paramètres
w -= learning_rate * dw
b -= learning_rate * db
if epoch % 10 == 0:
print(f"Époque {epoch}: Perte = {loss:.4f}, w = {w:.4f}, b = {b:.4f}")
# Visualiser le processus d'entraînement
plt.figure(figsize=(12, 4))
plt.subplot(1, 2, 1)
plt.plot(loss_history)
plt.xlabel('Époque')
plt.ylabel('Perte')
plt.title('Évolution de la perte d'entraînement')
plt.grid(True)
plt.subplot(1, 2, 2)
plt.scatter(X, y, color='blue', label='Données d'entraînement')
plt.plot(X, w * X + b, color='red', label='Modèle entraîné')
plt.xlabel('X')
plt.ylabel('y')
plt.title('Résultats d'entraînement')
plt.legend()
plt.grid(True)
plt.tight_layout()
plt.show()
print(f"Paramètres finaux du modèle: w = {w:.4f}, b = {b:.4f}")
Inférence
Qu'est-ce que l'inférence ?
InférenceL'inférence est le processus consistant à utiliser un modèle entraîné pour faire des prédictions, tout comme des étudiants utilisant les connaissances apprises pour répondre à des questions d'examen.
Exemple de processus d'inférence
Exemple
import numpy as np
# Supposons que nous avons déjà entraîné un modèle de prédiction du prix des maisons
class HousePriceModel:
def __init__(self):
# Simuler des paramètres entraînés
self.feature_weights = {
'Area': 2.5,
'Bedrooms': 10.0,
'House age': -1.0,
'Location score': 50.0
}
self.bias = 50.0
def predict(self, features):
"""
Utiliser le modèle entraîné pour la prédiction du prix des maisons
"""
price = self.bias
for feature_name, feature_value in features.items():
if feature_name in self.feature_weights:
price += self.feature_weights[feature_name] * feature_value
return price
# Créer le modèle entraîné
model = HousePriceModel()
# Inférence : Prédire le prix d'une nouvelle maison
new_houses = [
{'Area': 80, 'Bedrooms': 2, 'House age': 5, 'Location score': 8},
{'Area': 120, 'Bedrooms': 3, 'House age': 2, 'Location score': 9},
{'Area': 60, 'Bedrooms': 1, 'House age': 10, 'Location score': 6}
]
print(Résultats de prédiction du prix des maisons :)
for i, house in enumerate(new_houses, 1):
predicted_price = model.predict(house)
print(f"Maison {i} : prix prédit {predicted_price:.2f} dix mille yuan")
# Inférence par lots
def batch_predict(model, house_list):
"""Prédiction par lots"""
return [model.predict(house) for house in house_list]
batch_prices = batch_predict(model, new_houses)
print(f"\nRésultats de prédiction par lots : {batch_prices}")
Exemple complet : des données à l'inférence
Exemple
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, r2_score
# 1. Préparation des données
np.random.seed(42)
n_samples = 200
# Générer les données de caractéristiques
area = np.random.normal(100, 30, n_samples) # Surface
bedrooms = np.random.randint(1, 5, n_samples) # Chambres
age = np.random.randint(0, 20, n_samples) # Âge de la maison
location_score = np.random.randint(1, 10, n_samples) # Score de localisation
# Générer les étiquettes (prix des maisons) - combinaison linéaire des caractéristiques plus bruit
price = (area * 2.5 + bedrooms * 20 + age * -2 + location_score * 15 +
np.random.normal(0, 50, n_samples))
# Créer un DataFrame
data = pd.DataFrame({
'Area': area,
'Bedrooms': bedrooms,
'House age': age,
'Location score': location_score,
'Price': price
})
print(Exemple de données:)
print(data.head())
# 2. Diviser en ensemble d'entraînement et ensemble de test
features = ['Area', 'Bedrooms', 'House age', 'Location score']
X = data[features]
y = data['Price']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
print(f"\nTaille de l'ensemble d'entraînement : {X_train.shape)
print(f"Taille de l'ensemble de test : {X_test.shape)
# 3. Entraîner le modèle
model = LinearRegression()
model.fit(X_train, y_train)
print(f"\nParamètres du modèle :")
for feature, coef in zip(features, model.coef_):
print(f"{feature}: {coef:.2f}")
print(f"Ordonnée à l'origine : {model.intercept_:.2f}")
# 4. Évaluer le modèle
y_train_pred = model.predict(X_train)
y_test_pred = model.predict(X_test)
train_mse = mean_squared_error(y_train, y_train_pred)
test_mse = mean_squared_error(y_test, y_test_pred)
train_r2 = r2_score(y_train, y_train_pred)
test_r2 = r2_score(y_test, y_test_pred)
print(f"\nÉvaluation du modèle :")
print(f"MSE sur l'ensemble d'entraînement : {train_mse:.2f}, R² : {train_r2:.2f}")
print(f"MSE sur l'ensemble de test : {test_mse:.2f}, R² : {test_r2:.2f}")
# 5. Inférence (prédire de nouvelles données)
new_houses = pd.DataFrame({
'Area': [85, 120, 65],
'Bedrooms': [2, 3, 1],
'House age': [3, 1, 8],
'Location score': [7, 9, 5]
})
predictions = model.predict(new_houses)
print(f"\nPrédiction du prix de la nouvelle maison :")
for i, price in enumerate(predictions, 1):
print(f"Maison {i} : {price:.2f} dix mille yuans")
Types courants de réseaux d'apprentissage automatique
| Type de modèle | Nom complet en chinois | Abréviation anglaise | Scénarios d'application principaux | Avantages | Inconvénients |
|---|---|---|---|---|---|
| Apprentissage automatique traditionnel | Arbre de décision | DT | Classification, régression, analyse de l'importance des variables | Forte interprétabilité, aucune normalisation des données requise | Sujet au surapprentissage, sensible au bruit |
| Forêt aléatoire | RF | Classification, régression, détection d'anomalies | Résistant au surapprentissage, grande stabilité | Coût de calcul élevé avec des données de grande dimension | |
| Régression logistique | LR | Classification binaire, prédiction de probabilité | Entraînement rapide, forte interprétabilité | Difficile d'ajuster les relations non linéaires | |
| Machine à vecteurs de support | SVM | Classification, données de petite taille en haute dimension | Forte capacité de généralisation, adaptée aux scénarios à grande dimension de caractéristiques | Entraînement lent sur des données à grande échelle, réglage complexe des paramètres | |
| Bayes naïf | NB | Classification de texte, détection de spam | Entraînement extrêmement rapide, insensible aux données manquantes | Suppose l'indépendance des caractéristiques, ce qui peut ne pas être vérifié dans des scénarios réels | |
| XGBoost | XGBoost | Classification, régression, tâches de niveau compétition | Haute précision, prend en charge le calcul parallèle, régularisation intégrée | Sujet au surapprentissage, sensible aux hyperparamètres | |
| LightGBM | LightGBM | Classification et régression sur des données à grande échelle | Vitesse d'entraînement rapide, faible utilisation de la mémoire | Peut être moins stable que XGBoost sur de petits ensembles de données | |
| Apprentissage profond | Réseau de neurones artificiels | ANN | Tâches simples de classification et de régression | Structure simple, facile à comprendre | Difficile de traiter des données complexes et de grande dimension |
| Réseau de neurones convolutif | CNN | Reconnaissance d'images, détection d'objets, analyse vidéo | Extrait automatiquement les caractéristiques spatiales, partage des paramètres | L'entraînement nécessite de grandes quantités de données et de ressources de calcul | |
| Réseau de neurones récurrent | RNN | Traitement de données séquentielles, génération de texte | Gère les séquences de longueur variable | Présente des problèmes de disparition/explosion du gradient, difficile de capturer les dépendances à long terme | |
| Mémoire à long terme et à court terme | LSTM | Traduction de textes longs, reconnaissance vocale | Résout le problème de dépendance à long terme des RNN | Structure complexe, vitesse d'entraînement relativement lente | |
| Unité récurrente à portes | GRU | Traitement de données séquentielles, analyse de sentiments | Structure plus simple que LSTM, entraînement plus rapide | Légèrement inférieur au LSTM dans les scénarios de longues séquences | |
| Réseau antagoniste génératif | GAN | Génération d'images, transfert de style, augmentation de données | Données générées de haute qualité, forte diversité | Entraînement instable, sujet à l'effondrement des modes | |
| Transformer | Transformer | Traitement du langage naturel, tâches multimodales | Grande efficacité de calcul parallèle, forte capacité à capturer les dépendances longues | Coût de calcul élevé, sujet au surapprentissage sur de petits ensembles de données | |
| Autoencodeur | AE | Compression de données, détection d'anomalies, extraction de caractéristiques | Apprentissage non supervisé, structure simple | La qualité des données générées est généralement inférieure à celle de GAN | |
| Réseau de neurones de graphes | GNN | Analyse de réseaux sociaux, prédiction de structures moléculaires | Traite les données structurées en graphe, exploite les relations entre nœuds | Difficile à entraîner, exigences élevées pour le prétraitement de la structure de graphe |