Apprentissage automatique et intelligence artificielle
La relation entre l'intelligence artificielle, l'apprentissage automatique et l'apprentissage profond
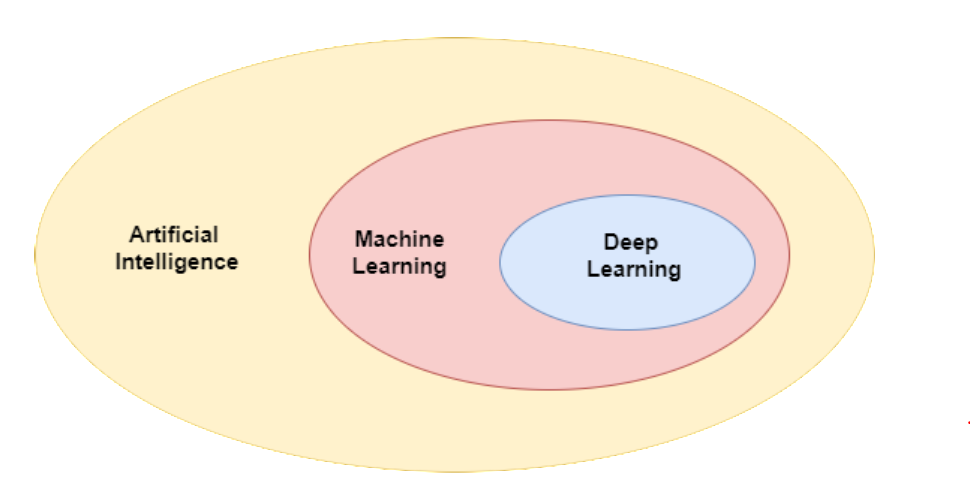
Imaginez une poupée russe : une grande poupée contient une poupée de taille moyenne, et la poupée de taille moyenne contient une petite poupée. La relation entre l'intelligence artificielle, l'apprentissage automatique et l'apprentissage profond est exactement comme ceci :
- Intelligence artificielle (IA): la plus grande poupée, le concept le plus vaste
- Apprentissage automatique (ML): la poupée du milieu, une partie de l'IA
- Apprentissage profond (DL): la plus petite poupée, une partie de l'apprentissage automatique
Qu'est-ce que l'intelligence artificielle (IA) ?
L'intelligence artificielleest un concept vaste qui désigne les technologies permettant aux machines de faire preuve d'une intelligence semblable à celle des humains. Tout comme l'intelligence humaine inclut des capacités telles que le raisonnement, l'apprentissage, la perception et la compréhension du langage, l'IA cherche également à doter les machines de ces capacités.
Les objectifs de l'IA:
- Simuler les processus de pensée humains
- Résoudre des tâches qui nécessitent l'intelligence humaine pour être accomplies
- Surpasser les capacités humaines dans certains domaines
Exemples d'IA:
- Programmes de jeu d'échecs (comme AlphaGo)
- Assistants vocaux (comme Siri, Xiao Ai)
- Voitures autonomes
La place de l'apprentissage automatique (ML) dans l'IA
L'apprentissage automatiqueest une méthode pour parvenir à l'intelligence artificielle, mais pas la seule. Tout comme il existe plusieurs façons de cuisiner (faire sauter, faire bouillir, cuire à la vapeur, rôtir), il existe également plusieurs approches pour mettre en œuvre l'IA.
Caractéristiques de l'apprentissage automatique:
- Ne nécessite pas d'écrire manuellement toutes les règles
- Apprend automatiquement les motifs à partir des données
- Adapté au traitement de problèmes complexes où les règles sont difficiles à définir explicitement
IA traditionnelle vs apprentissage automatique:
| Approche traditionnelle de l'IA | Approche d'apprentissage automatique |
|---|---|
| Systèmes experts : règles écrites manuellement | Apprentissage de règles à partir de données |
| Raisonnement logique : basé sur des règles explicites | Reconnaissance de motifs : trouver des motifs dans les données |
| Adapté aux problèmes ayant des règles bien définies | Adapté aux problèmes complexes et ambigus |
Apprentissage profond (DL) et apprentissage automatique
L'apprentissage profondest une branche de l'apprentissage automatique qui utilise des réseaux de neurones multicouches pour apprendre des motifs complexes dans les données.
Caractéristiques de l'apprentissage profond:
- Utilise des réseaux de neurones multicouches (« deep » désigne de nombreuses couches)
- Particulièrement adapté au traitement de données non structurées telles que les images, l'audio et le texte
- Nécessite de grandes quantités de données et de ressources de calcul
Historique et évolution du développement
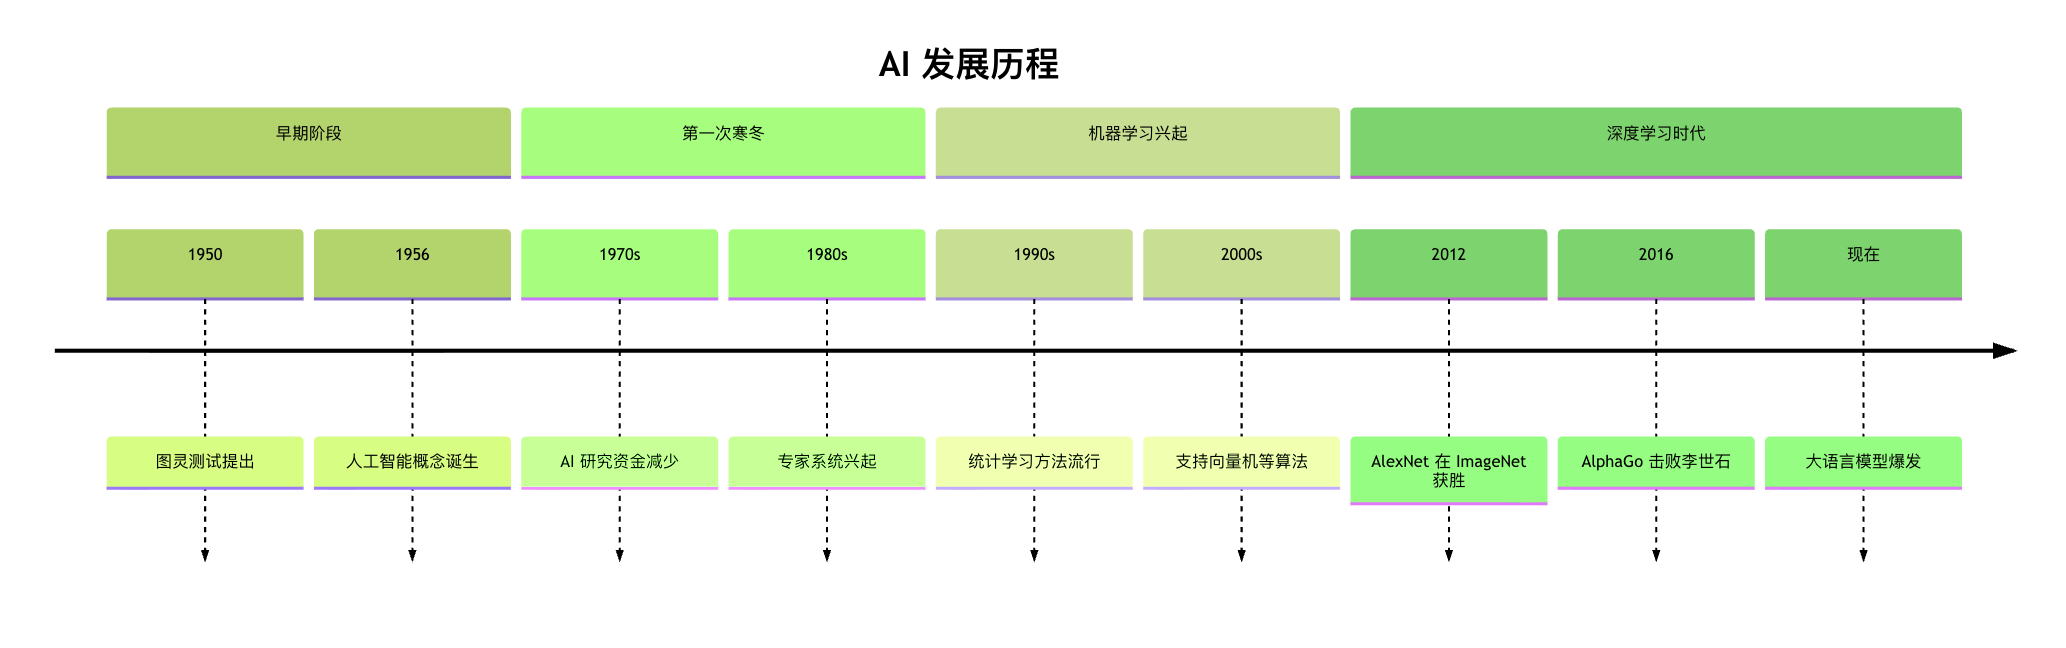
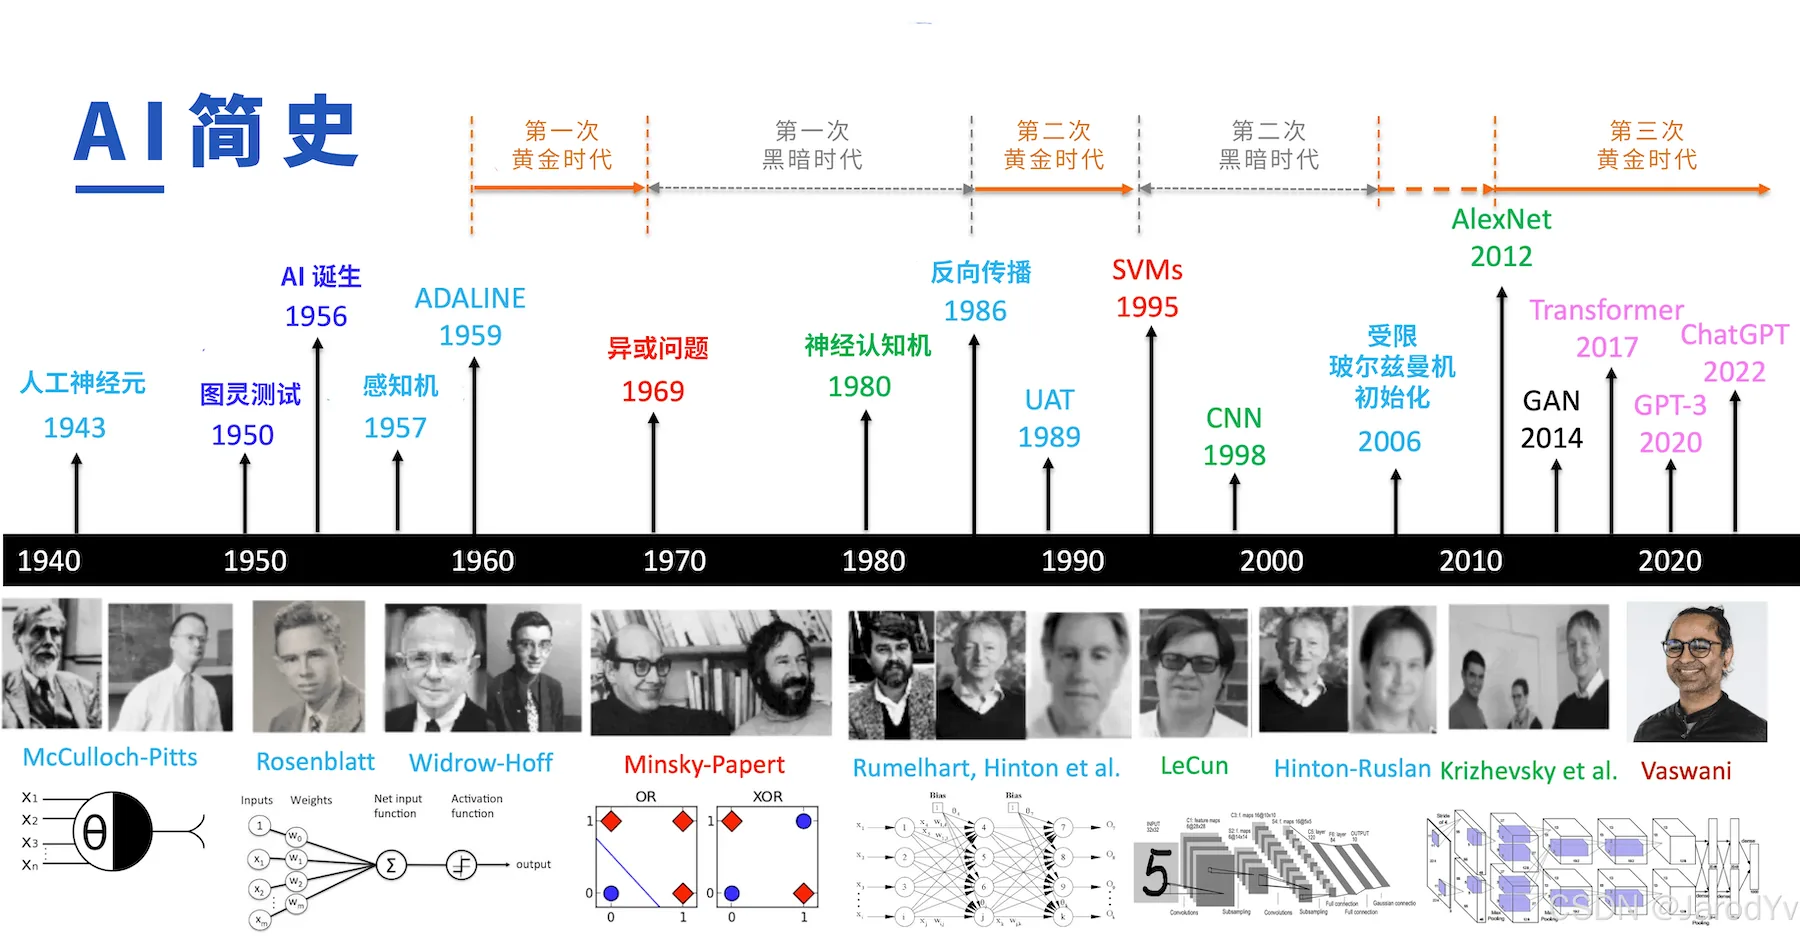
- IA des débuts (années 1950-1970): reposait principalement sur des règles écrites manuellement et un raisonnement logique
- Essor de l'apprentissage automatique (années 1980-2000): a commencé à apprendre à partir des données, mais les caractéristiques nécessitaient une conception manuelle
- Ère de l'apprentissage profond (années 2010 à aujourd'hui): apprend automatiquement les caractéristiques, gère des problèmes plus complexes
Exemple
Utilisons un exemple simple pour démontrer les différences entre les méthodes traditionnelles, l'apprentissage automatique et l'apprentissage profond - en tentant de reconnaître des chiffres manuscrits.
Méthode 1 : approche traditionnelle (basée sur des règles)
Exemple
# Ce n'est qu'un exemple conceptuel ; en pratique, cette méthode donne de très mauvais résultats
def recognize_digit_by_rules(image):
"""
Reconnaissance de chiffres à partir de règles manuelles (exemple simplifié)
"""
# Règle 1 : Compter le nombre de pixels noirs dans l'image
black_pixels = count_black_pixels(image)
# Règle 2 : Calculer la position du centroïde de l'image
center_x, center_y = calculate_center(image)
# Règle 3 : Détecter des caractéristiques de forme spécifiques
has_circle = detect_circle(image)
has_straight_line = detect_straight_line(image)
# Jugement basé sur des règles
if has_circle and black_pixels < 50:
return "0"
elif has_straight_line and center_y < image_height/2:
return "7"
# ... plus de règles
else:
return "Impossible de reconnaître"
# Problème : il est difficile pour les règles de couvrir tous les cas, et elles sont très fragiles
Méthode 2 : approche d'apprentissage automatique
Exemple
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score
# 1. Concevoir manuellement des caractéristiques (c'est la limitation de l'apprentissage automatique traditionnel)
def extract_features(image):
"""
Caractéristiques conçues manuellement
"""
features = []
# Caractéristique 1 : proportion de pixels noirs
features.append(count_black_pixels(image) / total_pixels)
# Caractéristique 2 : centroïde de l'image
center_x, center_y = calculate_center(image)
features.extend([center_x, center_y])
# Caractéristique 3 : densité de contours
features.append(calculate_edge_density(image))
# ... davantage de caractéristiques conçues manuellement
return features
# 2. Extraire les caractéristiques de toutes les données d'entraînement
X_train = [extract_features(img) for img in train_images]
y_train = train_labels
# 3. Entraîner le modèle
model = RandomForestClassifier(n_estimators=100)
model.fit(X_train, y_train)
# 4. Test
X_test = [extract_features(img) for img in test_images]
predictions = model.predict(X_test)
print(f"Exactitude: {accuracy_score(test_labels, predictions):.2f}")
Méthode 3 : approche d'apprentissage profond
Exemple
import tensorflow as tf
from tensorflow.keras import layers, models
# 1. Construire un réseau de neurones
model = models.Sequential([
# Apprend automatiquement les caractéristiques de bas niveau (contours, textures, etc.)
layers.Conv2D(32, (3, 3), activation='relu', input_shape=(28, 28, 1)),
layers.MaxPooling2D((2, 2)),
# Apprend automatiquement les caractéristiques de niveau intermédiaire (formes, combinaisons, etc.)
layers.Conv2D(64, (3, 3), activation='relu'),
layers.MaxPooling2D((2, 2)),
# Apprend automatiquement des caractéristiques de haut niveau (motifs globaux)
layers.Conv2D(64, (3, 3), activation='relu'),
# Couche de classification
layers.Flatten(),
layers.Dense(64, activation='relu'),
layers.Dense(10, activation='softmax') # 10 catégories de chiffres
])
# 2. Compiler le modèle
model.compile(optimizer='adam',
loss='sparse_categorical_crossentropy',
metrics=['accuracy'])
# 3. Entraîner directement avec des données d'images brutes (aucun besoin de caractéristiques conçues manuellement)
model.fit(train_images, train_labels, epochs=5,
validation_data=(test_images, test_labels))
# 4. Évaluer
test_loss, test_acc = model.evaluate(test_images, test_labels)
print(f"Précision du modèle d'apprentissage profond : {test_acc:.2f}")
Comparaison des résultats d'exécution:
- Méthode traditionnelle : précision d'environ 60-70% (et règles complexes)
- Apprentissage automatique : précision d'environ 85-92% (nécessite des caractéristiques conçues manuellement)
- Apprentissage profond : précision d'environ 98-99% (apprend automatiquement les caractéristiques)