Introduction à l'apprentissage automatique
L'apprentissage automatique est une branche de l'intelligence artificielle (IA) qui permet aux systèmes informatiques d'apprendre automatiquement et d'améliorer leurs performances à l'aide de données et d'algorithmes.
L'apprentissage automatique est un domaine en constante évolution qui change notre façon d'interagir avec la technologie et fournit de nouveaux outils et méthodes pour résoudre des problèmes complexes.
L'apprentissage automatique est une technique qui permet aux ordinateurs d'apprendre à partir de données et est largement appliquée dans diverses industries.
Imaginez que vous apprenez à un enfant à reconnaître différents animaux. Vous n'avez pas besoin d'expliquer des règles complexes comme « tous les chats ont deux oreilles, quatre pattes, des moustaches... » Au lieu de cela, vous lui montrez de nombreuses images de chats et lui dites « ceci est un chat ». Peu à peu, l'enfant peut reconnaître des chats qu'il n'a jamais vus auparavant.
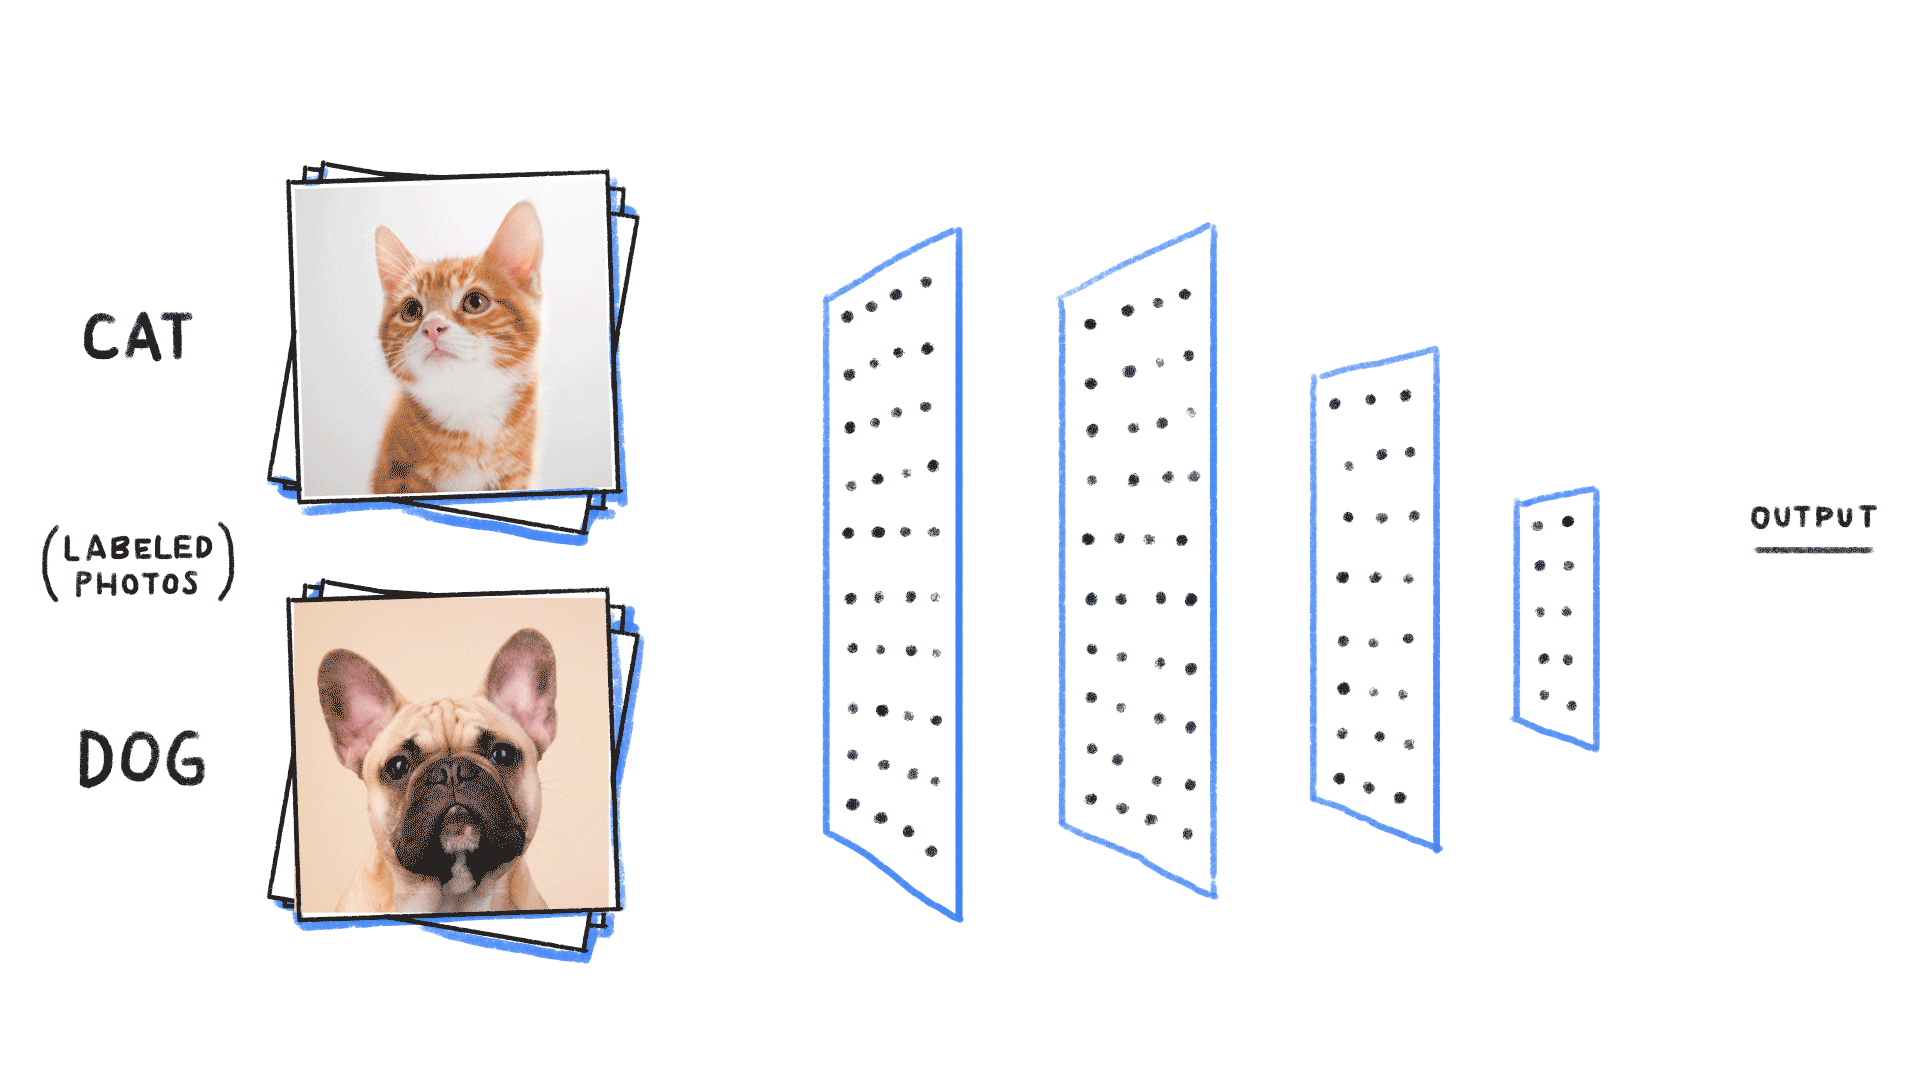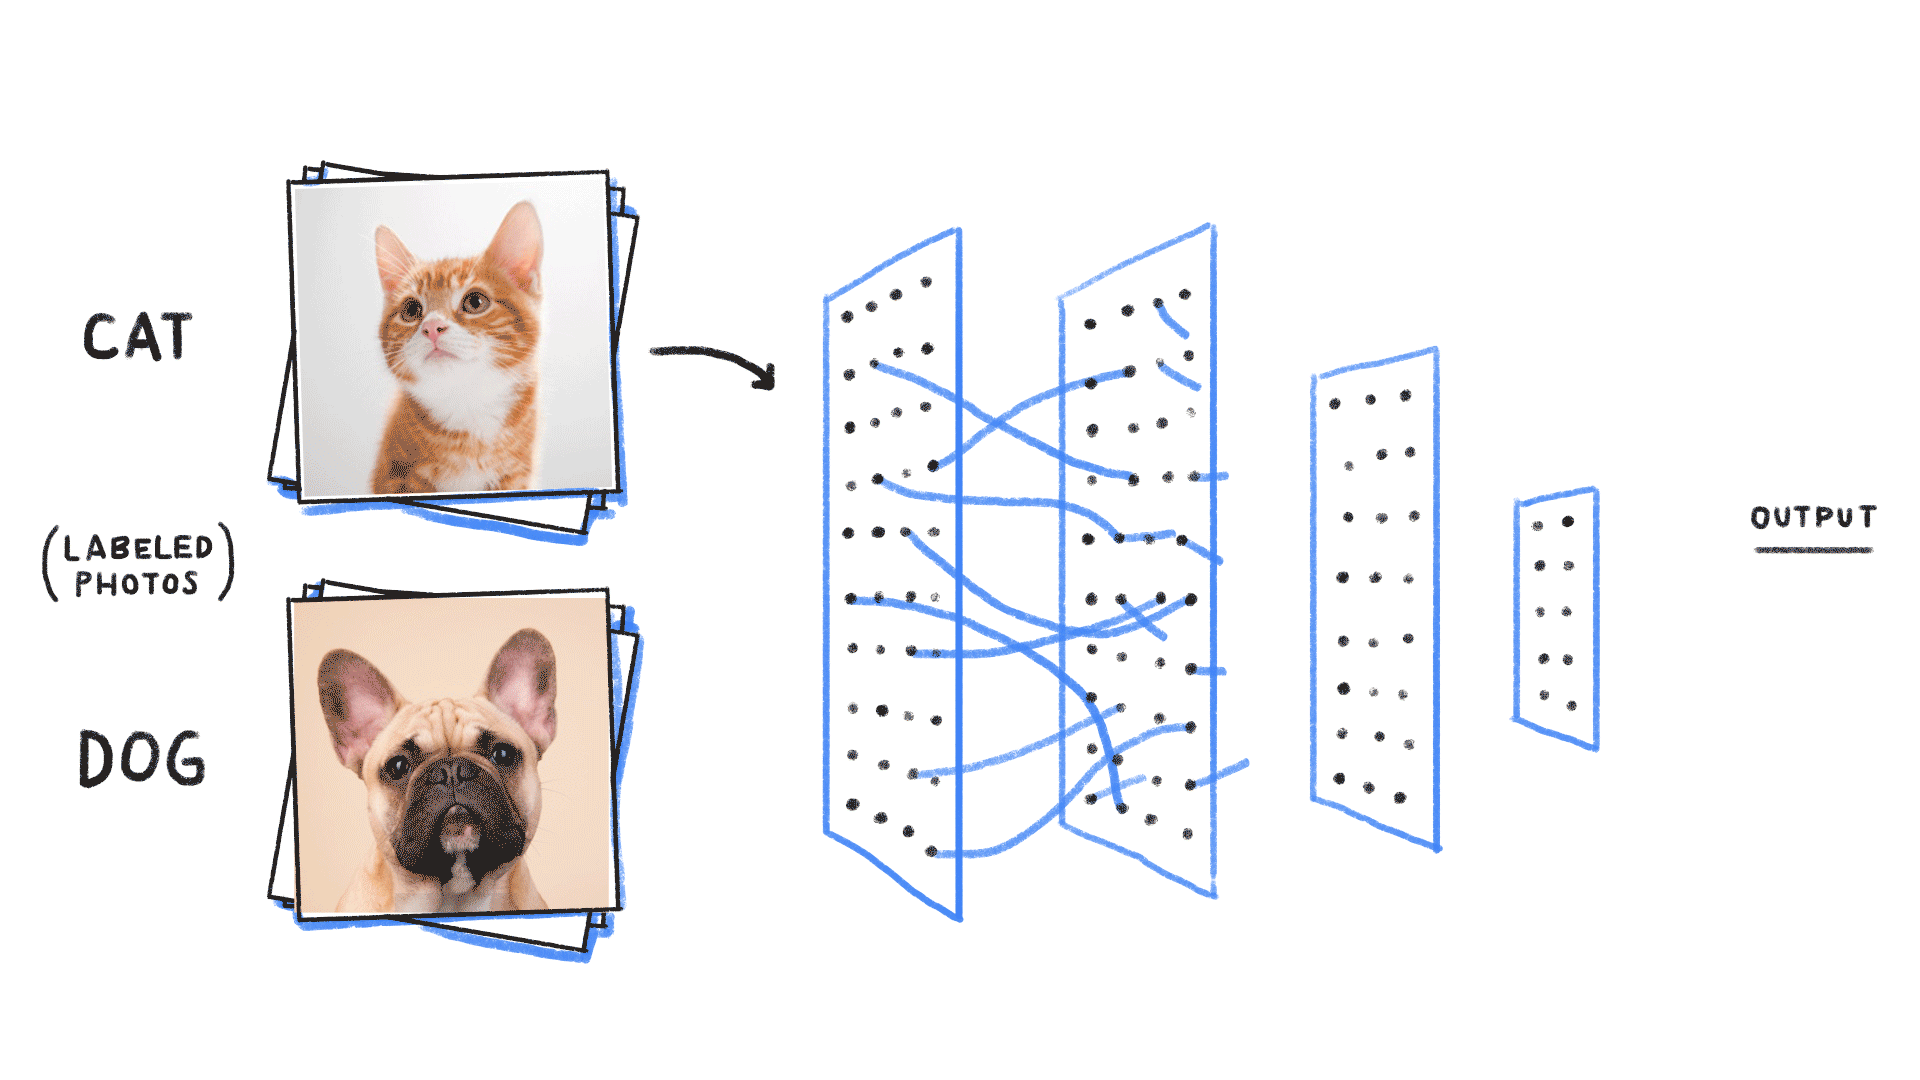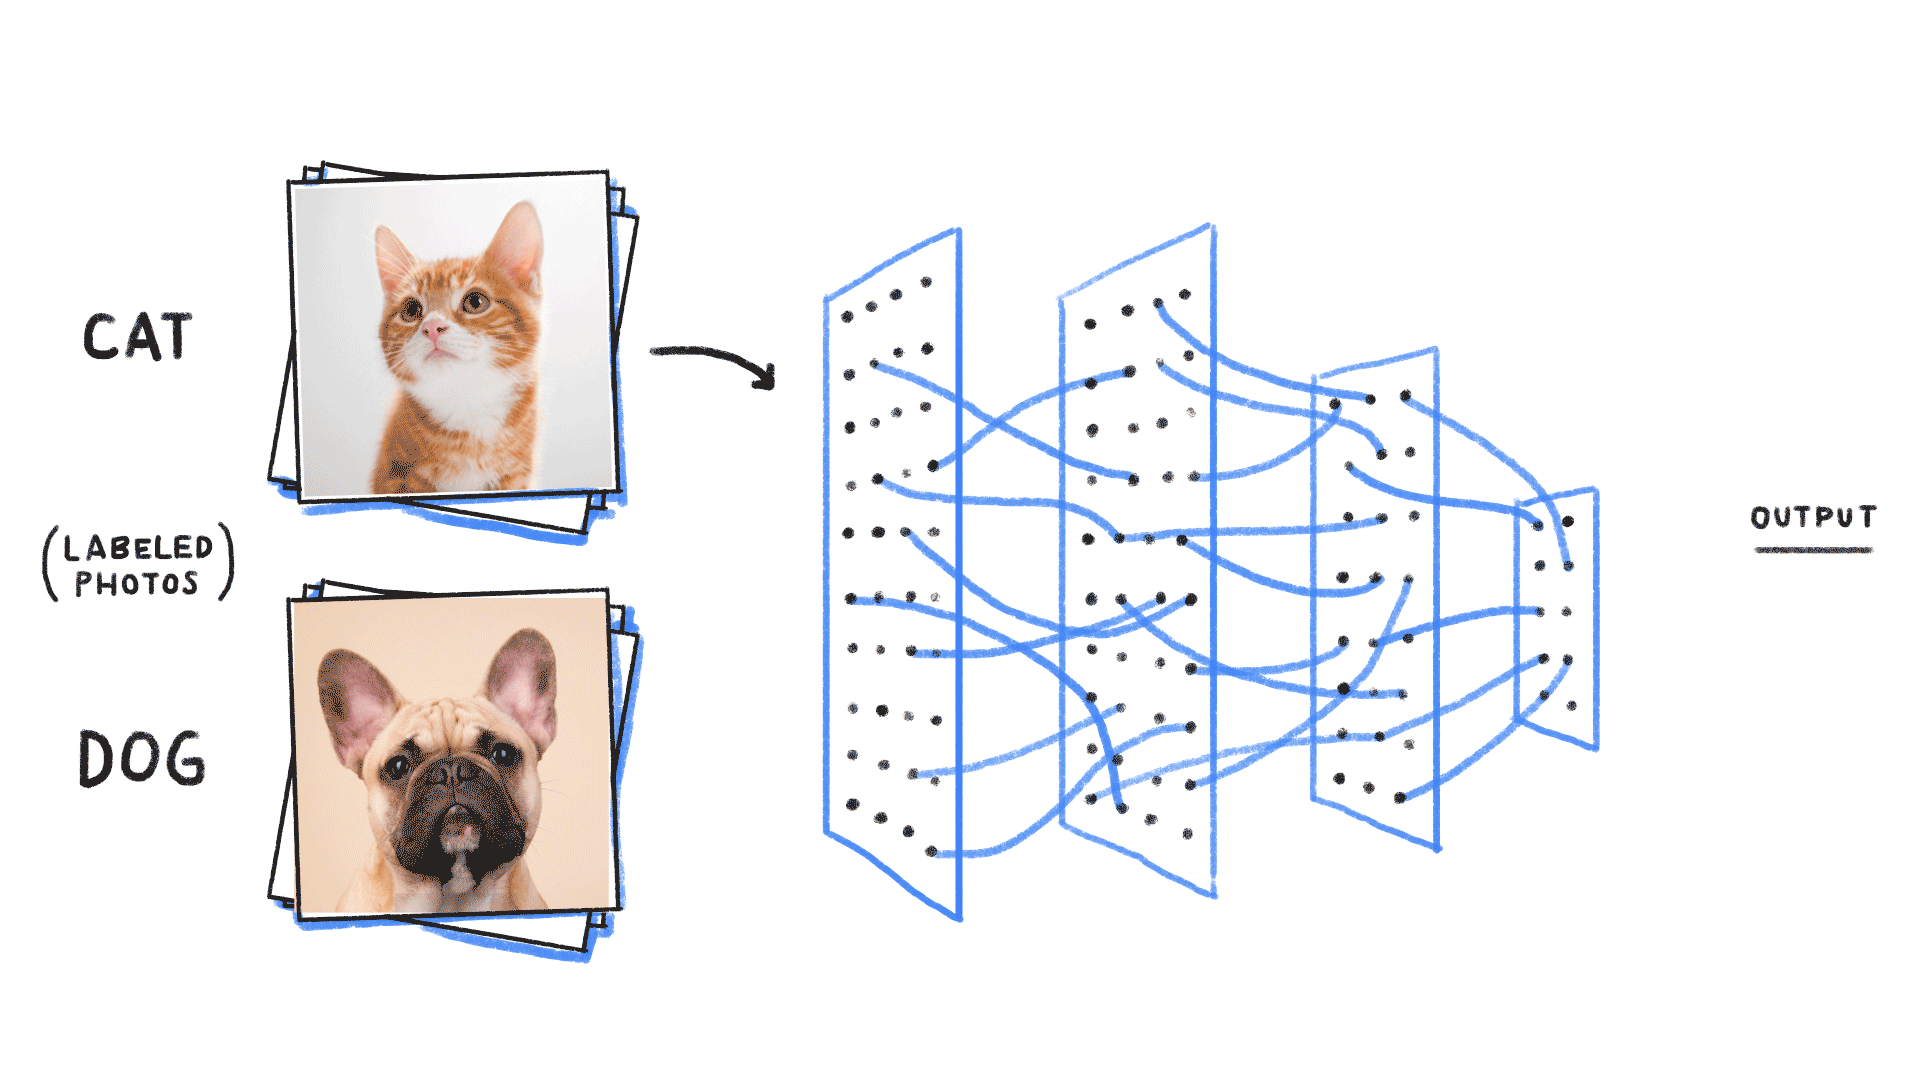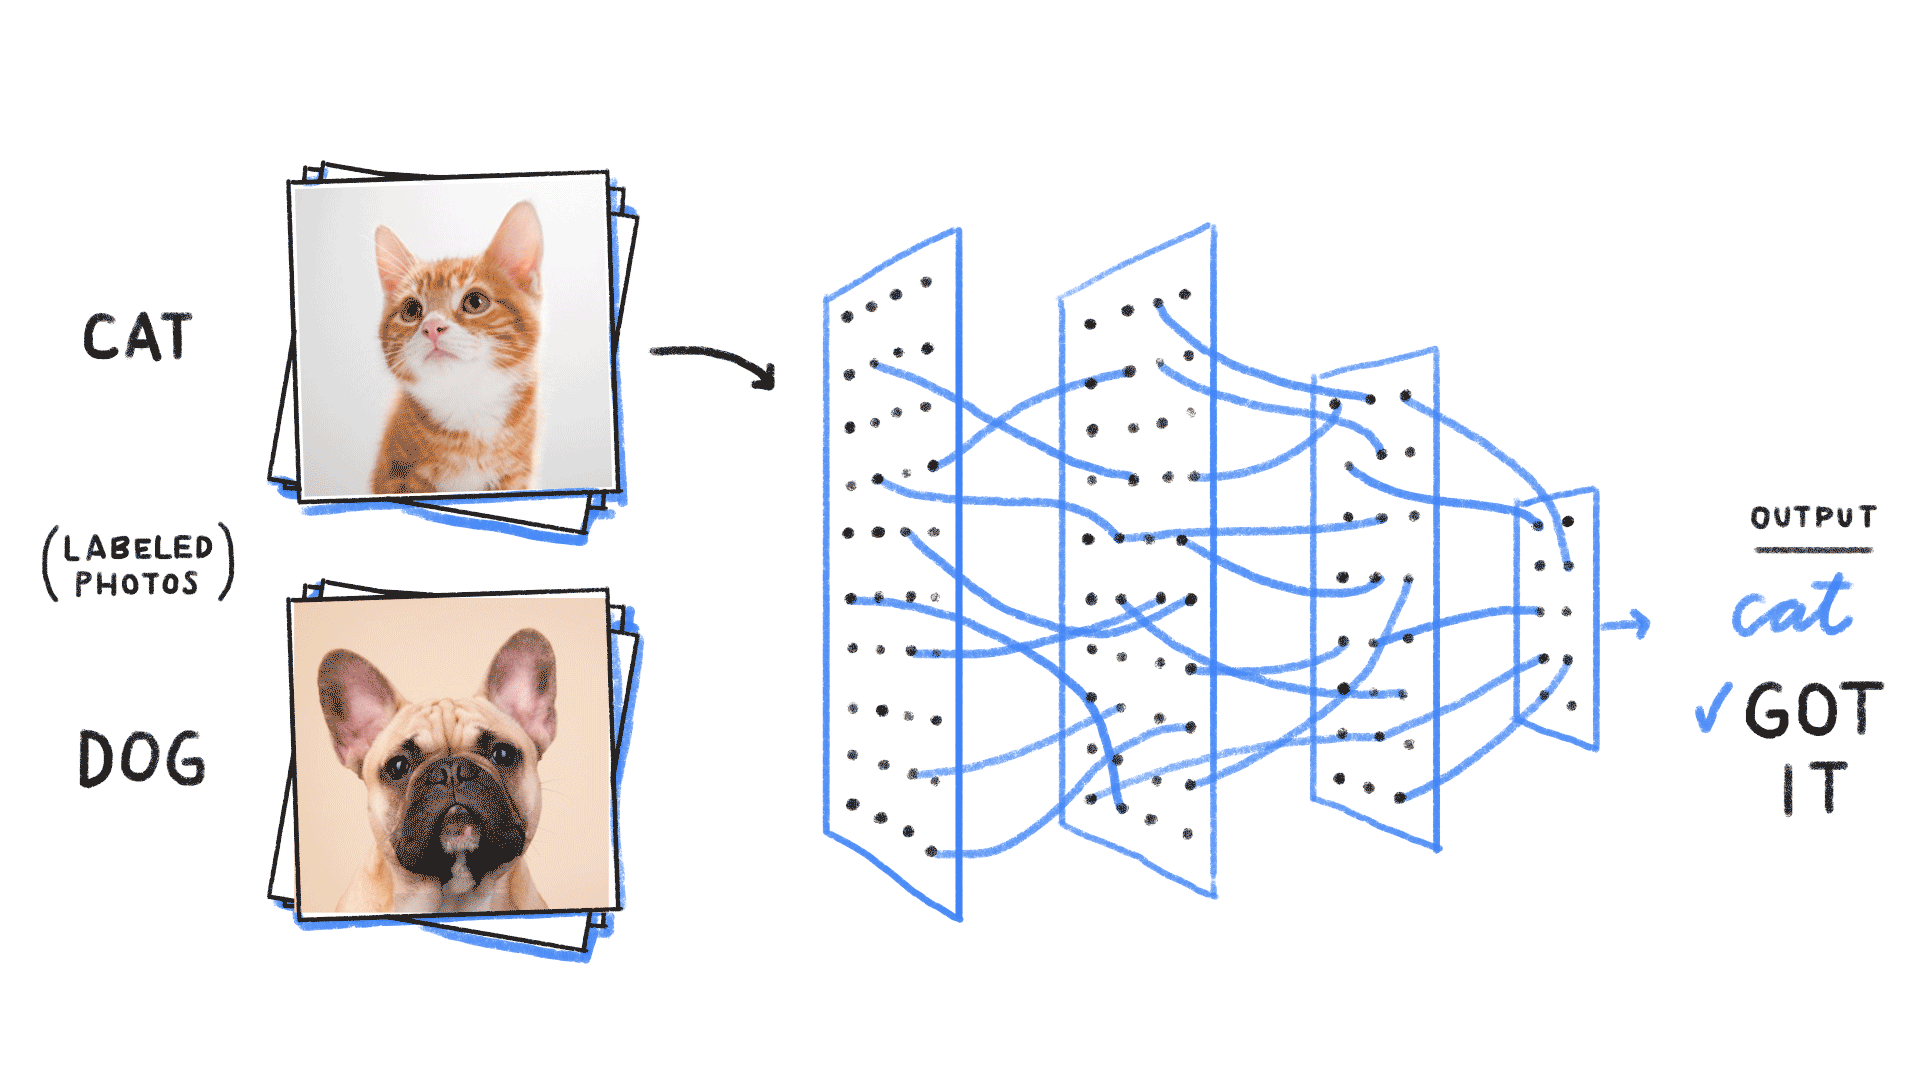
L'apprentissage automatique est exactement une telle méthode permettant aux ordinateurs d'apprendre : au lieu d'écrire directement des règles complexes, nous laissons les ordinateurs découvrir automatiquement des motifs et des régularités à partir de grandes quantités de données.
Comment fonctionne l'apprentissage automatique ?
L'apprentissage automatique prend des décisions et effectue des prédictions en permettant aux ordinateurs d'apprendre des motifs et des régularités à partir de grandes quantités de données.
- Tout d'abord, collectez et préparez les données, puis choisissez un algorithme approprié pour entraîner le modèle.
- Ensuite, le modèle optimise continuellement les paramètres afin de minimiser les erreurs de prédiction jusqu'à ce qu'il puisse prédire avec précision de nouvelles données.
- Enfin, le modèle est déployé dans des applications réelles, réalisant des prédictions ou des décisions en temps réel, et est mis à jour en fonction de nouvelles données.
L'apprentissage automatique est un processus itératif qui peut nécessiter de multiples ajustements des paramètres du modèle et de la sélection des caractéristiques afin d'améliorer les performances du modèle.
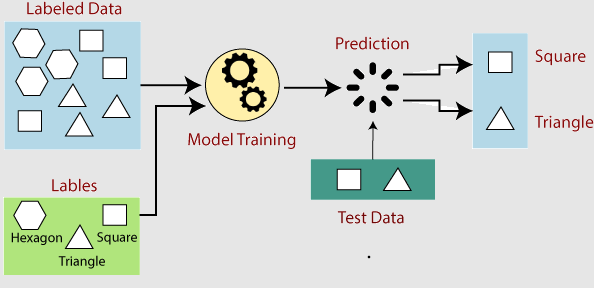
Le diagramme suivant illustre le flux de travail de base de l'apprentissage automatique :
-
Données étiquetées:: La zone bleue de la figure montre des données étiquetées, qui comprennent différentes formes géométriques (telles que des hexagones, des carrés, des triangles).
-
Entraînement du modèle:: À cette étape, l'algorithme d'apprentissage automatique analyse les caractéristiques des données et apprend à prédire les étiquettes en fonction de ces caractéristiques.
-
Données de test:: La zone vert foncé de la figure montre des données de test, comprenant un carré et un triangle.
-
Prédiction:: Le modèle utilise les règles apprises à partir des données d'entraînement pour prédire les étiquettes des données de test. Dans la figure, le modèle prédit le carré et le triangle dans les données de test.
-
Évaluation:: Les résultats de prédiction sont comparés aux étiquettes réelles des données de test pour évaluer la précision du modèle.
Le flux de travail de l'apprentissage automatique peut être grossièrement divisé selon les étapes suivantes :
1. Collecte de données
- Collecter des données: Il s'agit de la première étape d'un projet d'apprentissage automatique, impliquant la collecte de données pertinentes. Les données peuvent provenir de bases de données, de fichiers, du web ou de flux de données en temps réel.
- Types de données: Ils peuvent être des données structurées (telles que des données tabulaires) ou des données non structurées (telles que du texte, des images, des vidéos).
2. Prétraitement des données
- Nettoyage des données: Gérer les valeurs manquantes, les valeurs aberrantes, les erreurs et les données dupliquées.
- Ingénierie des caractéristiques: Sélectionner les caractéristiques les plus pertinentes qui aident le modèle à apprendre, ce qui peut inclure la création de nouvelles caractéristiques ou la transformation de caractéristiques existantes.
- Standardisation/normalisation des données: Ajuster l'échelle des données pour les ramener dans la même plage, ce qui bénéficie aux performances de certains algorithmes.
3. Sélection du modèle
- Déterminer le type de problème: Choisir un modèle d'apprentissage automatique approprié en fonction de la nature du problème (classification, régression, regroupement, etc.).
- Sélectionner un algorithme: En fonction du type de problème et des caractéristiques des données, sélectionner un ou plusieurs algorithmes pour l'expérimentation.
4. Entraînement du modèle
- Fractionner le jeu de données: Diviser les données en ensembles d'entraînement, de validation et de test.
- Entraînement: Utiliser les données de l'ensemble d'entraînement pour entraîner le modèle, en ajustant les paramètres du modèle afin de minimiser la fonction de perte.
- Validation: Utiliser l'ensemble de validation pour ajuster les paramètres du modèle et éviter le surapprentissage.
5. Évaluation du modèle
- Métriques de performance: Utiliser l'ensemble de test pour évaluer la performance du modèle. Les métriques courantes incluent la précision, le rappel, le score F1, etc.
- Validation croisée: Une technique d'évaluation de la capacité de généralisation d'un modèle en divisant les données en plusieurs sous-ensembles pour l'entraînement et la validation.
6. Optimisation du modèle
- Ajuster les hyperparamètres: Les hyperparamètres sont des paramètres définis avant le processus d'apprentissage, tels que le taux d'apprentissage, la profondeur de l'arbre, etc. Ils peuvent être réglés à l'aide de méthodes comme la recherche par grille, la recherche aléatoire ou l'optimisation bayésienne.
- Sélection de caractéristiques: Il peut être nécessaire de réévaluer et de sélectionner les caractéristiques pour améliorer la performance du modèle.
7. Déploiement du modèle
- Intégrer dans des applications: Intégrer le modèle entraîné dans des applications réelles, telles que des sites web, des applications mobiles ou des logiciels.
- Surveillance et maintenance: Surveiller en continu la performance du modèle et mettre à jour le modèle en fonction des nouvelles données.
8. Boucle de rétroaction
- Apprentissage continu: Les modèles d'apprentissage automatique peuvent être conçus pour apprendre automatiquement à partir de nouvelles données au fil du temps afin de s'adapter aux changements.
Détails techniques
- Fonction de perte: Une fonction qui mesure la différence entre les prédictions du modèle et les résultats réels. L'objectif de l'entraînement du modèle est de minimiser cette fonction.
- Algorithme d'optimisation: Tel que la descente de gradient, utilisé pour trouver les valeurs de paramètres qui minimisent la fonction de perte.
- Régularisation: technique qui empêche le surapprentissage du modèle en ajoutant des termes de pénalité.
Le flux de travail d’apprentissage automatique est itératif et peut nécessiter de multiples ajustements et optimisations pour atteindre les meilleures performances. De plus, avec l’accumulation des données et le développement des algorithmes, les modèles d’apprentissage automatique peuvent devenir plus précis et plus efficaces.
Types d’apprentissage automatique
L’apprentissage automatique se divise principalement en trois types suivants :
1. Apprentissage supervisé
- Définition :L’apprentissage supervisé désigne l’entraînement avec des données étiquetées, où le modèle apprend la relation entre les données d’entrée et les étiquettes afin de faire des prédictions ou des classifications.
- Applications :Classification (par ex., détection de spam), régression (par ex., prédiction du prix des maisons).
- Exemples :Régression linéaire, arbres de décision, machines à vecteurs de support (SVM).
2. Apprentissage non supervisé
- Définition :L’apprentissage non supervisé utilise des données non étiquetées, et le modèle tente de découvrir des structures ou des motifs sous-jacents dans les données.
- Applications :Regroupement (par ex., segmentation de la clientèle), réduction de dimensionnalité (par ex., visualisation de données).
- Exemples :Partitionnement K-means, analyse en composantes principales (ACP).
3. Apprentissage par renforcement
- Définition :L’apprentissage par renforcement implique d’interagir avec l’environnement, où un agent apprend la stratégie optimale par essai-erreur afin de maximiser les récompenses à long terme. Après chaque action, le système reçoit une récompense ou une pénalité pour guider l’amélioration du comportement.
- Applications :IA de jeu (par ex., AlphaGo), conduite autonome, contrôle de robots.
- Exemples :Q-learning, réseau Q profond (DQN).

Ces trois types d'apprentissage automatique ont chacun leurs propres scénarios d'application et avantages. L'apprentissage supervisé convient aux données avec des étiquettes claires, l'apprentissage non supervisé convient à l'exploration de la structure sous-jacente des données, et l'apprentissage par renforcement convient aux scénarios où la stratégie optimale doit être apprise par essais et erreurs.
Domaines d'application de l'apprentissage automatique
Systèmes de recommandation :Par exemple, Douyin recommande des vidéos qui pourraient vous intéresser, Taobao recommande des produits que vous pourriez acheter, et NetEase Cloud Music recommande de la musique que vous aimez.
Traitement du langage naturel (NLP) :Applications de l'apprentissage automatique dans la reconnaissance vocale, la traduction automatique, l'analyse des sentiments, les chatbots, etc. Par exemple, Google Translate, Siri et le service client intelligent.
Vision par ordinateur :L'apprentissage automatique est largement utilisé dans la reconnaissance d'images, la détection d'objets, la reconnaissance faciale, la conduite autonome et d'autres domaines. Par exemple, les voitures autonomes utilisent des caméras et des capteurs pour identifier les obstacles environnants, les piétons et les autres véhicules.
Analyse financière :L'apprentissage automatique a des applications importantes en finance, comme la prévision des marchés boursiers, l'évaluation du crédit et la détection de fraude. Par exemple, les banques utilisent l'apprentissage automatique pour détecter les transactions frauduleuses par carte de crédit.
Santé :L'apprentissage automatique aide les médecins à diagnostiquer des maladies, à découvrir des effets secondaires de médicaments, à prédire l'évolution des maladies, etc. Par exemple, le système Watson d'IBM aide les médecins à analyser les données des dossiers médicaux des patients et fournit des recommandations de diagnostic et de traitement.
Jeux et divertissement :L'apprentissage automatique n'est pas seulement utilisé pour des adversaires intelligents dans les jeux, mais aussi appliqué dans la conception de jeux, l'ajustement dynamique de la difficulté et d'autres domaines. Par exemple, AlphaGo a utilisé des techniques d'apprentissage profond pour battre le champion du monde de Go.
L'avenir de l'apprentissage automatique
Avec la croissance explosive du volume des données et l'amélioration de la puissance de calcul, les applications de l'apprentissage automatique continueront de s'étendre, apportant des systèmes plus intelligents et plus efficaces. Par exemple :
Apprentissage par renforcement :Il permet aux ordinateurs de résoudre des problèmes complexes par essais et erreurs, sans indication explicite. Par exemple, AlphaGo et l'IA du jeu Dota 2 utilisent tous deux l'apprentissage par renforcement.
Apprentissage auto-supervisé :Les modèles d'apprentissage automatique actuels nécessitent généralement une grande quantité de données étiquetées pour l'entraînement, tandis que l'apprentissage auto-supervisé peut apprendre des représentations plus efficaces à partir de données non étiquetées.
Apprentissage profond :L'apprentissage profond est une branche de l'apprentissage automatique qui se concentre sur l'application des réseaux de neurones. Il a réalisé des avancées décisives dans la reconnaissance d'images, le traitement du langage naturel et d'autres domaines. À l'avenir, l'apprentissage profond continuera de propulser le développement de l'intelligence artificielle.
Grâce à l'apprentissage automatique, nous pouvons créer des systèmes plus intelligents, automatiser des tâches fastidieuses et améliorer divers aspects de notre vie quotidienne. Avec l'évolution de la technologie, l'apprentissage automatique deviendra l'un des principaux moteurs de diverses industries à l'avenir.
Autres extensions