Nettoyage des données
En apprentissage automatique, on entend souvent l'adage : « Données de mauvaise qualité en entrée, résultats de mauvaise qualité en sortie ». Cela illustre de manière frappante l'impact décisif de la qualité des données sur les performances du modèle.
Imaginez que vous êtes un chef préparant un délicieux repas. Même si vos talents culinaires sont exceptionnels, si les ingrédients ne sont pas frais, contiennent de la saleté ou sont incomplets, le plat final sera inévitablement grandement compromis.
En apprentissage automatique,les données brutessont notre « ingrédient », etle nettoyage des donnéesest ce processus crucial de « préparation ». Il vise à identifier, corriger ou supprimer les erreurs, incohérences, doublons et parties incomplètes dans les données, préparant des « ingrédients » propres et de haute qualité pour la « cuisson » ultérieure du modèle.
Cet article vous présentera systématiquement les concepts clés et les méthodes courantes du nettoyage des données, et, à travers des exemples de code clairs, vous aidera à maîtriser cette compétence essentielle pour les spécialistes des données.
1. Pourquoi le nettoyage des données est-il si important ?
Avant de plonger dans les détails techniques, comprenons d'abord pourquoi le nettoyage des données est une partie indispensable du flux de travail en apprentissage automatique.
1.1 Améliorer les performances et la précision du modèle
Les données sales (telles que les valeurs aberrantes et les valeurs erronées) peuvent induire le modèle en erreur en lui faisant apprendre des motifs incorrects. Les données nettoyées permettent au modèle de capturer plus précisément les vrais motifs dans les données, et donc de faire des prédictions plus fiables.
1.2 Garantir la fiabilité des résultats d'analyse
Que ce soit pour l'analyse exploratoire des données ou pour les décisions commerciales finales, les conclusions tirées de données erronées sont dangereuses. Le nettoyage des données garantit une base solide et fiable pour l'analyse.
1.3 Améliorer la stabilité de l'algorithme
De nombreux algorithmes d'apprentissage automatique sont très sensibles à la qualité des données. Par exemple, les algorithmes basés sur la distance (tels que KNN et SVM) sont fortement affectés par les valeurs aberrantes, et les valeurs manquantes peuvent rendre tout un échantillon inutilisable.
1.4 Économiser les ressources de calcul et le temps
Éliminer les données non pertinentes et en double peut réduire la taille de l'ensemble de données, ce qui diminue le coût de calcul et le temps d'entraînement du modèle.
Pour mieux comprendre la position du nettoyage des données dans le processus global d'apprentissage automatique, consultez l'organigramme suivant :
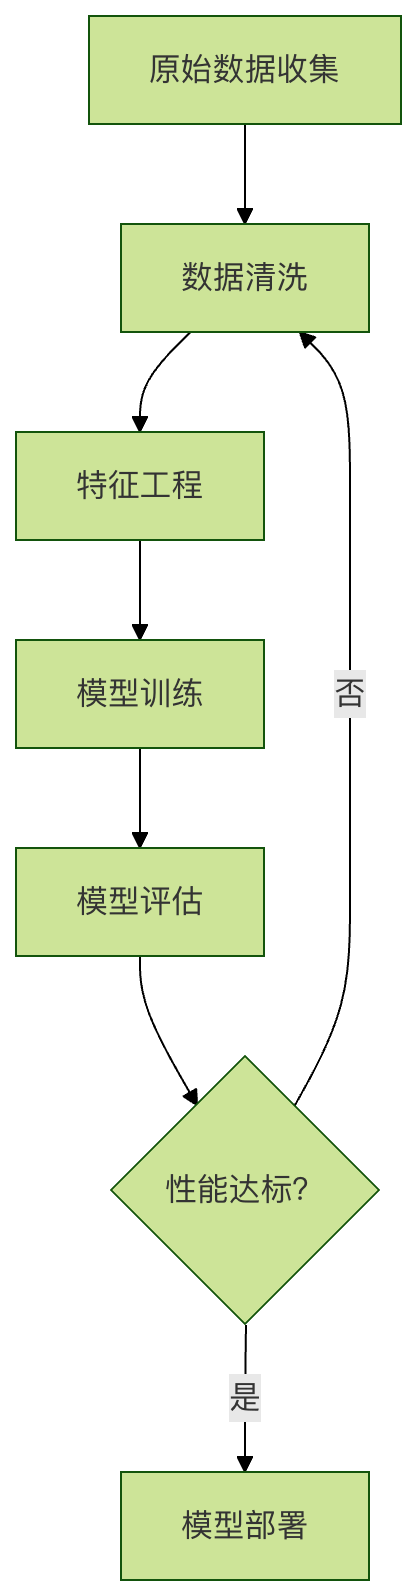
Comme le montre la figure ci-dessus, le nettoyage des données est la première étape du prétraitement, et lorsque les performances du modèle sont mauvaises, nous devons souvent revenir à cette étape pour inspecter et améliorer la qualité des données.
2. Problèmes de données courants et stratégies de nettoyage
Le nettoyage des données traite généralement les problèmes courants suivants. Nous pouvons les comprendre rapidement à l'aide d'un tableau simple :
| Type de problème | Description | Impact possible | Stratégies de nettoyage courantes |
|---|---|---|---|
| Valeurs manquantes | Certains champs d'un enregistrement de données ont des valeurs vides (NaN, NULL). | Entraîne le rejet d'échantillons, une perte d'informations et des erreurs de calcul. | Supprimer, remplir (moyenne/médiane/mode/prédiction). |
| Valeurs aberrantes | Valeurs extrêmes qui s'écartent significativement de la plupart des données. | Faussent les résultats statistiques et affectent les performances du modèle. | Identifier (IQR, Z-Score), puis supprimer ou corriger. |
| Valeurs dupliquées | Des enregistrements identiques existent dans le jeu de données. | Provoque un biais excessif du modèle en faveur des échantillons dupliqués, ce qui affecte sa capacité de généralisation. | Identifier et supprimer les doublons. |
| Incohérences | Les formats de données, unités ou encodages sont incohérents (par exemple, "male", "Male", "M"). | Entraîne des erreurs de regroupement et d'analyse. | Standardiser, normaliser, mapper/convertir. |
| Valeurs erronées | Valeurs clairement illogiques (par exemple, l'âge est -1 ou 300 ans). | Produit des résultats d'analyse dénués de sens. | Corriger selon la logique métier ou définir comme manquant. |
Ensuite, nous utiliserons la bibliothèque de Pythonpandasetnumpypour démontrer comment résoudre ces problèmes avec un code spécifique.
3. Mise en pratique : nettoyage des données avec Python
Supposons que nous ayons uncustomer_data.csvjeu de données client contenant quelques problèmes typiques de qualité des données.
3.1 Préparation de l'environnement et chargement des données
Tout d'abord, assurez-vous d'avoir installé les bibliothèques nécessaires, puis chargez les données.
Exemple
import pandas as pd
import numpy as np
# Charger le jeu de données
df = pd.read_csv('customer_data.csv') # Remplacer par votre chemin de fichier
# Afficher les informations de base et les premières lignes des données
print(Dimensions du jeu de données (lignes, colonnes) :, df.shape)
print("\nLes 5 premières lignes des données :)
print(df.head())
print("\nInformations de base sur les données :)
print(df.info())
print("\nDescription statistique des données :)
print(df.describe())
3.2 Gestion des valeurs manquantes
Trouver les valeurs manquantes est la première étape.pandasfournit des méthodes pratiques.
Exemple
print(Nombre de valeurs manquantes par colonne :)
print(df.isnull().sum())
# 2. Gérer les valeurs manquantes - Méthode 1 : Suppression
# Supprimer toutes les lignes contenant des valeurs manquantes (adapté lorsqu'il y a peu de valeurs manquantes)
df_dropped = df.dropna()
print(f"\nAprès suppression des valeurs manquantes, dimensions des données : {df_dropped.shape})
# 3. Gérer les valeurs manquantes - Méthode 2 : Imputation
# Une méthode plus courante consiste à imputer en fonction des caractéristiques de la colonne
df_filled = df.copy()
# Pour les colonnes numériques (par ex., 'Age'), remplir avec la médiane (plus robuste aux valeurs aberrantes que la moyenne)
if 'Age' in df_filled.columns:
df_filled['Age'].fillna(df_filled['Age'].median(), inplace=True)
# Pour les colonnes catégorielles (par ex., 'City'), remplir avec le mode (la valeur la plus fréquente)
if 'City' in df_filled.columns:
df_filled['City'].fillna(df_filled['City'].mode()[0], inplace=True)
# Pour les colonnes susceptibles de changer au fil du temps (par ex., 'Last Purchase Amount'), il est parfois plus logique, d'un point de vue métier, de remplir avec 0
if 'Last Purchase Amount' in df_filled.columns:
df_filled['Last Purchase Amount'].fillna(0, inplace=True)
print("\nAprès imputation des valeurs manquantes, nombre de valeurs manquantes par colonne :)
print(df_filled.isnull().sum())
3.3 Identification et traitement des valeurs aberrantes
Le traitement des valeurs aberrantes nécessite de la prudence, car elles représentent parfois des événements spéciaux importants.
Exemple
if 'Annual Income' in df_filled.columns:
# Méthode 1 : Utiliser la méthode de l'écart interquartile (IQR) pour identifier
Q1 = df_filled['Annual Income'].quantile(0.25)
Q3 = df_filled['Annual Income'].quantile(0.75)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR
# Trouver les valeurs aberrantes
outliers = df_filled[(df_filled['Annual Income'] < lower_bound) | (df_filled['Annual Income'] > upper_bound)]
print(f"\nNombre de valeurs aberrantes de 'Annual Income' trouvées avec la méthode IQR : {len(outliers)})
# Gérer les valeurs aberrantes : Ici, nous choisissons de les écrêter en utilisant les bornes inférieure et supérieure (winsorisation)
df_filled['Annual Income'] = np.where(df_filled['Annual Income'] > upper_bound, upper_bound,
np.where(df_filled['Annual Income'] < lower_bound, lower_bound, df_filled['Annual Income']))
print(Les valeurs aberrantes de 'Annual Income' ont été écrêtées.)
3.4 Gestion des valeurs dupliquées
Les enregistrements dupliqués augmentent la charge de calcul et peuvent introduire un biais.
Exemple
duplicate_rows = df_filled.duplicated()
print(f"\nNombre de lignes entièrement dupliquées trouvées : {duplicate_rows.sum()})
# Supprimer ces lignes dupliquées, en ne conservant que la première occurrence
df_cleaned = df_filled.drop_duplicates()
print(fAprès suppression des valeurs dupliquées, dimensions des données : {df_cleaned.shape})
3.5 Gestion des incohérences
Assurez la cohérence des formats et des valeurs des données.
Exemple
if 'City' in df_cleaned.columns:
df_cleaned['City'] = df_cleaned['City'].str.title()
# 2. Mapper les valeurs unifiées : par exemple, uniformiser les informations de genre en 'Male' et 'Female'
if 'Gender' in df_cleaned.columns:
gender_mapping = {'male': 'Male', 'female': 'Female', 'M': 'Male', 'F': 'Female'}
df_cleaned['Gender'] = df_cleaned['Gender'].replace(gender_mapping)
# Vous pouvez également utiliser la fonction .map(), mais .replace() est plus flexible, car les valeurs non spécifiées restent inchangées
# 3. Convertir les types de données : assurez-vous que les colonnes numériques sont de type numérique
if 'Age' in df_cleaned.columns:
df_cleaned['Age'] = pd.to_numeric(df_cleaned['Age'], errors='coerce') # errors='coerce' convertit les erreurs en NaN
# Après la conversion, vous pouvez à nouveau utiliser la médiane pour remplir les nouveaux NaN générés par la conversion
df_cleaned['Age'].fillna(df_cleaned['Age'].median(), inplace=True)
print("\nNettoyage des données terminé ! Affichez les 5 premières lignes des données nettoyées : ")
print(df_cleaned.head())
4. Résumé et bonnes pratiques
Grâce aux étapes ci-dessus, nous avons effectué un cycle de nettoyage de base des données. Rappelez-vous, le nettoyage des données n'est pas une étape unique, mais un processus itératif. Voici quelques bonnes pratiques :
- Explorez d'abord, puis nettoyez: Avant de commencer le nettoyage, assurez-vous d'utiliser
df.describe()、df.info(), la visualisation (telle que les histogrammes, les boîtes à moustaches) et d'autres méthodes pour bien comprendre vos données. - Sauvegardez les données d'origine: conservez toujours une copie des données d'origine, non modifiées. Toutes les opérations de nettoyage doivent être effectuées sur la copie.
- Consignez les étapes de nettoyage: documentez votre logique de nettoyage (par ex., pourquoi utiliser l'imputation par la médiane, comment déterminer les limites des valeurs aberrantes). Cela est crucial pour la reproductibilité du projet et la collaboration en équipe.
- Combinez avec la logique métier: le nettoyage des données n'est pas une opération purement mathématique. Par exemple, « age=0 » est une erreur dans des données démographiques, mais peut être raisonnable dans des données de produits pour nourrissons. Maintenez toujours la communication avec les experts du domaine.
- Procédez de manière itérative: après le nettoyage, passez à l'étape de modélisation. Si le modèle donne de mauvais résultats, revenez en arrière et vérifiez la qualité des données, et vous devrez peut-être ajuster la stratégie de nettoyage.
Le nettoyage des données peut représenter une partie du60%-80%temps d'un projet de science des données. Bien que fastidieux, il est la pierre angulaire de la construction de modèles d'apprentissage automatique puissants et fiables.
Autres extensions