Apprentissage automatique - Segmentation de la clientèle
Dans le monde actuel des affaires guidé par les données, comprendre les clients est la clé du succès.
Cependant, lorsque votre base de clients atteint des dizaines de milliers, voire des millions, analyser manuellement les caractéristiques et les schémas comportementaux de chaque client devient irréaliste.
À ce stade, les techniques d'apprentissage automatique, en particulierl'apprentissage non superviséet les algorithmes de clustering qu'il contient, deviennent un outil puissant.
La segmentation client, également appelée segmentation de la clientèle, a pour objectif central de diviser la large base de clients en plusieurs sous-groupes aux caractéristiques similaires. C'est comme un propriétaire de magasin expérimenté qui ne traite plus les clients comme un ensemble vague, mais qui peut clairement identifier différents groupes tels que les familles soucieuses du rapport qualité-prix, les passionnés de technologie friands de nouveaux produits et les clients haut de gamme attachés à l'expérience de service. En adoptant des stratégies de marketing, de service et de produit ciblées pour différents groupes, les entreprises peuvent considérablement améliorer leur efficacité opérationnelle et la satisfaction client.
Cet article vous guidera pas à pas à travers un projet pratique complet de segmentation client. Nous utiliserons l'algorithme classique de clustering K-Means pour analyser un jeu de données simulé de clients de détail, de la compréhension des données à l'évaluation du modèle, afin d'obtenir finalement des résultats de segmentation porteurs d'enseignements métier.
Comprendre l'analyse de regroupement et l'algorithme K-Means
Avant de commencer la pratique, nous devons comprendre les outils essentiels que nous allons utiliser.
Qu'est-ce que l'analyse de regroupement ?
L'analyse de regroupement est une méthode d'apprentissage non supervisé. Contrairement à l'apprentissage supervisé (comme la prédiction du prix des maisons ou l'identification d'images de chats et de chiens), les algorithmes de clustering n'ont pas de « bonnes réponses » préétiquetées (c'est-à-dire d'étiquettes). Leur tâche consiste à explorer la structure inhérente des données, en regroupant automatiquement les points de données similaires dans un même groupe (appelé « cluster »), tout en rendant les points de données de groupes différents aussi dissemblables que possible.
Une analogie simple: Imaginez que vous avez un panier de fruits mélangés contenant des pommes, des oranges et des bananes. La tâche de l'algorithme de clustering est de regrouper automatiquement les fruits similaires en forme, en couleur et en taille, sans que personne ne vous indique les noms des catégories.
Comment fonctionne l'algorithme K-Means
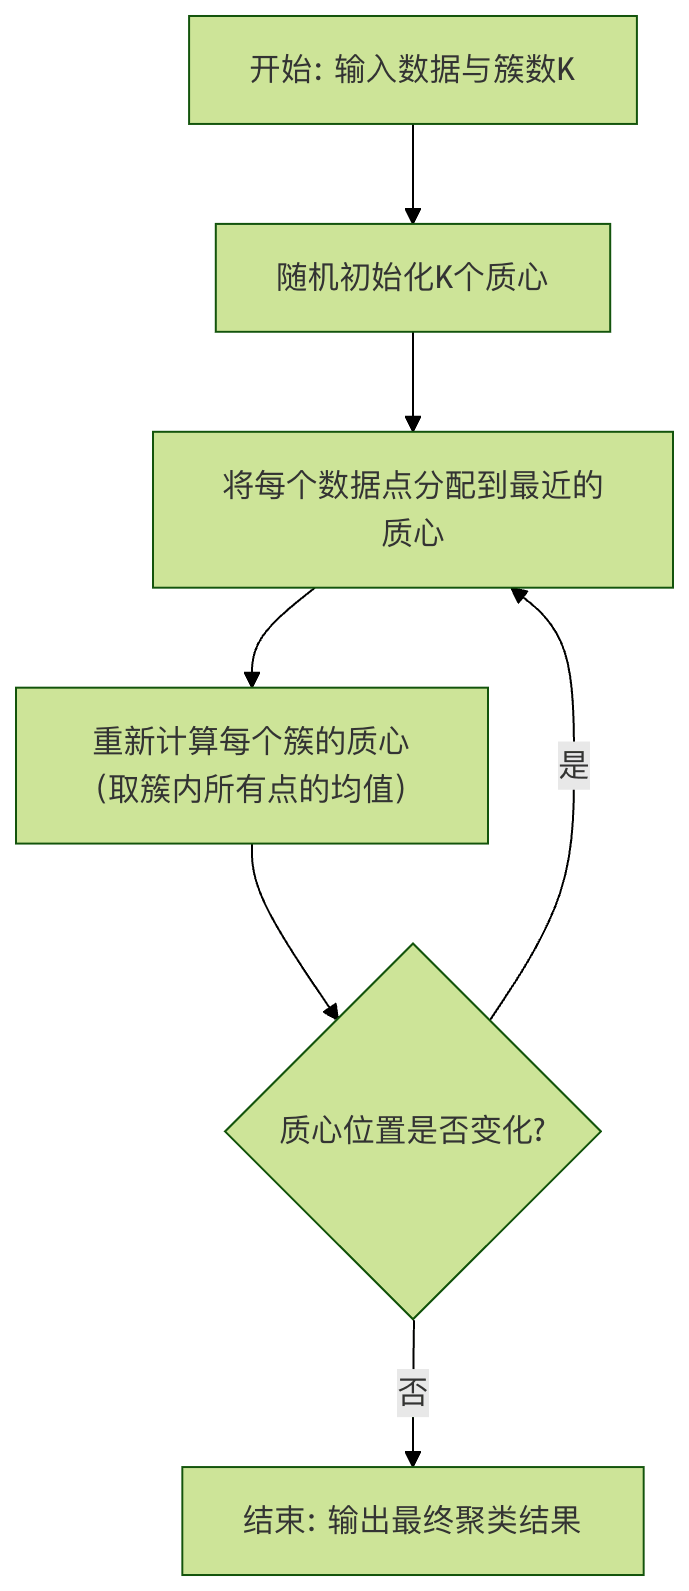
K-Means est l'un des algorithmes de clustering les plus couramment utilisés et intuitifs. « K » représente le nombre de clusters dans lesquels nous voulons diviser les données. Son principe de fonctionnement peut être résumé en quatre étapes :
- Initialisation: Sélectionner aléatoirement K points de données comme « centres de clusters » initiaux (centroïdes).
- Affectation: Calculer la distance de chaque point de données à chaque centroïde (généralement en utilisant la distance euclidienne), puis affecter chaque point au cluster du centroïde le plus proche.
- Mise à jour: Recalculer le centroïde de chaque cluster (c'est-à-dire la moyenne de tous les points de ce cluster).
- Itération: Répéter les étapes 2 et 3 jusqu'à ce que les positions des centroïdes ne changent plus significativement, ou que le nombre d'itérations prédéfini soit atteint.
L'organigramme ci-dessous illustre clairement ce processus :
Points clés de l'algorithme:
- Métrique de distance: Habituellement, la distance euclidienne est utilisée pour mesurer la similarité entre les points de données ; plus la distance est faible, plus la similarité est élevée.
- Centroïde: Représente le « point moyen » ou le centre d'un cluster.
- Objectif: Minimiser la somme des distances au carré entre les points de données et leur centroïde au sein de chaque cluster (appelée « somme des carrés intra-cluster » ou inertie).
Mise en pratique : Segmentation de la clientèle de détail
Maintenant, mettons la théorie en pratique. Nous utiliserons Python et ses puissantes bibliothèques de l'écosystème de la science des données pour réaliser ce projet.
Étape 1 : Configuration de l'environnement et chargement des données
Tout d'abord, assurez-vous que les bibliothèques nécessaires sont installées dans votre environnement Python :pandaspour le traitement des données,numpypour le calcul numérique,matplotlibetseabornpour la visualisation,scikit-learnest la bibliothèque principale d'apprentissage automatique.
Exemple
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import silhouette_score
import warnings
warnings.filterwarnings('ignore') # Ignorer les avertissements non critiques
# Définir le style de visualisation
sns.set_style("whitegrid")
# -------------------------- Début de configuration de la police chinoise --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows en premier
'SimHei', 'Microsoft YaHei',
# macOS en premier
'PingFang SC', 'Heiti TC',
# Linux d'abord
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corriger le problème d'affichage des signes négatifs sous forme de carrés
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Fin de la configuration de la police chinoise --------------------------
Nous allons utiliser un jeu de données client simulécustomer_data.csv, qui contient généralement les caractéristiques suivantes :
CustomerID: Identifiant unique du clientAnnual_Income_(k$): Revenu annuel du client (en milliers de dollars)Spending_Score: Score de dépenses (0-100, calculé de manière exhaustive à partir de la fréquence d'achat, du montant, etc.)Age: Âge
Le contenu est le suivant :
CustomerID,Age,Annual_Income_(k$),Spending_Score
1,19,15,39
2,21,15,81
3,20,16,6
4,23,16,77
5,31,17,40
6,22,17,76
7,35,18,6
8,23,18,94
9,64,19,3
10,30,19,72
11,67,20,14
12,35,20,99
13,58,21,15
14,24,21,77
15,37,22,13
16,22,22,79
17,35,23,35
18,20,23,66
19,52,24,29
20,35,24,98
21,46,25,35
22,25,25,73
23,54,26,5
24,28,26,73
25,45,27,28
26,23,28,82
27,40,28,36
28,35,28,61
29,60,29,4
30,21,30,87
31,62,30,17
32,23,30,73
33,18,31,92
34,49,33,14
35,21,33,81
36,42,34,17
37,30,34,73
38,36,37,26
39,20,37,75
40,65,38,35
41,24,38,92
42,48,39,36
43,31,39,61
44,49,40,29
45,24,40,98
46,50,41,15
47,27,42,65
48,29,43,88
49,31,43,19
50,49,44,75
Exemple
df = pd.read_csv('customer_data.csv')
print("Dimensions des données (lignes, colonnes) :", df.shape)
print("\n"Les 5 premières lignes des données :")
print(df.head())
print("\n"Informations de base sur les données :")
print(df.info())
print("\n"Statistiques descriptives :")
print(df.describe())
Sortie :
数据形状(行数,列数): (50, 4)

数据前5行:
   CustomerID  Age  Annual_Income_(k$)  Spending_Score
0           1   19                  15              39
1           2   21                  15              81
2           3   20                  16               6
3           4   23                  16              77
4           5   31                  17              40

数据基本信息:
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 50 entries, 0 to 49
Data columns (total 4 columns):
 #   Column              Non-Null Count  Dtype
---  ------              --------------  -----
 0   CustomerID          50 non-null     int64
 1   Age                 50 non-null     int64
 2   Annual_Income_(k$)  50 non-null     int64
 3   Spending_Score      50 non-null     int64
dtypes: int64(4)
memory usage: 1.7 KB
None

描述性统计:
       CustomerID        Age  Annual_Income_(k$)  Spending_Score
count    50.00000  50.000000           50.000000       50.000000
mean     25.50000  35.560000           28.160000       51.680000
std      14.57738  14.283085            8.739682       31.506682
min       1.00000  18.000000           15.000000        3.000000
25%      13.25000  23.000000           21.000000       20.750000
50%      25.50000  31.000000           27.500000       61.000000
75%      37.75000  47.500000           36.250000       77.000000
max      50.00000  67.000000           44.000000       99.000000
Étape 2 : Exploration et prétraitement des données
Avant d'appliquer l'algorithme, nous devons d'abord comprendre les données et effectuer correctement le travail de « nettoyage ».
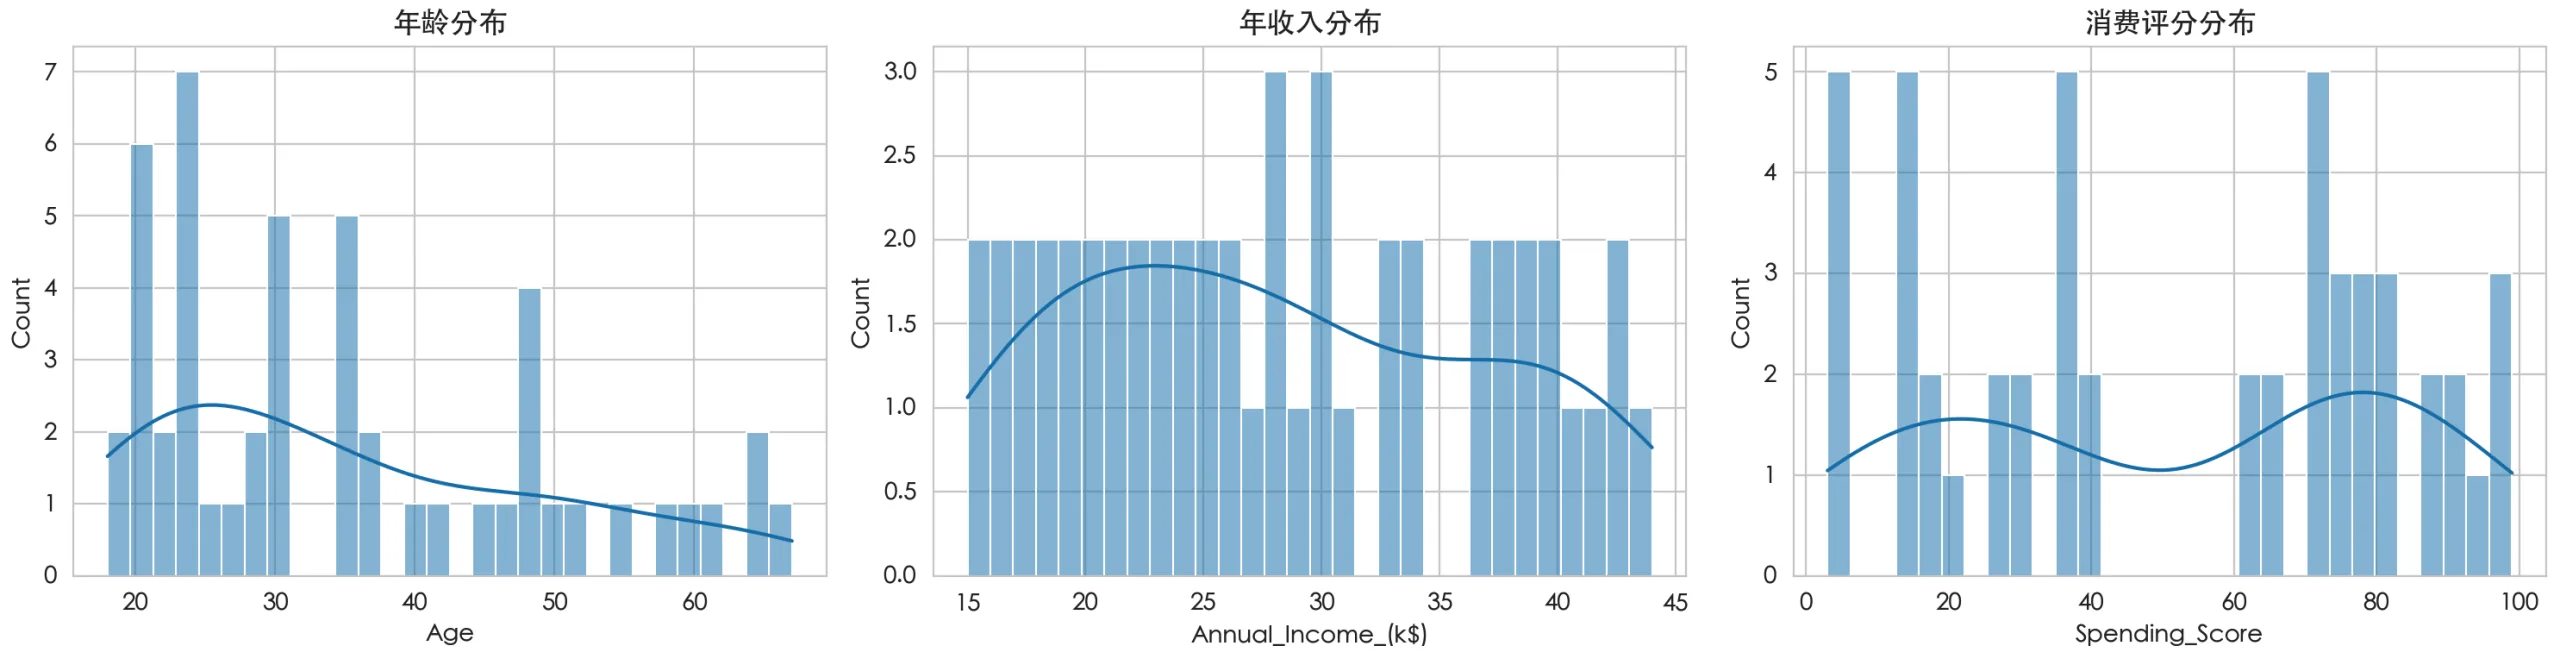
1. Analyse exploratoire des donnéesDécouvrez d'abord les motifs grâce à la visualisation et aux statistiques.
Exemple
fig, axes = plt.subplots(1, 3, figsize=(15, 4))
sns.histplot(df['Age'], bins=30, kde=True, ax=axes[0])
axes[0].set_title('Répartition par âge')
sns.histplot(df['Annual_Income_(k$)'], bins=30, kde=True, ax=axes[1])
axes[1].set_title('Répartition du revenu annuel')
sns.histplot(df['Spending_Score'], bins=30, kde=True, ax=axes[2])
axes[2].set_title('Distribution du score de dépenses')
plt.tight_layout()
plt.show()
# Afficher les relations entre les caractéristiques
sns.pairplot(df[['Age', 'Annual_Income_(k$)', 'Spending_Score']])
plt.suptitle('Matrice de diagrammes de dispersion des relations entre caractéristiques', y=1.02)
plt.show()
2. Prétraitement des donnéesLes algorithmes de clustering sont très sensibles à la dimension (unités) des caractéristiques. Les plages numériques du revenu annuel (dizaines de milliers) et de l'âge (dizaines) diffèrent grandement, ce qui affectera sérieusement le calcul des distances et amènera la caractéristique de revenu à dominer les résultats du clustering. Par conséquent, nous devons effectuerstandardisation des caractéristiques, qui met à l'échelle chaque caractéristique vers une distribution normale standard de moyenne 0 et de variance 1.
Exemple
features = ['Age', 'Annual_Income_(k$)', 'Spending_Score']
X = df[features].copy()
# Standardisation des caractéristiques
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X) # fit calcule la moyenne et la variance, transform applique la transformation
X_scaled_df = pd.DataFrame(X_scaled, columns=features)
print("5 premières lignes des données standardisées :")
print(X_scaled_df.head())
Étape 3 : Détermination du nombre optimal de clusters (valeur de K)
K-Means nous oblige à préciser la valeur de K à l'avance. Comment choisir un K raisonnable ? Nous utilisons deux méthodes classiques :
1. Méthode du coudeTracez la somme des carrés intra-cluster (inertie) correspondant à différentes valeurs de K. L'inertie diminue à mesure que K augmente ; nous recherchons le point d'inflexion de la courbe (comme un coude), après quoi le bénéfice (diminution de l'inertie) d'une augmentation supplémentaire de K devient plus faible.
Exemple
K_range = range(1, 11) # Tester K de 1 à 10
for k in K_range:
kmeans = KMeans(n_clusters=k, random_state=42, n_init='auto') # n_init='auto' est une utilisation dans les versions plus récentes
kmeans.fit(X_scaled)
inertia.append(kmeans.inertia_) # Obtenir l'inertie pour cette valeur de K
# Tracer le graphique de la méthode du coude
plt.figure(figsize=(8,5))
plt.plot(K_range, inertia, 'bo-')
plt.xlabel('Nombre de clusters (K)')
plt.ylabel('Somme des carrés intra-cluster (inertie)')
plt.title('Méthode du coude : choisir la meilleure valeur de K')
plt.xticks(K_range)
plt.show()
2. Méthode du coefficient de silhouetteLe coefficient de silhouette mesure la similarité d'un point de données avec son propre cluster (cohésion) et sa séparation par rapport aux autres clusters. Sa valeur est comprise entre -1 et 1,plus la valeur est élevée, mieux c'est, ce qui indique de meilleures performances de clustering.
Exemple
K_range = range(2, 11) # Le coefficient de silhouette nécessite au moins 2 clusters
for k in K_range:
kmeans = KMeans(n_clusters=k, random_state=42, n_init='auto')
cluster_labels = kmeans.fit_predict(X_scaled)
score = silhouette_score(X_scaled, cluster_labels)
silhouette_scores.append(score)
# Tracer le graphique du coefficient de silhouette
plt.figure(figsize=(8,5))
plt.plot(K_range, silhouette_scores, 'go-')
plt.xlabel('Nombre de clusters (K)')
plt.ylabel('Coefficient de silhouette')
plt.title('Méthode du coefficient de silhouette : choisir la meilleure valeur de K')
plt.xticks(K_range)
plt.show()
En combinant le graphique de la méthode du coude (point d'inflexion) et le graphique du coefficient de silhouette (pic), nous supposons et déterminons queK=5est un bon choix.
Étape 4 : Application de K-Means pour le clustering
Entraînez le modèle en utilisant la valeur de K sélectionnée et attribuez des étiquettes de cluster à chaque client.
Exemple
final_k = 5
kmeans_final = KMeans(n_clusters=final_k, random_state=42, n_init='auto')
df['Cluster'] = kmeans_final.fit_predict(X_scaled) # Ajouter les étiquettes de cluster au dataframe d'origine
# Afficher le nombre de clients dans chaque cluster
cluster_counts = df['Cluster'].value_counts().sort_index()
print("Distribution du nombre de clients par cluster :")
print(cluster_counts)
# Afficher les moyennes des caractéristiques par cluster (échelle d'origine)
cluster_profile = df.groupby('Cluster')[features].mean().round(2)
print("\nValeurs moyennes des caractéristiques par cluster :)
print(cluster_profile)
Étape 5 : Analyse et visualisation des résultats
Transformer les étiquettes de cluster abstraites en informations intuitives.
1. Visualiser les résultats du clusteringComme nous avons trois caractéristiques, nous pouvons sélectionner les deux caractéristiques les plus importantes (par exemple, le revenu et le score de dépenses) pour les visualiser sur un plan bidimensionnel.
Exemple
plt.figure(figsize=(10, 6))
scatter = plt.scatter(df['Annual_Income_(k$)'], df['Spending_Score'],
c=df['Cluster'], cmap='viridis', s=50, alpha=0.7)
plt.colorbar(scatter, label='Cluster label')
plt.xlabel('Annual Income (k$)')
plt.ylabel('Spending Score')
plt.title('Customer segmentation results (based on annual income and spending score)')
plt.show()
2. Profiler les segments de clientsSeloncluster_profilele tableau, nous pouvons attribuer une signification métier à chaque cluster :
| Libellé du cluster | Âge | Revenu annuel | Score de dépenses | Profil client possible |
|---|---|---|---|---|
| 0 | Moyenne | Élevée | Faible | Type prudent à haut revenu: Revenu élevé mais dépenses prudentes ; peut être des épargnants ou des personnes à valeur nette élevée sensibles aux prix. |
| 1 | Moyenne | Faible | Faible | Type à faible revenu et à faible dépense: Le revenu et le pouvoir d'achat sont tous deux limités ; ils ont besoin de produits au bon rapport qualité-prix. |
| 2 | Moyenne | Faible | Élevée | Type en quête de valeur: Le revenu n'est pas élevé mais ils aiment dépenser ; ils accordent de l'importance aux tendances et aux expériences, et sont des cibles pour les activités promotionnelles. |
| 3 | Moyenne | Élevée | Élevée | Type VIP idéal: Revenu élevé et dépenses élevées ; ils constituent la principale source de profit de l'entreprise et doivent bénéficier de services haut de gamme et d'avantages exclusifs. |
| 4 | Jeunes | Moyenne | Moyenne | Type jeunes à potentiel: Des clients jeunes dont le revenu et les dépenses sont en phase de croissance ; ils sont essentiels pour cultiver la fidélité à la marque. |
Étape 6 : Évaluation du modèle et recommandations d'application
Évaluation: En plus du score de silhouette, vous pouvez vérifier si la distribution des échantillons au sein des clusters est équilibrée, et combiner la logique métier pour juger si la segmentation est raisonnable.
Recommandations d'application:
- Marketing de précision: Promouvoir les nouveaux produits haut de gamme et les événements exclusifs auprès du « type VIP idéal » (Cluster 3) ; envoyer des coupons de réduction et des informations sur les achats groupés au « type en quête de valeur » (Cluster 2).
- Développement produit: Concevoir des produits à la mode avec de forts attributs sociaux pour le « type jeune potentiel » (cluster 4).
- Service client: Fournir des données produit détaillées et des garanties de sécurité au « type prudent à haut revenu » (cluster 0) afin d'apaiser leurs inquiétudes.
- Allocation des ressources: Allouer davantage de ressources de service client et de marketing aux segments de clients à forte valeur.
Résumé et exploration approfondie
Grâce à cette étude de cas pratique, vous avez pleinement expérimenté le processus de segmentation client à l'aide de l'algorithme K-Means :Préparation des données -> Analyse exploratoire -> Prétraitement -> Détermination de la valeur K -> Entraînement du modèle -> Analyse des résultats。
Récapitulatif des points clés:
- Le clustering est une méthode d'apprentissage non supervisé utilisée pour découvrir des regroupements inhérents aux données.
- La standardisation des caractéristiquesest une étape clé avant d'utiliser des algorithmes de clustering basés sur la distance.
- La méthode du coudeetle score de silhouettesont des outils pratiques pour déterminer le nombre optimal de clusters.
- L'interprétation des résultats de clustering doitêtre combinée aux connaissances métierpour produire une réelle valeur.