Régularisation
Imaginez que nous apprenons à faire du vélo. Au début, nous pouvons être très nerveux, serrant fermement le guidon, le corps raide, essayant de nous souvenir de chaque détail du mouvement. Cet état de concentration excessive sur les détails et de tentative de contrôler parfaitement chaque minuscule mouvement est appelé en apprentissage automatiquesurapprentissage。
Notre modèle (comme vous en tant que débutant) est trop complexe, mémorisant parfaitement chaque échantillon des données d'entraînement, y compris le bruit et les fluctuations aléatoires, ce qui l'amène à obtenir de mauvaises performances face à de nouvelles données jamais vues (comme rouler réellement sur la route), avec une capacité de généralisation insuffisante.
La régularisationest la technologie centrale conçue pour résoudre ce problème. Son idée centrale est :Calmer l'enthousiasme d'apprentissage du modèle, l'empêcher de s'enliser dans les détails, et ainsi améliorer son adaptabilité à de nouveaux environnements.En termes simples, la régularisation ajoute un terme de pénalité supplémentaire à la fonction objectif (fonction de perte) pendant l'entraînement du modèle, limitant ainsi la complexité du modèle et l'empêchant de dépendre excessivement de schémas spécifiques des données d'entraînement.
Cet article vous fera découvrir en profondeur les principes de la régularisation, les méthodes courantes et leurs applications dans la pratique de l'ingénierie.
Concepts de base : le compromis biais-variance
Avant de plonger dans la régularisation, nous devons comprendre les deux sources principales d'erreur des modèles d'apprentissage automatique :le biaisetla variance. Cela nous aide à comprendre ce que la régularisation ajuste réellement.
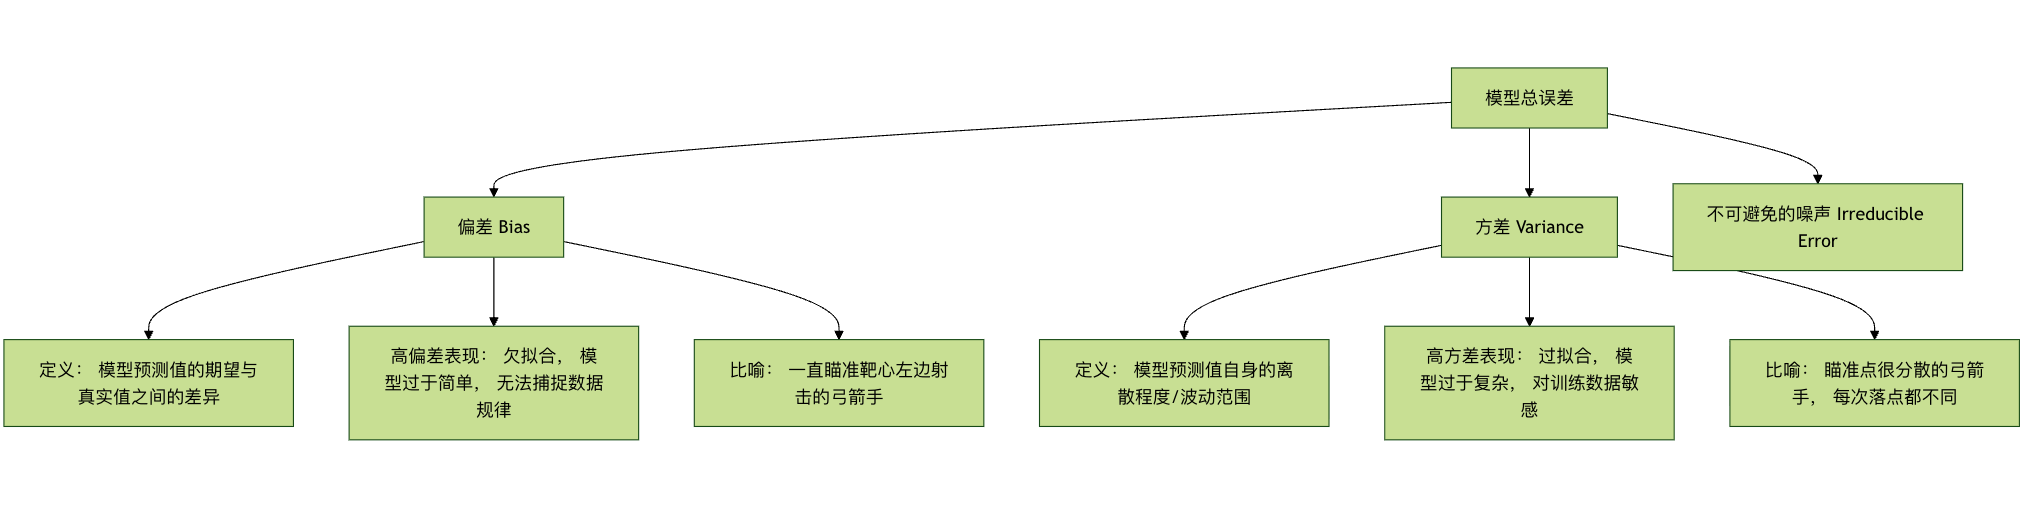
- Le biaismesure l'erreursystématique propre au modèle.Un biais élevé signifie que le modèle est trop simple, échouant même à apprendre les motifs de base des données d'entraînement (sous-apprentissage).
- La variancemesure la sensibilité du modèle auxfluctuations aléatoires des données d'entraînement.Une variance élevée signifie que le modèle est trop complexe, traitant le bruit des données d'entraînement comme des motifs à apprendre (surapprentissage).
Notre objectif est de trouver lecompromis biais-varianceoptimal afin de minimiser l'erreur totale. La régularisation est une méthode qui, enajoutant un peu de biais (rendant le modèle légèrement plus simple), réduit considérablement la variance, et améliore ainsi efficacement la performance de généralisation globale du modèle.
Régularisation L1 et L2
La méthode de régularisation la plus classique consiste à ajouter directement un terme de pénalité basé sur les paramètres de poids du modèle à la fonction de perte. Selon le mode de calcul du terme de pénalité, elle se divise principalement en régularisation L1 et L2.
Modifications de la fonction de perte
Fonction de perte sans régularisation (en utilisant l'erreur quadratique moyenne, MSE, comme exemple) :Loss = (1/n) * Σ(真实值 - 预测值)²
Fonction de perte après ajout du terme de régularisation :Loss_正则化 = Loss + λ * Penalty(权重)
où :
λ(lambda) est lecoefficient d'intensité de régularisation,un hyperparamètre supérieur à 0. Il contrôle la force de la pénalité.λPlus λ est grand, plus la pénalité sur la complexité du modèle est lourde, et plus le modèle devient simple.Penalty(权重)est le terme de pénalité. L1 et L2 ont des définitions différentes.
Régularisation L1 (régression Lasso)
- Terme de pénalité: La somme des valeurs absolues de tous les paramètres de poids du modèle.
- Formule:
Penalty = Σ|w_i|, oùw_iest le i-ème poids. - Fonction de perte:
Loss_L1 = Loss + λ * Σ|w_i|
Caractéristiques et effets principaux:
- Sélection de caractéristiques: la régularisation L1 a tendance à produire unematrice de poids creuse,, c'est-à-dire qu'elle va directement compresser les poids de nombreuses caractéristiques non importantes à00. Cela équivaut à effectuer automatiquement une sélection de caractéristiques, où le modèle ne conserve que les caractéristiques les plus importantes.
- Interprétation géométrique: Géométriquement, sa région de contrainte est un 'diamant' (un losange en deux dimensions). Le point de solution optimale est plus susceptible de toucher un 'coin' de ce diamant, et les points au coin signifient que certaines coordonnées sont 0.
Exemple de code:
Exemple
from sklearn.datasets import make_regression
from sklearn.model_selection import train_test_split
# Générer des données simulées
X, y = make_regression(n_samples=100, n_features=10, noise=0.1, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Créer un modèle de régularisation L1 (Lasso), définir la force de régularisation alpha (c'est-à-dire λ)
lasso_model = Lasso(alpha=0.1) # Plus alpha est grand, plus la pénalité est forte, et plus de poids deviennent 0
lasso_model.fit(X_train, y_train)
# Afficher les coefficients du modèle (poids) pour observer la parcimonie
print("Coefficients du modèle Lasso :")
for i, coef in enumerate(lasso_model.coef_):
print(f" Caractéristique {i} : {coef:.4f}")
# Compter le nombre de poids non nuls
non_zero_count = sum(lasso_model.coef_ != 0)
print(f"\nNombre de caractéristiques avec des poids non nuls : {non_zero_count} / {X.shape)
Sortie :
Lasso 模型系数:
  特征 0: 16.6855
  特征 1: 54.0447
  特征 2: 5.0302
  特征 3: 63.5492
  特征 4: 93.4587
  特征 5: 70.5421
  特征 6: 86.9569
  特征 7: 10.2711
  特征 8: 3.0697
  特征 9: 70.7835

非零权重的特征数量: 10 / 10
Régularisation L2 (régression Ridge)
- Terme de pénalité: La somme des carrés de tous les paramètres de poids dans le modèle.
- Formule:
Penalty = Σ(w_i)² - Fonction de perte:
Loss_L2 = Loss + λ * Σ(w_i)²
Caractéristiques et effets principaux:
- Décroissance des poids: La régularisation L2 tend à faire en sorte que tous les paramètres de poidss'approchent de 0, mais généralement ils ne sont pas égaux à 0.Elle réduit uniformément tous les poids, empêchant un poids individuel de devenir trop grand.
- Amélioration des problèmes mal conditionnés: Pour les données présentant de la multicolinéarité (forte corrélation) entre les caractéristiques, la régression linéaire ordinaire peut être instable. La régularisation L2 peut efficacement améliorer ce problème et rendre la solution plus stable.
- Interprétation géométrique: Géométriquement, sa région de contrainte est un « cercle » (un cercle en deux dimensions). Le point de solution optimale est plus susceptible de toucher le « bord » de ce cercle plutôt qu'un coin pointu.
Exemple de code:
Exemple
# Créer un modèle de régularisation L2 (Ridge)
ridge_model = Ridge(alpha=1.0) # alpha est λ
ridge_model.fit(X_train, y_train)
# Voir les coefficients du modèle pour observer la décroissance des poids
print("Coefficients du modèle Ridge :")
for i, coef in enumerate(ridge_model.coef_):
print(f" Caractéristique {i} : {coef:.4f}")
# Comparer les différences de coefficients entre Lasso et Ridge
print("\nComparaison des coefficients (Lasso vs Ridge) :")
print("Caractéristique | Coefficient Lasso | Coefficient Ridge")
print("-" * 35)
for i in range(len(lasso_model.coef_)):
print(f"{i:4d} | {lasso_model.coef_[i]:11.4f} | {ridge_model.coef_[i]:11.4f}")
Résumé de comparaison L1 vs L2
| Propriété | Régularisation L1 (Lasso) | Régularisation L2 (Ridge) |
|---|---|---|
| Terme de pénalité | `Σ | w_i |
| Caractéristiques de la solution | Solution parcimonieuse, de nombreux poids sont 0 | Solution dense, les poids sont proches de 0 mais non nuls |
| Fonction principale | Sélection de caractéristiques | Décroissance des poids, Solution stable |
| Forme géométrique | Losange / polyèdre | Cercle / sphère |
| Calcul | Optimisation plus complexe (non différentiable partout) | Optimisation simple (différentiable partout) |
| Scénarios applicables | De nombreuses caractéristiques, et seules quelques-unes sont considérées comme pertinentes | Toutes les caractéristiques peuvent contribuer, ou il existe une multicolinéarité |
Elastic Net
Elastic Net est un compromis entre la régularisation L1 et L2, contenant les termes de pénalité des deux.Loss_ElasticNet = Loss + λ1 * Σ|w_i| + λ2 * Σ(w_i)²
Il combine la capacité de sélection de caractéristiques de L1 avec la stabilité de L2, ce qui le rend adapté aux cas où le nombre de caractéristiques est très élevé et où il existe des corrélations entre les caractéristiques.
Exemple
elastic_model = ElasticNet(alpha=0.1, l1_ratio=0.5) # l1_ratio contrôle le taux de mélange de L1 et L2
elastic_model.fit(X_train, y_train)
Autres techniques de régularisation
En plus de modifier directement la fonction de perte, il existe également des méthodes qui réalisent une régularisation en modifiant le processus d'entraînement ou la structure du modèle.
Dropout (pour les réseaux de neurones)
Dropout est une technique de régularisation extrêmement efficace dans les réseaux de neurones. Pendant leprocessus d'entraînement,il amène aléatoirement une partie des neurones du réseau à se 'désactiver' temporairement (en mettant leur sortie à 0).
Comment ça marche:
- Dans chaque lot d'entraînement, avec une probabilité
p(par ex., 0.5), désactive aléatoirement une partie des neurones. - La propagation avant et la rétropropagation sont effectuées uniquement dans les neurones restants.
- Lors du test ou de la prédiction, tous les neurones sont utilisés, mais la sortie d’un neurone est multipliée par
(1-p)pour maintenir la valeur attendue cohérente.
Idée clé: Pour empêcher une co-adaptation complexe entre les neurones, en forçant le réseau à apprendre des représentations de caractéristiques plusrobustesetdispersées. C’est comme une équipe : elle ne peut pas toujours compter sur quelques membres essentiels ; chacun doit pouvoir travailler de manière indépendante, afin que même si quelqu’un est absent, l’équipe puisse encore fonctionner normalement.
Exemple de code (avec TensorFlow/Keras):
Exemple
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Dropout
model = Sequential([
Dense(128, activation='relu', input_shape=(input_dim,)),
Dropout(0.5), # Ajouter une couche Dropout après la couche précédente, taux de dropout de 50%
Dense(64, activation='relu'),
Dropout(0.3), # taux de dropout 30%
Dense(1, activation='sigmoid') # couche de sortie
])
model.compile(optimizer='adam', loss='binary_crossentropy', metrics=['accuracy'])
Arrêt précoce
L'arrêt anticipé est une stratégie de régularisation simple et efficace. Il ne modifie pas la fonction de perte, maissurveille plutôt les performances du modèle sur l'ensemble de validation.。
Étapes:
- Divisez les données en ensembles d'entraînement et de validation.
- Entraînez le modèle sur l'ensemble d'entraînement, et évaluez périodiquement les performances sur l'ensemble de validation (par exemple, après chaque époque d'entraînement).
- Une fois qu'il est constaté que les performances (par exemple, la perte) sur l'ensemble de validation ne se sont pas améliorées pendant plusieurs époques consécutivesou ont même commencé à se dégrader,arrêtez immédiatement l'entraînement.
Idée clé :Arrêtez l'entraînement au moment juste avant que le modèle ne commence à surapprendre les données d'entraînement (c'est-à-dire lorsque l'erreur de validation commence à augmenter), obtenant ainsi les poids du modèle ayant la meilleure capacité de généralisation.
Exemple
# Définir la fonction de rappel d'arrêt anticipé
# monitor : la métrique à surveiller, par exemple, 'val_loss'
# patience : nombre d'époques à tolérer ; arrêtez si la validation ne s'améliore pas dans ce nombre d'époques.
# restore_best_weights: indique s'il faut restaurer les poids de l'époque avec la meilleure métrique surveillée
early_stopping = EarlyStopping(
monitor='val_loss',
patience=10,
restore_best_weights=True
)
# Utilisation dans model.fit
history = model.fit(
X_train, y_train,
validation_data=(X_val, y_val),
époques=100,
callbacks=[early_stopping] # Passer la liste des callbacks
)
Exercice pratique : comparaison complète des effets de la régularisation
Utilisons un exemple complet pour comparer les effets de différentes méthodes de régularisation sur une tâche de régression.
Exemple
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression, Lasso, Ridge, ElasticNet
from sklearn.preprocessing import PolynomialFeatures
from sklearn.pipeline import make_pipeline
from sklearn.metrics import mean_squared_error
# 1. Générer des données non linéaires avec du bruit
np.random.seed(42)
X = np.linspace(-3, 3, 100).reshape(-1, 1)
y_true = 0.5 * X.ravel()**2 + X.ravel() # Véritable relation quadratique
y = y_true + np.random.randn(100) * 0.8 # Ajouter du bruit
# 2. Créer des modèles de complexité différente (en utilisant des caractéristiques polynomiales)
degree = 10 # Utiliser un polynôme de degré 10, qui est sujet au surapprentissage
models = {
'Aucune régularisation': make_pipeline(PolynomialFeatures(degree), LinearRegression()),
'L1 (Lasso)': make_pipeline(PolynomialFeatures(degree), Lasso(alpha=0.01, max_iter=10000)),
'L2 (Ridge)': make_pipeline(PolynomialFeatures(degree), Ridge(alpha=0.1)),
'ElasticNet': make_pipeline(PolynomialFeatures(degree), ElasticNet(alpha=0.01, l1_ratio=0.5))
}
# 3. Entraîner et prédire
X_plot = np.linspace(-3.5, 3.5, 200).reshape(-1, 1)
plt.figure(figsize=(12, 8))
plt.scatter(X, y, s=20, alpha=0.6, label='Données d'entraînement (avec bruit)')
plt.plot(X, y_true, 'k-', linewidth=3, label='Fonction réelle')
for name, model in models.items():
model.fit(X, y)
y_plot = model.predict(X_plot)
mse = mean_squared_error(y, model.predict(X))
plt.plot(X_plot, y_plot, '--', linewidth=2, label=f'{name} (MSE: {mse:.3f})')
plt.xlabel('X')
plt.ylabel('y')
plt.title('Comparaison de différentes méthodes de régularisation pour supprimer le surapprentissage (polynôme de degré 10)')
plt.legend(loc='best')
plt.grid(True, alpha=0.3)
plt.show()
Tâches pratiques:
- Exécutez le code ci-dessus et observez comment le modèle non régularisé fluctue fortement pour s'ajuster au bruit (surapprentissage), tandis que les courbes du modèle régularisé sont plus lisses et plus proches de la fonction réelle.
- Essayez d'ajuster
degree(le degré du polynôme) et, pour chaque modèle,alphales paramètres (de force de régularisation), et observez leur impact sur les résultats d'ajustement du modèle. - (Avancé) Divisez les données en ensembles d'entraînement et de test, calculez le MSE de chaque modèle sur l'ensemble de test, et vérifiez l'amélioration de la généralisation apportée par la régularisation.
Résumé et recommandations d'ingénierie
La régularisation est un outil essentiel dans la boîte à outils d'un ingénieur en apprentissage automatique. Pour l'appliquer efficacement, gardez les points suivants à l'esprit :
- Comprenez la nature du problème :Tout d'abord, utilisez les courbes d'apprentissage, les performances de l'ensemble de validation, etc., pour déterminer si le modèle est confronté à un problème de surapprentissage (forte variance).
- Commencez simple :Habituellement, vous pouvez d'abord essayerla régularisation L2,car elle est stable et facile à régler. Si la dimensionnalité des caractéristiques est extrêmement élevée et qu'une sélection de caractéristiques est nécessaire, envisagez alorsL1ouelastic net.。
- Le réglage est essentiel :L'intensité de régularisation
λ(oualpha) est un hyperparamètre crucial. Il doit être sélectionné avec soin parvalidation croisée. - Utilisez en combinaison :En pratique, les techniques de régularisation sont souvent utilisées en combinaison. Par exemple, lors de l'entraînement de réseaux de neurones profonds,Dropout + L2 weight decay + early stoppingest une combinaison extrêmement courante.
- Adaptation au domaine :Pour les tâches de vision par ordinateur, Dropout et Batch Normalization (qui a également un certain effet de régularisation) sont très efficaces. Pour les modèles séquentiels (tels que RNN, Transformer), Dropout et weight decay sont couramment utilisés.
L'objectif ultime de la régularisation est de guider le modèle d'une « mémorisation par cœur » des données d'entraînement vers une « compréhension profonde » des motifs universels sous-jacents aux données, afin de faire des prédictions plus fiables dans le monde réel. Maîtrisez-la, et vous détenez la clé pour améliorer la généralisation du modèle.
Autres extensions