Apprentissage par renforcement : Q-learning et SARSA
Dans le domaine de l'intelligence artificielle, l'apprentissage par renforcement est une méthode qui permet à un agent d'apprendre à atteindre des objectifs en interagissant avec l'environnement.
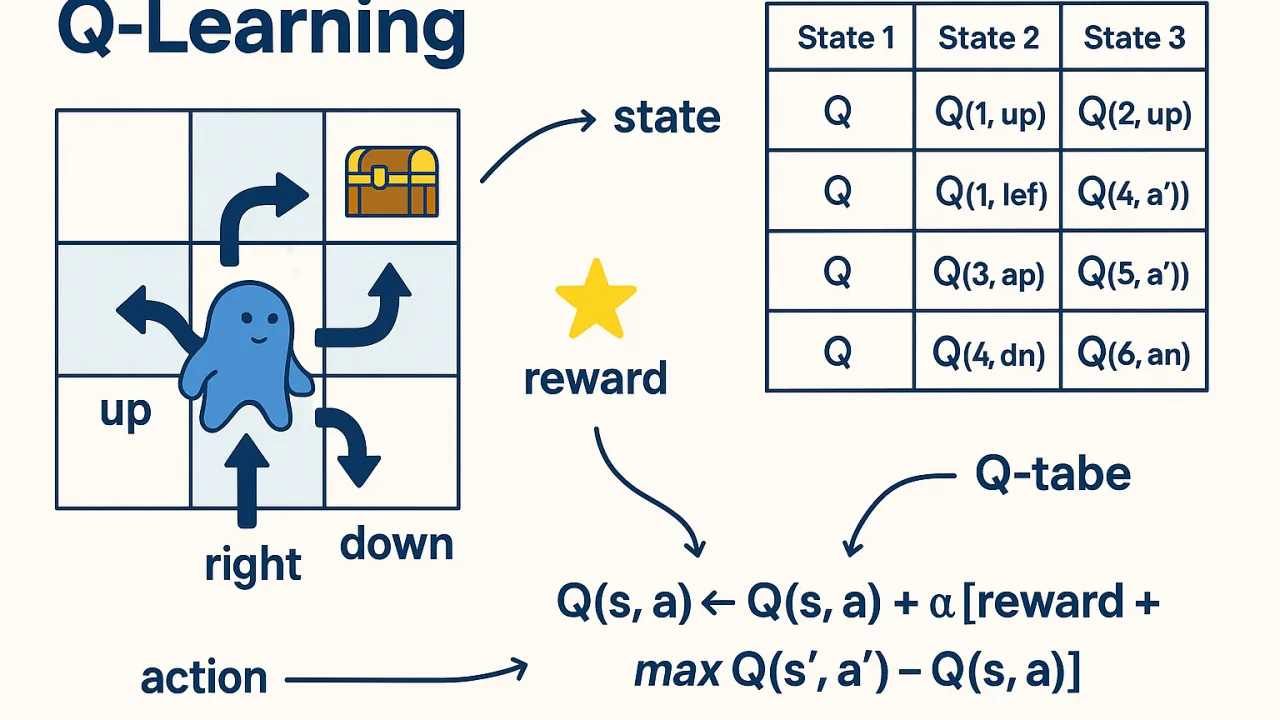
Imaginez que vous apprenez une nouvelle commande à un chiot : lorsqu'il effectue une action (comme s'asseoir), vous lui donnez une récompense (une friandise), et il apprend progressivement à répondre correctement lorsqu'il entend la commande. Q-learning et SARSA sont deux algorithmes classiques et cruciaux de l'apprentissage par renforcement ; ils sont les outils essentiels pour que l'agent apprennequelle action est la meilleure dans quel étatoutils essentiels.
Bases de l'apprentissage par renforcement et des processus de décision markoviens
Avant de plonger dans Q-learning et SARSA, nous devons comprendre le cadre théorique commun qu'ils partagent.
Concepts fondamentaux
Les problèmes d'apprentissage par renforcement sont généralement modélisés commeun processus de décision markovien. Il contient les éléments clés suivants :
- Agent: L'entité qui prend des décisions et apprend.
- Environnement: Le monde extérieur avec lequel l'agent interagit.
- État: Une description de l'environnement à un moment donné.
- Action: Une opération que l'agent peut effectuer dans un état donné.
- Récompense: Signal de gain immédiat renvoyé par l'environnement après que l'agent effectue une action.
- Politique: Règle selon laquelle l'agent sélectionne des actions dans un état donné ; c'est la cible d'apprentissage.
Objectifs et fonctions de valeur
L'objectif ultime de l'agent est de maximiser la récompense cumulative à long terme, et pas seulement la récompense immédiate. À cette fin, nous introduisonsles fonctions de valeur.。
- Fonction de valeur d'état V(s): Représente, à partir de l'état
s, la récompense cumulative attendue pouvant être obtenue en suivant une politique spécifique. - Fonction de valeur d'action Q(s, a): Représente, dans l'état
sen effectuant l'actiona, puis en suivant une politique spécifique, la récompense cumulative attendue qui peut être obtenue.Le cœur de Q-learning et SARSA est d'apprendre cette fonction Q.
Pour équilibrer les récompenses immédiates et futures, nous utilisonsle facteur d'actualisation γ(généralement dans l'intervalle [0, 1]). La récompense à l'étape future k est multipliée par γ^k, ce qui signifie que l'agent accorde plus d'importance aux récompenses à court terme.
Q-learning : Apprentissage par différence temporelle hors politique
Q-learning est un algorithmehors politique, proposé par Watkins en 1989. Son idée centrale est que l'agent trouve indirectement la politique optimale en apprenant une table de valeurs Q optimale.
Cœur de l'algorithme : formule de mise à jour de la valeur Q
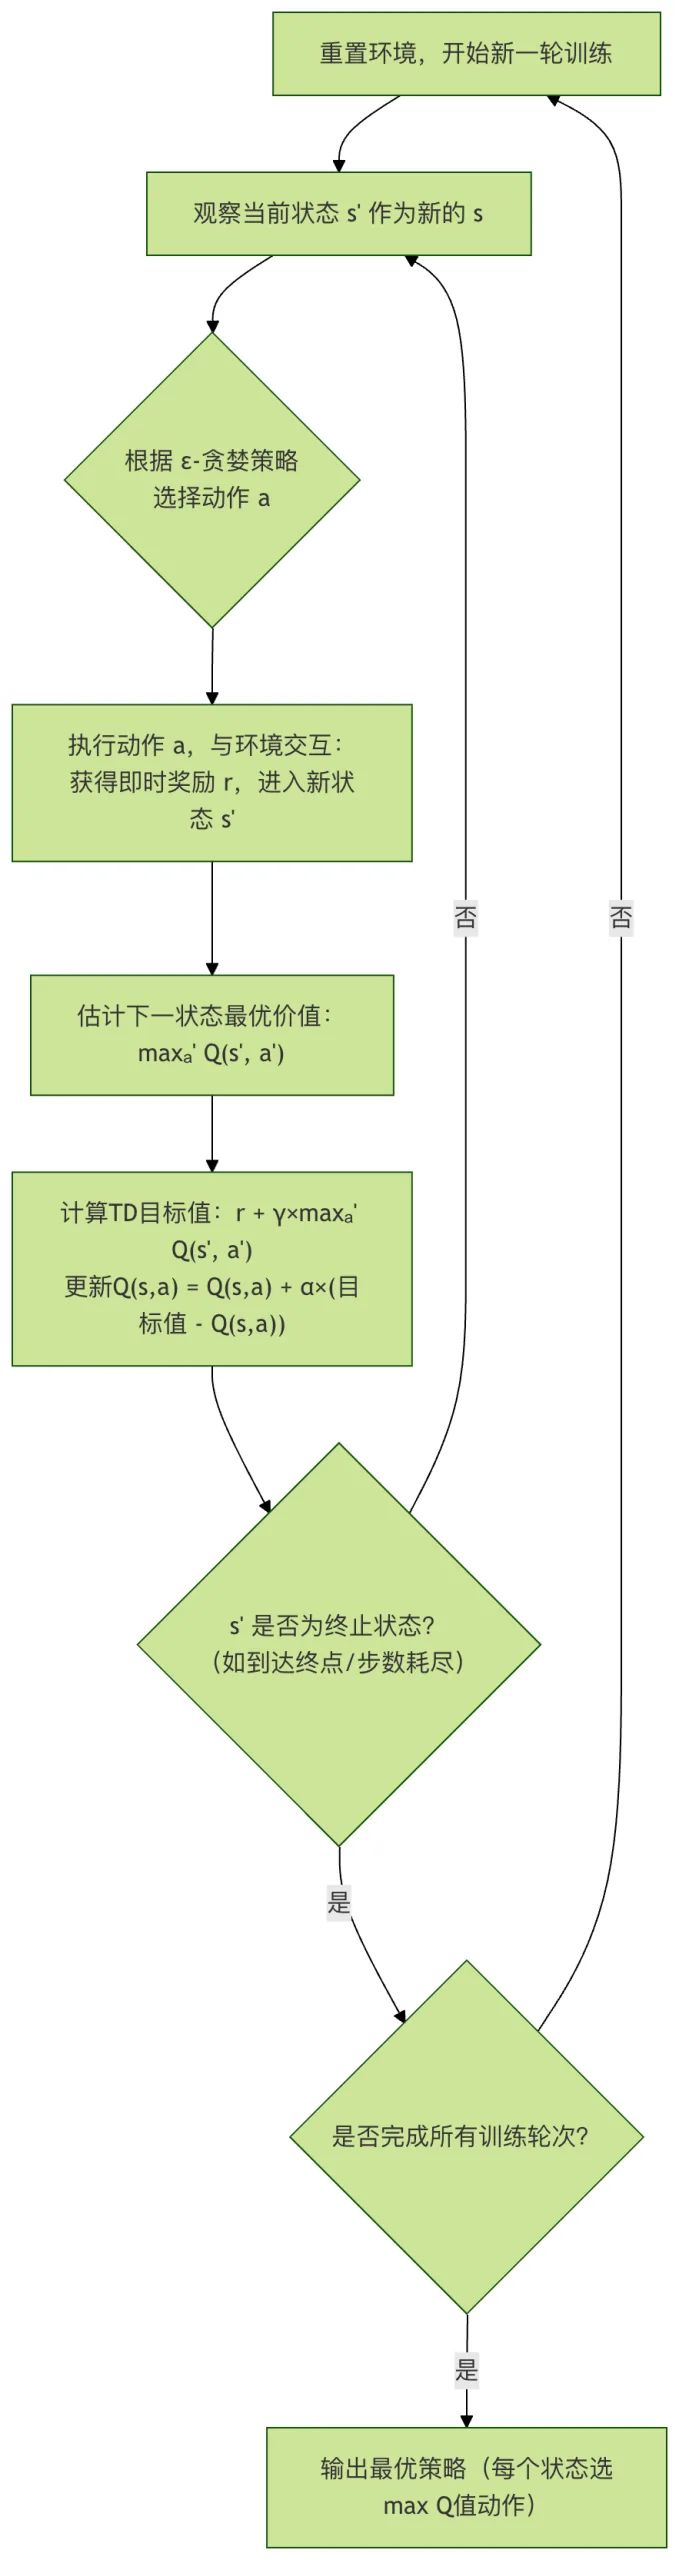
Le processus d'apprentissage du Q-learning est guidé par la formule suivante :Q(s_t, a_t) ← Q(s_t, a_t) + α * [ r_{t+1} + γ * max_{a} Q(s_{t+1}, a) - Q(s_t, a_t) ]
Décomposons cette formule :
Q(s_t, a_t)Q(s, a) : à l'instant tt, dans l'état ss_ten effectuant l'action aa_t, l'estimation actuelle.α: Le taux d'apprentissage αcontrôle la mesure dans laquelle les nouvelles informations remplacent les anciennes (0 < α ≤ 1).r_{t+1}r : après avoir exécuté une actiona_t, la récompense immédiate obtenue.γ: Le facteur d'actualisation γmesure l'importance des récompenses futures.max_{a} Q(s_{t+1}, a)max Q(s', a') : dans l'état suivants_{t+1}, la plus grande valeur Q parmi toutes les actions possibles. Cela représente le meilleur retour futur possible estimé à partir de la table Q actuelle.[ r_{t+1} + γ * max_{a} Q(s_{t+1}, a) - Q(s_t, a_t) ]Erreur TD : appeléeerreur de différence temporelle. C’est la différence entre la « valeur cible » (récompense immédiate plus la meilleure estimation future) et l’« estimation actuelle ». L’algorithme met à jour Q en réduisant cette erreur.
La signification de l’approche hors-politique
Q-learning est appeléhors-politique, car lorsqu’il met à jour les valeurs Q, l’action utilisée pour évaluer la valeur future (max_{a} Q(s_{t+1}, a)) et l’action que l’agent exécute réellement pour l’explorationsont distinctes.。
- Politique de comportement: la politique utilisée pour sélectionner les actions réellement effectuées (par exemple, ε-greedy, qui explore aléatoirement avec une certaine probabilité).
- Politique cible: la politique utilisée pour mettre à jour les valeurs Q ; c’est une politique entièrement gloutonne (qui sélectionne toujours l’action ayant la plus grande valeur Q actuelle).
Cette séparation permet à Q-learning d’apprendre audacieusement en utilisant son estimation du chemin optimal, même lorsqu’il effectue actuellement une exploration aléatoire.
Procédure de l’algorithme
SARSA : Apprentissage par différence temporelle sur-politique
Le nom SARSA provient de la séquence état-action impliquée dans son processus de mise à jour :(S_t, A_t, R_{t+1}, S_{t+1}, A_{t+1}). Il s’agit d’un algorithmesur-politique.
Cœur de l'algorithme : formule de mise à jour de la valeur Q
La formule de mise à jour de SARSA est très similaire à celle de Q-learning, mais il y a une différence clé :Q(s_t, a_t) ← Q(s_t, a_t) + α * [ r_{t+1} + γ * Q(s_{t+1}, a_{t+1}) - Q(s_t, a_t) ]
Remarquez la seconde partie :
- Q-learning utilise max_{a'} Q(s', a'):
γ * max_{a} Q(s_{t+1}, a) - SARSA utilise Q(s', a'):
γ * Q(s_{t+1}, a_{t+1})
Dans SARSA, l'agent dansl'état suivants_{t+1}va réellement effectuer une actiona_{t+1}dont la valeur Q est utilisée pour estimer la valeur future.
La signification de On-Policy
SARSA est appeléon-policy, car la politique qu'il utilise pour mettre à jour les valeurs Q (politique cible) et la politique qu'il utilise pour sélectionner les actions (politique de comportement)sont les mêmes, toutes deux étant généralement la politique ε-greedy.
- Il évalue et optimise la politique qu'ilexécute actuellement.
- Ce qu'il apprend est une politique qui tient compte du risque d'exploration future, elle est donc généralement plus « conservatrice ».
Comparaison de Q-learning et SARSA
Comprendre la différence entre les deux est essentiel pour les maîtriser. Le tableau ci-dessous résume clairement les différences fondamentales :
| Fonctionnalité | Q-learning | SARSA |
|---|---|---|
| Type de politique | Hors-politique | Sur-politique |
| Cible de mise à jour | Basé sur l'action optimale :r + γ * max Q(s', a') |
Basé sur l'action réelle :r + γ * Q(s', a_{t+1}) |
| Objectif d'apprentissage | Learnla politique optimale. | Learnla politique de comportement (par ex., ε-greedy). |
| Propension au risque | Plus "audacieux", suppose que des actions optimales seront prises à l'avenir | Plus "conservateur", prend en compte le risque que l'exploration future peut présenter |
| Moment de la mise à jour | Dans(s, a, r, s')peut être mis à jour immédiatement après (S, A, R, S') |
nécessite(s, a, r, s', a')le quintuplet (S, A, R, S', A') pour la mise à jour. |
| Applications typiques | Environnements discrets, recherchant la solution optimale globale | Environnements à exigences de sécurité élevées, où les états dangereux doivent être évités |
Exemple classique de Cliff Walking
Cet exemple illustre de manière vivante la différence entre les deux. Supposons un monde en grille où l'agent se déplace du départ S à l'objectif G ; en dessous se trouve une falaise. Une chute entraîne une forte récompense négative et ramène au départ.
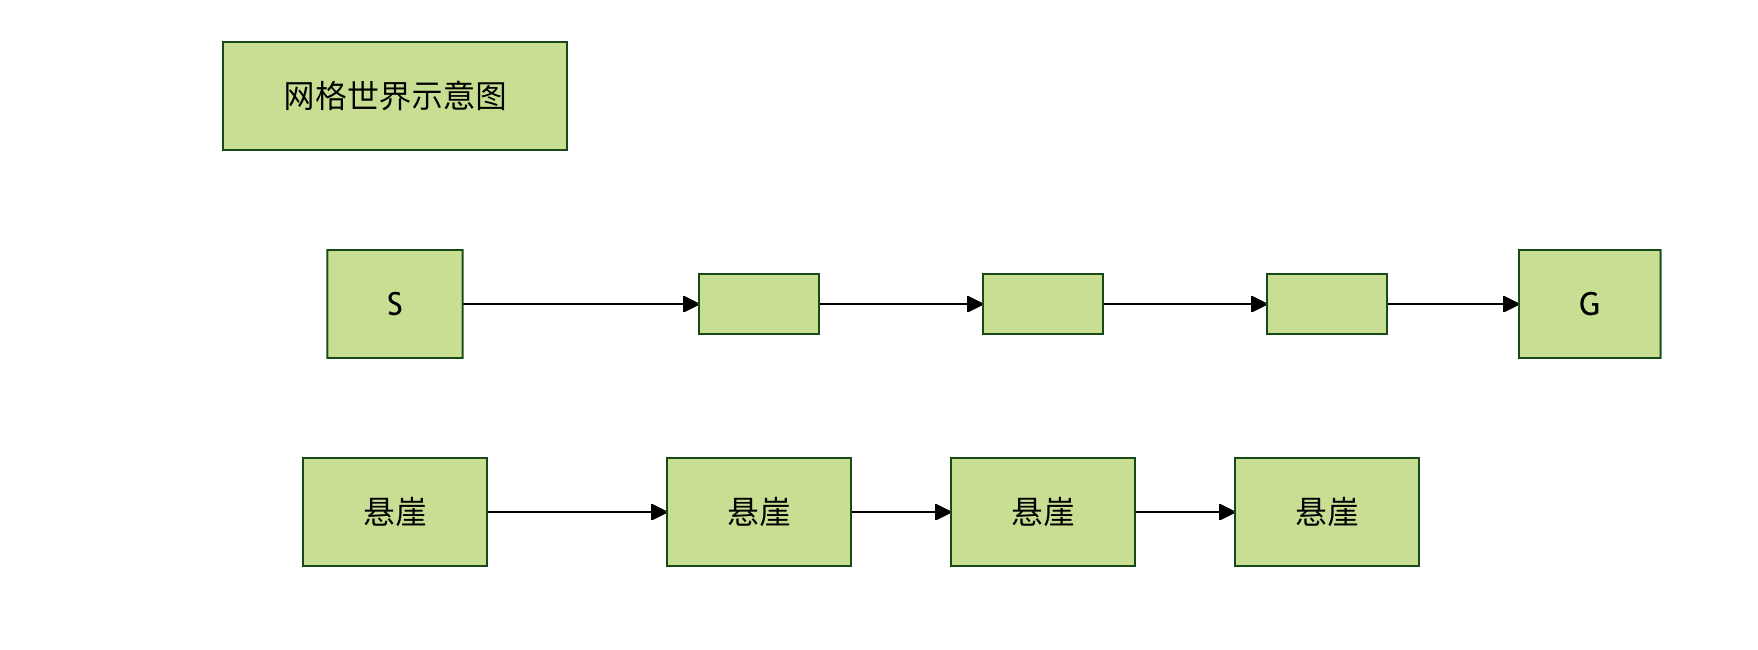
- Q-learningQ-learning : comme il suppose que l'avenir empruntera toujours le chemin optimal (le plus sûr), il apprend rapidement le chemin le plus court le long du bord de la falaise (chemin 1), parce qu'il "croit" qu'il ne tombera pas.
- SARSASARSA : comme il considère qu'il existe encore une probabilité ε d'exploration aléatoire dans le futur, il peut tomber de la falaise. Par conséquent, il apprend un chemin plus sûr plus haut (chemin 2). Bien que plus long, son retour attendu à long terme est plus élevé.
Conclusion: Dans les environnements où l’exploration et l’exploitation doivent être équilibrées et où les erreurs sont coûteuses, SARSA apprend généralement une politique plus sûre et plus robuste.
Exercice de code : Implémenter Q-learning et SARSA en Python
Nous allons utiliser un simple4x4monde en grille pour démontrer les deux algorithmes. L’objectif est que l’agent se déplace du coin supérieur gauche(0,0)vers le coin inférieur droit(3,3)。
Configuration de l'environnement
Exemple
import random
class GridWorld:
def __init__(self, size=4):
self.size = size
self.state = (0, 0) # Point de départ
self.goal = (size-1, size-1) # Point d’arrivée
self.actions = ['up', 'down', 'left', 'right']
self.action_map = {'up': (-1, 0), 'down': (1, 0), 'left': (0, -1), 'right': (0, 1)}
def reset(self):
"""Réinitialiser l’environnement au point de départ"""
self.state = (0, 0)
return self.state
def step(self, action):
"""Exécuter l'action, renvoyer (état suivant, récompense, terminé)"""
move = self.action_map[action]
next_state = (self.state[0] + move[0], self.state[1] + move[1])
# Vérification des limites : si hors limites, rester sur place
if not (0 <= next_state[0] < self.size and 0 <= next_state[1] < self.size):
next_state = self.state
self.state = next_state
# Configuration de la récompense : récompense 10 pour atteindre l'objectif, -1 pour les autres déplacements (encourager à atteindre rapidement)
if next_state == self.goal:
reward = 10
done = True
else:
reward = -1
done = False
return next_state, reward, done
def get_actions(self):
return self.actions
Implémentation de l’algorithme Q-learning
Exemple
"""
Implémenter l’algorithme Q-learning
env : objet environnement
episodes : nombre d’épisodes d’entraînement
alpha : taux d’apprentissage
gamma : facteur d’actualisation
epsilon : probabilité d’exploration dans la politique ε-greedy
"""
# Initialiser la table Q avec la forme [lignes de la grille, colonnes de la grille, nombre d'actions]
q_table = np.zeros((env.size, env.size, len(env.actions)))
for episode in range(episodes):
state = env.reset()
done = False
while not done:
# 1. Choisir une action en utilisant la politique ε-greedy
if random.uniform(0, 1) < epsilon:
action_idx = random.randint(0, len(env.actions)-1) # Exploration : choisir aléatoirement
else:
action_idx = np.argmax(q_table[state[0], state[1], :]) # Exploitation : choisir celle qui a la valeur Q maximale
action = env.actions[action_idx]
# 2. Exécuter l'action, obtenir le retour
next_state, reward, done = env.step(action)
# 3. Mise à jour centrale de Q-learning
# Valeur Q de la paire état-action actuelle
current_q = q_table[state[0], state[1], action_idx]
# Valeur Q maximale de l'état suivant (clé pour le hors-politique)
next_max_q = np.max(q_table[next_state[0], next_state[1], :])
# Calculer la valeur Q cible
target_q = reward + gamma * next_max_q
# Mettre à jour la table Q
q_table[state[0], state[1], action_idx] = current_q + alpha * (target_q - current_q)
# Transition vers l'état suivant
state = next_state
return q_table
Implémentation de l'algorithme SARSA
Exemple
"""
Implémenter l'algorithme SARSA
La signification des paramètres est identique à celle de Q-learning
"""
q_table = np.zeros((env.size, env.size, len(env.actions)))
for episode in range(episodes):
state = env.reset()
done = False
# SARSA doit d'abord choisir une action pour l'état initial
if random.uniform(0, 1) < epsilon:
action_idx = random.randint(0, len(env.actions)-1)
else:
action_idx = np.argmax(q_table[state[0], state[1], :])
action = env.actions[action_idx]
while not done:
# 1. Exécuter l'action choisie à l'étape précédente
next_state, reward, done = env.step(action)
# 2. Choisir une action pour l'état suivant (on-policy, en utilisant toujours ε-greedy)
if random.uniform(0, 1) < epsilon:
next_action_idx = random.randint(0, len(env.actions)-1)
else:
next_action_idx = np.argmax(q_table[next_state[0], next_state[1], :])
next_action = env.actions[next_action_idx]
# 3. Mise à jour principale de SARSA
current_q = q_table[state[0], state[1], action_idx]
# Différence clé : utiliser la valeur Q de l'**action réelle à exécuter** dans l'état suivant
next_q = q_table[next_state[0], next_state[1], next_action_idx]
target_q = reward + gamma * next_q
q_table[state[0], state[1], action_idx] = current_q + alpha * (target_q - current_q)
# 4. Mettre à jour l'état et l'action pour l'itération suivante
state = next_state
action_idx = next_action_idx
action = next_action
return q_table
Test et visualisation de la politique
Exemple
"""Tester la politique apprise"""
total_rewards = []
for _ in range(episodes):
state = env.reset()
done = False
total_reward = 0
steps = []
while not done:
# Utiliser une politique gloutonne pendant le test (aucune exploration)
action_idx = np.argmax(q_table[state[0], state[1], :])
action = env.actions[action_idx]
next_state, reward, done = env.step(action)
steps.append(action[0].upper()) # Enregistrer la première lettre de chaque action
total_reward += reward
state = next_state
total_rewards.append(total_reward)
print(f"Étapes de l'épisode : {steps}, Récompense totale : {total_reward}")
print(f"Récompense moyenne : {np.mean(total_rewards):.2f}")
# Créer l'environnement
env = GridWorld(size=4)
print("=== Entraînement et test de Q-learning ===")
q_table_ql = q_learning(env, episodes=1000)
test_policy(env, q_table_ql)
print("\n"=== Entraînement et test de SARSA ===")
env.reset() # Réinitialiser l'état de l'environnement
q_table_sarsa = sarsa(env, episodes=1000)
test_policy(env, q_table_sarsa)
# Comparer simplement les politiques finales
print("\n=== Comparaison des politiques (actions depuis le point de départ (0,0)) ===)
start_q_values = q_table_ql[0, 0, :]
start_sarsa_values = q_table_sarsa[0, 0, :]
print(f"Valeurs Q de Q-learning : {dict(zip(env.actions, start_q_values))}")
print(f"Action recommandée : {env.actions[np.argmax(start_q_values)]}")
print(f"Valeurs Q de SARSA : {dict(zip(env.actions, start_sarsa_values))}")
print(f"Action recommandée : {env.actions[np.argmax(start_sarsa_values)]}")