Apprentissage par renforcement profond
L'apprentissage par renforcement profond est une direction interdisciplinaire passionnante dans le domaine de l'intelligence artificielle. Nous pouvons le décomposer en deux parties pour le comprendre :
L'apprentissage par renforcementest l'idée centrale, qui simule le processus d'apprentissage des humains ou des animaux par « essai-erreur ». Imaginez que vous apprenez une nouvelle commande à un chiot : lorsqu'il fait correctement, vous lui donnez une friandise en récompense ; lorsqu'il se trompe, il n'y a pas de récompense, voire une légère punition. Après de nombreux essais, le chiot peut apprendre à effectuer l'action correcte dans une situation spécifique pour obtenir des récompenses. L'agent en apprentissage par renforcement est comme ce chiot ; il interagit avec l'environnement et ajuste sa politique comportementale en fonction des récompenses qu'il reçoit.
L'apprentissage profondest un outil puissant. Lorsque l'environnement auquel fait face l'apprentissage par renforcement est très complexe (comme les écrans de jeux vidéo, les données de capteurs de robots), les méthodes mathématiques traditionnelles ont du mal à en extraire directement des caractéristiques utiles pour la prise de décision. L'apprentissage profond, en particulier les réseaux de neurones profonds, excelle dans le traitement de données brutes complexes et de grande dimension (comme les images, le son) et peut apprendre automatiquement des représentations hiérarchiques des caractéristiques des données.
Par conséquent,L'apprentissage par renforcement profond = cadre de prise de décision de l'apprentissage par renforcement + capacités de perception et de représentation de l'apprentissage profond. Il permet aux agents d'apprendre directement comment prendre des actions optimales à partir d'entrées brutes complexes (telles que des pixels) pour atteindre des objectifs à long terme.
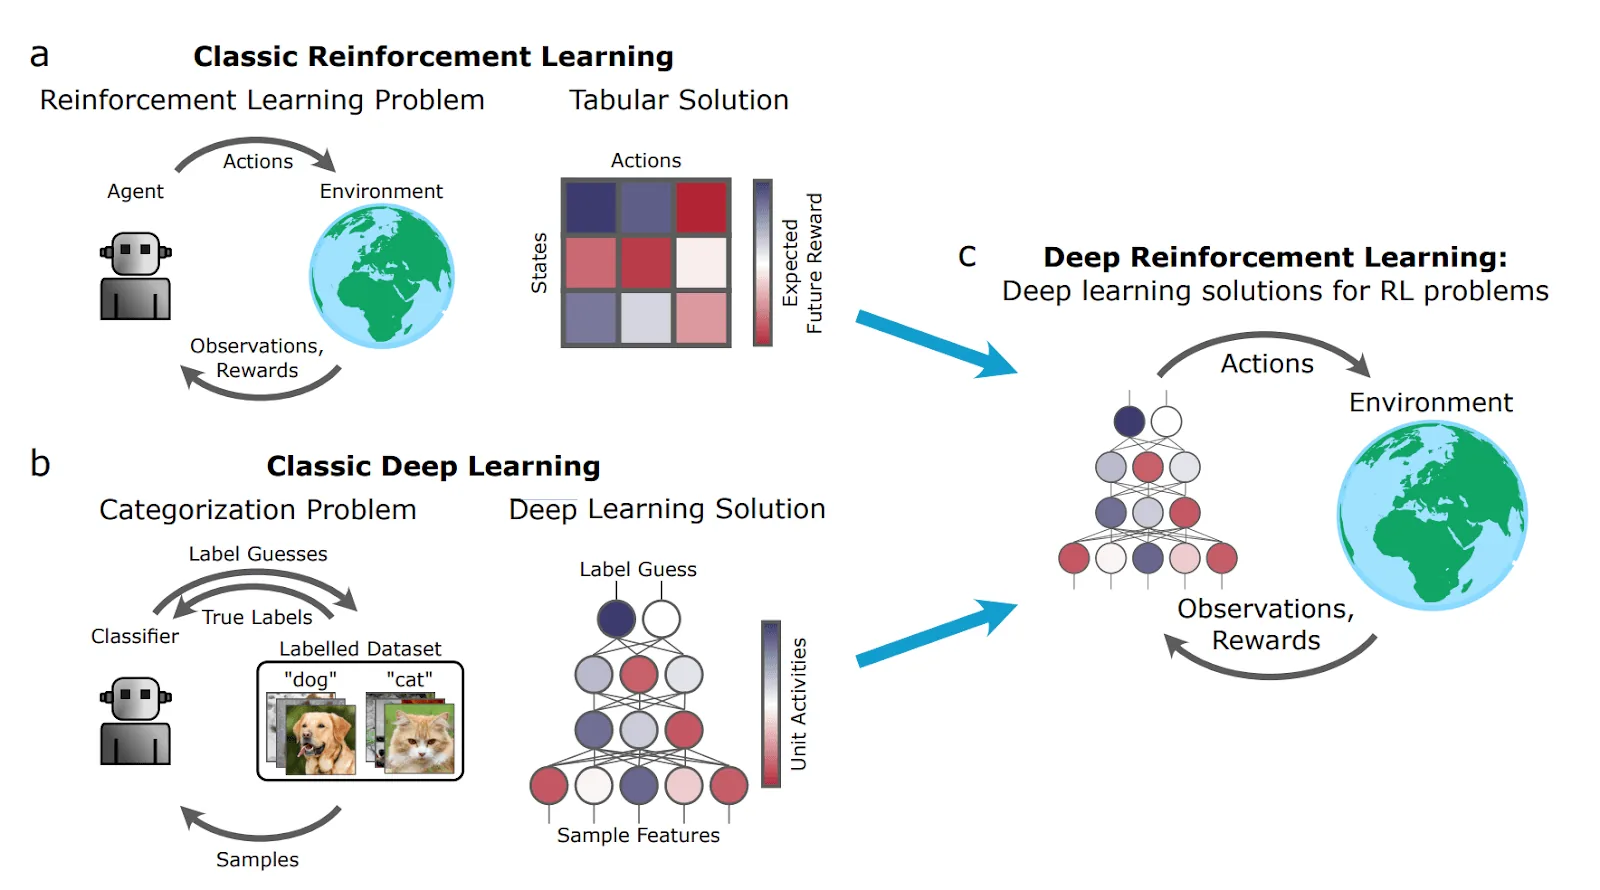
Concepts clés et cadre de base
Pour comprendre l'apprentissage par renforcement profond, vous devez d'abord saisir plusieurs rôles essentiels dans son cadre de base et les relations entre eux.
Éléments de base de l'apprentissage par renforcement
Agent
- Rôle: Apprenant et décideur.
- Responsabilité: Observer l'état de l'environnement, sélectionner des actions selon la politique apprise, exécuter les actions et recevoir les retours (nouvel état et récompense) de l'environnement.
Environnement
- Rôle: Tout ce qui est externe et avec quoi l'agent interagit.
- Responsabilité: Recevoir l'action de l'agent, mettre à jour son propre état et fournir la récompense correspondante.
État (s)
- Définition: Une description de la situation spécifique de l'environnement à un moment donné. En apprentissage par renforcement profond, les états sont généralement de grande dimension, comme une trame d'image de jeu.
Action (a)
- Définition: Choix que l'agent peut faire dans un état donné. Par exemple, dans un jeu, il peut s'agir de « haut », « gauche », « tirer », etc.
Récompense (r)
- Définition: Un signal de retour immédiat de l'environnement à l'action de l'agent, une valeur scalaire. La récompense est la "boussole" de l'apprentissage de l'agent, et son objectif est de maximiser la récompense cumulative à long terme.
Politique (π)
- Définition: Ligne directrice comportementale de l'agent, une fonction de correspondance des états aux actions. Elle indique à l'agent quelle action entreprendre dans un état donné. La politique peut être déterministe (
a = π(s)), ou stochastique (a ~ π(a|s))。
- Définition: Ligne directrice comportementale de l'agent, une fonction de correspondance des états aux actions. Elle indique à l'agent quelle action entreprendre dans un état donné. La politique peut être déterministe (
Fonction de valeur
- Définition: Utilisée pour évaluer la qualité d'un état ou d'une paire état-action. Elle représente ce qui peut être obtenu dans le futur à partir de l'état actuel (ou après l'exécution de l'action actuelle).Récompense cumulative attendue。
- Fonction de valeur d'état V(s): Dans l'état
s, le retour attendu pouvant être obtenu en suivant la politique actuelle. - Fonction de valeur d'action Q(s, a): Dans l'état
s, en exécutant l'actiona, puis le retour attendu pouvant être obtenu en suivant la politique actuelle.
Processus d'interaction
L'interaction entre l'agent et l'environnement est un processus cyclique continu, qui peut être clairement représenté par le diagramme suivant :
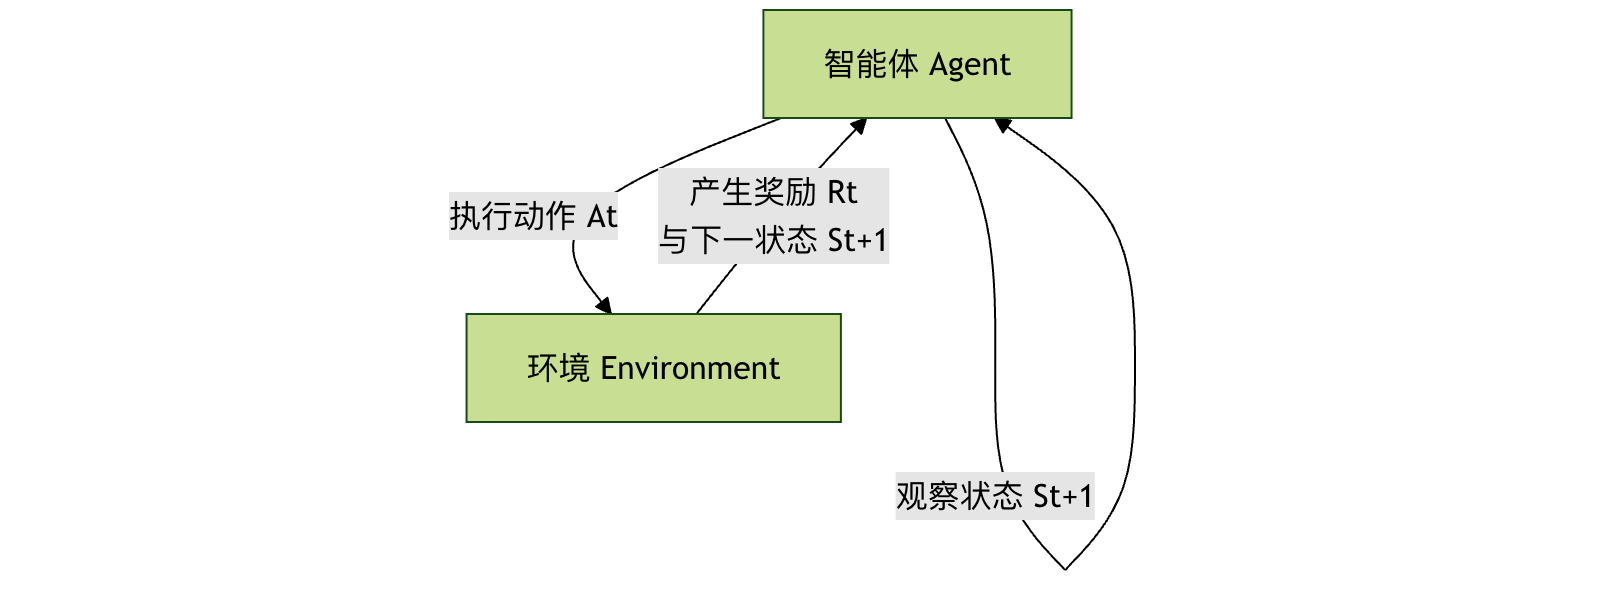
Cette boucle se répète continuellement, et l'agent collecte une grande quantité de données d'interaction (s, a, r, s') et utilise ces données pour améliorer sa politique.
Algorithmes principaux de l'apprentissage par renforcement profond
La famille d'algorithmes de l'apprentissage par renforcement profond se divise principalement en deux grandes catégories :basées sur la valeuretbasées sur la politique, et la méthodeActeur-Critiquequi combine les avantages des deux.
1. Deep Q-Network basé sur la valeur
Le cœur de ce type d'algorithme est d'apprendre la fonction optimalede valeur d'action Q(s, a). Une fois qu'une fonction Q précise est apprise, la politique optimale est simple : dans chaque états, choisir l'action qui peut rendreQ(s, a)l'action avec le maximuma。
Deep Q-Network (DQN)est un travail pionnier. Il utilise des réseaux de neurones profonds pour approximer des fonctions Q complexes.
Innovations techniques clés de DQN :
- Rejeu d'expérience: L'agent stocke les expériences d'interaction
(s, a, r, s')dans un tampon de mémoire. Pendant l'entraînement, un lot d'expériences est échantillonné aléatoirement à partir du tampon pour l'apprentissage. Cela brise la corrélation entre les données, rendant l'entraînement plus stable et efficace. - Réseau cible: Un « réseau cible » de structure identique mais dont les paramètres sont mis à jour plus lentement est utilisé pour calculer les cibles d'apprentissage (valeurs cibles Q), tandis qu'un autre « réseau en ligne » est utilisé pour la sélection des actions et les mises à jour en temps réel. Cela résout le problème des valeurs cibles qui changent constamment pendant l'entraînement et améliore grandement la stabilité.
Un processus d'entraînement DQN simplifié :
- Initialiser le réseau en ligne
Qet le réseau cibleQ_target(avec les mêmes paramètres), et vider le tampon de rejeu d'expérience. - L'agent, en fonction de l'état actuel
s, avec une certaine probabilité, de manière aléatoire ou selon leQréseau sélectionne une actiona。 - Exécuter l'action, l'environnement renvoie une récompense
ret un nouvel états', et stockez l'expérience(s, a, r, s')dans le tampon de relecture. - Échantillonnez aléatoirement un lot d'expériences dans le tampon de relecture.
- Pour chaque échantillon, calculez la valeur Q cible :
y = r + γ * max_a' Q_target(s', a'). Ici,γest le facteur d'actualisation, utilisé pour équilibrer les récompenses immédiates et futures. - with
(y - Q(s, a))^2comme perte, mettez à jour lesQparamètres par descente de gradient. - À chaque fois qu'un certain nombre de pas s'est écoulé, copiez les paramètres du réseau en ligne vers le réseau cible.
- Répétez les étapes 2-7.
Avantages et limites :
- Avantages: Efficacité d'échantillonnage relativement élevée et entraînement relativement stable.
- Limites: Il est intrinsèquement difficile de gérer des espaces d'actions continus (car cela nécessite de calculer
max_a Q(s,a)), et elle ne peut généralement apprendre que des politiques déterministes.
2. Méthodes de gradient de politique basées sur la politique
Ces méthodes paramètrent directement la politiqueπ(a|s; θ)(par exemple, représentée par un réseau de neurones) et optimisent les paramètres de la politiqueθpour maximiser directement le retour attendu.
Idée principale: En calculant le gradient du retour attenduJ(θ)par rapport aux paramètres de la politiqueθ(c'est-à-dire le gradient de politique), puis en mettant à jour les paramètres dans la direction du gradient, la politique s'améliore de plus en plus.
L'algorithme REINFORCEest un algorithme classique de gradient de politique. Sa formule de mise à jour est :θ ← θ + α * ∇_θ log π(a|s; θ) * G_toùG_test la récompense cumulée depuis l'instant courant jusqu'à la fin de l'épisode,αest le taux d'apprentissage.
Avantages et limites :
- Avantages: peut apprendre directement des politiques stochastiques et convient naturellement aux espaces d'action continus.
- Limites: les mises à jour se basent sur l'épisode entier, ce qui entraîne une variance élevée, un entraînement instable et une faible efficacité d'échantillonnage.
3. Méthodes acteur-critique
Le cadre acteur-critique combine astucieusement les méthodes basées sur la valeur et celles basées sur la politique, en complétant mutuellement leurs forces.
- Acteur: un réseau de politique chargé de générer des actions en fonction de l'état. Il est comme un acteur qui améliore sa « performance » (politique) sous la direction d'un critique.
- CritiqueUn réseau de valeur (généralement un réseau Q ou un réseau V) qui évalue la valeur des actions entreprises par l'acteur dans un état donné. Il agit comme un critique, en notant la performance de l'acteur.
Flux de travail :
- L'acteur, en fonction de l'état actuel
set de sa propre politique, sélectionne et exécute une actiona。 - L'environnement renvoie une récompense
ret un nouvel états'。 - Le critique, en se basant sur
(s, a, r, s')calcule l'erreur TD (Temporal-Difference Error, un signal qui mesure la différence entre la valeur prédite et la valeur réelle). - Le critique utilise cette erreur pour mettre à jour son réseau d'estimation de valeur, rendant sa notation plus précise.
- L'acteur utilise les "scores" fournis par le critique (tels que l'erreur TD ou la fonction d'avantage) pour mettre à jour son réseau de politique, ce qui le rend plus enclin à choisir des actions qui reçoivent des scores élevés.
AvantagesLes méthodes acteur-critique ont généralement une variance plus faible et sont plus stables que les méthodes de gradient de politique pures (comme REINFORCE), tout en étant meilleures pour gérer les actions continues et les politiques stochastiques que les méthodes de valeur pures (comme DQN).A3C, A2C, PPO, SACetc. sont tous des algorithmes acteur-critique très performants.
Pratique : jouer à CartPole avec DQN
Utilisons un problème de contrôle classiqueCartPole(équilibrer la perche) pour avoir une idée intuitive de DQN. Dans cet environnement, le chariot peut se déplacer à gauche et à droite, et l'objectif est de maintenir la perche verticale sur le chariot.
Configuration de l'environnement
Nous utilisons la boîte à outils d'apprentissage par renforcement OpenAI Gym.
Exemple
# !pip install gym numpy torch
import gym
import numpy as np
import random
import torch
import torch.nn as nn
import torch.optim as optim
import collections
# Créer l'environnement
env = gym.make('CartPole-v1')
state_dim = env.observation_space.shape[0] # Dimension de l'état : 4 (position du chariot, vitesse, angle du poteau, vitesse angulaire)
action_dim = env.action_space.n # Dimension d'action : 2 (gauche, droite)
print(f"Dimension de l'espace d'état : {state_dim}, taille de l'espace d'action : {action_dim}")
Définir le réseau Q
Il s'agit d'un simple réseau de neurones entièrement connecté, avec l'état en entrée et la valeur Q pour chaque action en sortie.
Exemple
def __init__(self, state_dim, action_dim):
super(DQN, self).__init__()
self.fc1 = nn.Linear(state_dim, 128) # Première couche entièrement connectée
self.fc2 = nn.Linear(128, 128) # Deuxième couche entièrement connectée
self.fc3 = nn.Linear(128, action_dim) # Couche de sortie, une valeur Q par action
def forward(self, x):
x = torch.relu(self.fc1(x)) # Utiliser la fonction d'activation ReLU pour introduire une non-linéarité
x = torch.relu(self.fc2(x))
return self.fc3(x) # Valeurs Q de sortie, sans fonction d'activation
Définir le tampon de rejeu d'expérience
Utilisé pour stocker et échantillonner les expériences passées.
Exemple
def __init__(self, capacity):
self.buffer = collections.deque(maxlen=capacity) # File d'attente à double extrémité, supprime automatiquement les anciennes expériences
def add(self, state, action, reward, next_state, done):
self.buffer.append((state, action, reward, next_state, done))
def sample(self, batch_size):
transitions = random.sample(self.buffer, batch_size)
# Organiser les données en tenseurs empilés par colonne pour un traitement par lots efficace par le réseau de neurones
state, action, reward, next_state, done = zip(*transitions)
return (np.array(state), action, reward, np.array(next_state), done)
def size(self):
return len(self.buffer)
Définir l'agent DQN
Intègre le réseau, le rejeu d'expériences et la logique d'entraînement.
Exemple
def __init__(self, state_dim, action_dim, lr=1e-3, gamma=0.98, epsilon=0.01,
target_update_freq=10, buffer_size=10000, batch_size=64):
self.action_dim = action_dim
self.q_net = DQN(state_dim, action_dim) # Réseau en ligne
self.target_q_net = DQN(state_dim, action_dim) # Réseau cible
self.target_q_net.load_state_dict(self.q_net.state_dict()) # Mêmes paramètres initiaux
self.optimizer = optim.Adam(self.q_net.parameters(), lr=lr) # Optimiseur
self.gamma = gamma # Facteur d'actualisation
self.epsilon = epsilon # Taux d'exploration (final)
self.target_update_freq = target_update_freq # Fréquence de mise à jour du réseau cible
self.batch_size = batch_size
self.buffer = ReplayBuffer(buffer_size)
self.count = 0 # Enregistrer les étapes de mise à jour
def take_action(self, state, epsilon=None):
"""Sélectionner l'action selon la politique epsilon-greedy"""
if epsilon is None:
epsilon = self.epsilon
if np.random.random() < epsilon:
return np.random.randint(self.action_dim) # Exploration: choix aléatoire
else:
state = torch.tensor(state, dtype=torch.float).unsqueeze(0) # Ajouter une dimension de lot
with torch.no_grad():
q_values = self.q_net(state)
return q_values.argmax().item() # Exploitation : choisir l'action ayant la plus grande valeur Q
def update(self):
"""Échantillonner depuis le tampon de relecture d'expérience et mettre à jour le réseau"""
if self.buffer.size() < self.batch_size:
return
# 1. Échantillonner
states, actions, rewards, next_states, dones = self.buffer.sample(self.batch_size)
# Convertir en tenseurs PyTorch
states = torch.tensor(states, dtype=torch.float)
actions = torch.tensor(actions).unsqueeze(1) # La forme devient [batch_size, 1], pratique pour l'opération gather
rewards = torch.tensor(rewards, dtype=torch.float).unsqueeze(1)
next_states = torch.tensor(next_states, dtype=torch.float)
dones = torch.tensor(dones, dtype=torch.float).unsqueeze(1)
# 2. Calculer la valeur Q actuelle (Q(s, a))
current_q_values = self.q_net(states).gather(1, actions) # Extraire uniquement la valeur Q correspondant à l'action exécutée a
# 3. Calculer la valeur Q cible (r + γ * max_a' Q_target(s', a'))
with torch.no_grad():
next_q_values = self.target_q_net(next_states).max(1)[0].unsqueeze(1) # Prendre la valeur Q maximale de l'état suivant
target_q_values = rewards + self.gamma * next_q_values * (1 - dones) # Si l'épisode se termine (done=1), il n'y a pas de récompense future
# 4. Calculer la perte (erreur quadratique moyenne)
loss = nn.MSELoss()(current_q_values, target_q_values)
# 5. Mettre à jour le réseau en ligne avec la descente de gradient
self.optimizer.zero_grad()
loss.backward()
# Facultatif : écrêtage du gradient pour éviter l'explosion du gradient
# torch.nn.utils.clip_grad_norm_(self.q_net.parameters(), max_norm=10)
self.optimizer.step()
self.count += 1
# 6. Mettre à jour périodiquement le réseau cible
if self.count % self.target_update_freq == 0:
self.target_q_net.load_state_dict(self.q_net.state_dict())
Boucle d'entraînement
Exemple
"""Entraîner l'agent"""
return_list = [] # Enregistrer la récompense totale pour chaque épisode
epsilon = initial_epsilon
for i_episode in range(num_episodes):
state, _ = env.reset()
episode_return = 0
done = False
for step in range(max_steps):
# 1. Sélectionner et exécuter l'action
action = agent.take_action(state, epsilon) # Utiliser le taux d'exploration décroissant
next_state, reward, done, truncated, _ = env.step(action)
# 2. Stocker l'expérience
agent.buffer.add(state, action, reward, next_state, done)
state = next_state
episode_return += reward
# 3. Mettre à jour le réseau
agent.update()
if done or truncated:
break
# Décroissance du taux d'exploration
epsilon = max(agent.epsilon, epsilon * epsilon_decay)
return_list.append(episode_return)
if (i_episode + 1) % 50 == 0:
print(f"Épisode : {i_episode+1}, Récompense moyenne (50 derniers épisodes) : {np.mean(return_list[-50:]):.1f}, Taux d'exploration : {epsilon:.3f}")
print("Entraînement terminé !")
return return_list
# Créer l'agent et démarrer l'entraînement
agent = DQNAgent(state_dim, action_dim, lr=1e-3, gamma=0.99, epsilon=0.01)
returns = train_agent(env, agent, num_episodes=300)
Tester l'agent entraîné
Exemple
"""Tester la performance de l'agent"""
total_rewards = []
for i in range(num_episodes):
state, _ = env.reset()
episode_return = 0
done = False
while not done:
if render:
env.render() # Visualiser l'environnement ; lors d'une exécution locale, vous pouvez voir le chariot équilibrer la perche
action = agent.take_action(state) # Utiliser un taux d'exploration minimal pendant les tests (c'est-à-dire une exploitation pure)
next_state, reward, done, truncated, _ = env.step(action)
state = next_state
episode_return += reward
if done or truncated:
break
total_rewards.append(episode_return)
print(f"Épisode de test {i+1} : Récompense totale = {episode_return}")
env.close()
print(f"Récompense moyenne de test : {np.mean(total_rewards):.1f}")
# Tester l'agent
test_agent(env, agent, num_episodes=3, render=False) # Définir render=False dans les environnements sans interface graphique
Défis et orientations futures de l'apprentissage par renforcement profond
Malgré son grand succès, l'apprentissage par renforcement profond reste confronté à de nombreux défis :
- Faible efficacité d'échantillonnage: Il nécessite généralement bien plus de données interactives que les humains ou les méthodes traditionnelles pour apprendre une tâche.
- Entraînement instable: Très sensible aux hyperparamètres (taux d'apprentissage, structure du réseau, etc.), et le processus d'entraînement peut facilement diverger.
- La conception de la récompense est difficile: Concevoir une fonction de récompense qui guide correctement l'agent vers l'objectif final est en soi un défi.
- Sécurité et interprétabilité: Comment garantir que le comportement de l'agent est sûr, fiable et conforme aux attentes, et comprendre son processus de décision.
La recherche future s'oriente vers des algorithmes plus efficaces (tels que l'apprentissage par renforcement basé sur un modèle), un apprentissage de représentation plus performant, l'apprentissage multi-tâches et le méta-apprentissage, ainsi qu'un alignement sûr avec le monde réel.
Résumé et exercices
L'apprentissage par renforcement profond combine les capacités de perception de l'apprentissage profond avec le cadre décisionnel de l'apprentissage par renforcement, permettant aux machines d'apprendre à accomplir des tâches avancées dans des environnements complexes. Vous avez appris ses concepts fondamentaux, ses principales familles d'algorithmes et acquis une expérience pratique avec le code de mise en pratique DQN.
Exercices et réflexion :
- Modifier le code: Essayez d'ajuster les hyperparamètres dans
DQNAgent(tel quelr,gamma,batch_size), et observez leur impact sur la vitesse d'entraînement et les performances finales. - Changez l'environnement: Essayez d'appliquer le code à d'autres environnements Gym, tels que
MountainCar-v0ouLunarLander-v2. Assurez-vous d'ajuster les dimensions d'état et d'action. - Comparaison d'algorithmes: Renseignez-vous sur et essayez d'implémenter un algorithme simple de gradient de politique (tel que REINFORCE) pour résoudre le problème CartPole, et comparez ses différences avec DQN en matière de stabilité d'entraînement et d'efficacité d'échantillonnage.
- Exploration plus approfondie: Choisissez un algorithme avancé moderne (tel que PPO ou SAC), lisez son article ou son implémentation open source, et comprenez comment il résout les problèmes présents dans DQN ou les gradients de politique.