FFT (Fast Fourier Transform), также известное как быстрое преобразование Фурье, — это эффективный алгоритм для DFT (Discrete Fourier Transform). Этот алгоритм играет незаменимую роль в методах цифровой обработки, основанных на анализе с помощью частотно-временного преобразования.
Принцип FFT
Вывод формулы
Формула вычисления DFT:
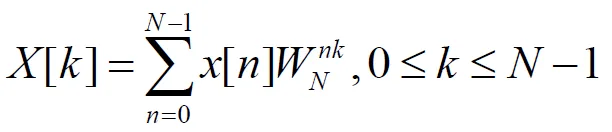
где,
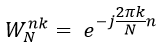
Разделив формулу дискретного преобразования Фурье на нечётные и чётные члены, первые N/2 точек можно выразить как:
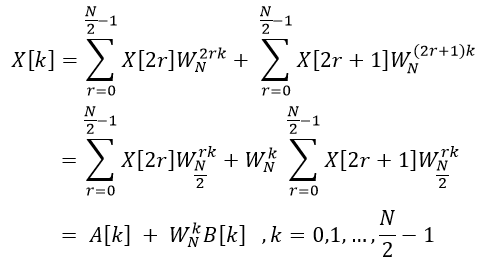
Аналогично, последние N/2 точек можно выразить как:
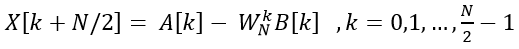
Видно, что значения последних N/2 точек могут быть полностью определены промежуточными значениями, полученными при вычислении первых N/2 точек. Продолжайте выполнять чётно-нечётное разложение A[k] и B[k], пока оно не станет 2-точечным DFT, что позволяет избежать множества повторных вычислений и реализует процесс быстрого дискретного преобразования Фурье (FFT).
Структура алгоритма
Структурная схема вычисления 8-точечного FFT выглядит следующим образом.
Из рисунка видно, что процесс DFT можно выполнить всего лишь с помощью нескольких простых умножений и сложений, а не утомительного умножения и накопления для каждого элемента данных.

Важные характеристики
(1) Понятие этапа
Каждое разбиение называется одним этапом вычислений.
Пусть число точек вычисления FFT равно N, а общее число этапов равно M; они удовлетворяют:
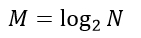
Каждый этап обозначается m = 0, 1, 2, ..., M-1.
Для удобства разбиения вычислений число точек БПФ N часто выбирают равным целой степени 2.
(2) Блок «бабочка»
Структура вычисления БПФ состоит из нескольких блоков операции «бабочка». Принципиальная схема каждого блока операции выглядит следующим образом:
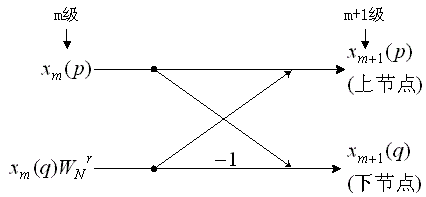
Вход и выход блока «бабочка» удовлетворяют:
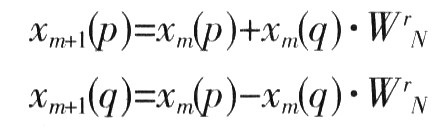
где,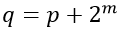
Каждый блок «бабочка» при работе выполняет одно умножение и два сложения.
На каждой ступени имеется N/2 блоков «бабочка».
Следовательно, число умножений и сложений, необходимых для выполнения одного БПФ, соответственно равно:
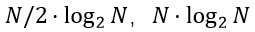
(3) Понятие группы
N/2 блоков «бабочка» на каждой ступени можно разделить на несколько групп, причём каждая группа имеет одинаковую структуру и распределение поворотных коэффициентов.
Например, при m=0 их можно разделить на N/2=4 группы.
При m=1 их можно разделить на N/4=2 группы.
Когда m=M-1, его можно разделить только на 1 группу.
(4) Распределение поворотных коэффициентов Поворотный коэффициент присутствует на этапе m, где
 。
На второй ступени 8-точечного БПФ, т. е. при m=1, поворотный коэффициент операции «бабочка» можно упростить до:
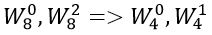
(5) Реверсирование битов
Для вычисления N=8-точечного БПФ двоичные коды, соответствующие позициям X(0) ~ X(7), имеют вид:
X(000), X(001), X(010), X(011), X(100), X(101), X(110), X(111)
Реверсируйте двоичные коды их позиций:
X(000), X(100), X(010), X(110), X(001), X(101), X(011), X(111)
Десятичные значения, соответствующие позициям в этот момент, следующие:
X(0), X(4), X(2), X(6), X(1), X(5), X(3), X(7)
Это в точности соответствует порядку входных данных для первой ступени БПФ.
Эта особенность полезна для программной реализации БПФ.
Проектирование БПФ
Описание проекта
Чтобы просто проиллюстрировать процесс преобразования БПФ с помощью моделирования, количество точек данных установлено равным небольшому значению 8.
Если данные вводятся последовательно, их сначала нужно буферизовать, поэтому в данном проекте используется параллельный способ ввода данных.
Входные данные разделены на две части: действительную и мнимую, поэтому результаты вычислений также разделены на действительную и мнимую части.
В проекте используется конвейерная структура, и потребление ресурсов пока не учитывается.
Чтобы упростить структуру проекта, здесь сделан компромисс: в операции умножения напрямую используется оператор умножения. Если проект БПФ применяется на практике, структуру умножения необходимо заменить на конвейерный умножитель или использовать официальный высокоэффективный IP-умножитель.
Проектирование блока бабочки
Блок бабочки использует операции с фиксированной запятой, поэтому поворотный коэффициент необходимо квантовать в формат с фиксированной запятой.
Умножьте поворотный коэффициент на 8192 в MATLAB (сдвиг влево на 13 бит); см. приложение.
Чтобы умножение и сложение в операциях бабочки не увеличивали разрядность от каскада к каскаду, после каждого каскада вычислений выходные данные необходимо усечь до фиксированной разрядности. Это также устраняет влияние масштабирования поворотного коэффициента. Код выглядит следующим образом:
Пример
/**************** блок бабочки *************************
Xm(p) ------------------------> Xm+1(p)
- ->
- -
-
- -
- ->
Xm(q) ------------------------> Xm+1(q)
Wn -1
*//////////////////////////////////////////////////////
module butterfly
(
input clk,
input rstn,
input en,
input signed [23:0] xp_real, // Xm(p)
input signed [23:0] xp_imag,
input signed [23:0] xq_real, // Xm(q)
input signed [23:0] xq_imag,
input signed [15:0] factor_real, // Wnr
input signed [15:0] factor_imag,
output valid,
output signed [23:0] yp_real, //Xm+1(p)
output signed [23:0] yp_imag,
output signed [23:0] yq_real, //Xm+1(q)
output signed [23:0] yq_imag);
reg [4:0] en_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
en_r <= 'b0 ;
end
else begin
en_r <= {en_r[3:0], en} ;
end
end
//=====================================================//
//(1.0) Xm(q) умножение и Xm(p) задержка
reg signed [39:0] xq_wnr_real0;
reg signed [39:0] xq_wnr_real1;
reg signed [39:0] xq_wnr_imag0;
reg signed [39:0] xq_wnr_imag1;
reg signed [39:0] xp_real_d;
reg signed [39:0] xp_imag_d;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
xp_real_d <= 'b0;
xp_imag_d <= 'b0;
xq_wnr_real0 <= 'b0;
xq_wnr_real1 <= 'b0;
xq_wnr_imag0 <= 'b0;
xq_wnr_imag1 <= 'b0;
end
else if (en) begin
xq_wnr_real0 <= xq_real * factor_real;
xq_wnr_real1 <= xq_imag * factor_imag;
xq_wnr_imag0 <= xq_real * factor_imag;
xq_wnr_imag1 <= xq_imag * factor_real;
//расширение в 8192 раза как Wnr
xp_real_d <= {{4{xp_real[23]}}, xp_real[22:0], 13'b0};
xp_imag_d <= {{4{xp_imag[23]}}, xp_imag[22:0], 13'b0};
end
end
//(1.1) получить результаты умножения Xm(q) и снова задержать Xm(p)
reg signed [39:0] xp_real_d1;
reg signed [39:0] xp_imag_d1;
reg signed [39:0] xq_wnr_real;
reg signed [39:0] xq_wnr_imag;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
xp_real_d1 <= 'b0;
xp_imag_d1 <= 'b0;
xq_wnr_real <= 'b0 ;
xq_wnr_imag <= 'b0 ;
end
else if (en_r[0]) begin
xp_real_d1 <= xp_real_d;
xp_imag_d1 <= xp_imag_d;
// Заранее задайте запас по разрядности, чтобы предотвратить переполнение данных
xq_wnr_real <= xq_wnr_real0 - xq_wnr_real1 ;
xq_wnr_imag <= xq_wnr_imag0 + xq_wnr_imag1 ;
end
end
//======================================================//
//(2.0) результаты butter
reg signed [39:0] yp_real_r;
reg signed [39:0] yp_imag_r;
reg signed [39:0] yq_real_r;
reg signed [39:0] yq_imag_r;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
yp_real_r <= 'b0;
yp_imag_r <= 'b0;
yq_real_r <= 'b0;
yq_imag_r <= 'b0;
end
else if (en_r[1]) begin
yp_real_r <= xp_real_d1 + xq_wnr_real;
yp_imag_r <= xp_imag_d1 + xq_wnr_imag;
yq_real_r <= xp_real_d1 - xq_wnr_real;
yq_imag_r <= xp_imag_d1 - xq_wnr_imag;
end
end
//(3) отбросить младшие 13 бит из-за Wnr
assign yp_real = {yp_real_r[39], yp_real_r[13+23:13]};
assign yp_imag = {yp_imag_r[39], yp_imag_r[13+23:13]};
assign yq_real = {yq_real_r[39], yq_real_r[13+23:13]};
assign yq_imag = {yq_imag_r[39], yq_imag_r[13+23:13]};
assign valid = en_r[2];
endmodule
Инстанцирование верхнего уровня
В соответствии со структурной схемой алгоритма БПФ создайте экземпляры блоков-бабочек, чтобы реализовать окончательную функцию БПФ.
Вы можете вручную создать 12 экземпляров последовательно в соответствии с соответствием входов и выходов блоков-бабочек на каждом этапе либо использовать generate для создания экземпляров. В этом случае вам нужно хорошо разбираться в особенностях «групп» и «этапов» в БПФ:
-
(1) Проект 8-точечного БПФ требует 3 этапов вычислений. На каждом этапе имеется 4 блока-бабочки, а количество групп на каждом этапе составляет соответственно 4, 2 и 1.
-
(2) На каждой ступени расстояние между двумя входными портами блока бабочки внутри группы всегда
 (m — индекс ступени, соответствующий операции сдвига влево 1<<m); расстояние между первыми входными портами двух блоков бабочки в группе равно 1.
-
(3) Расстояние между первыми входными портами первых блоков бабочки соседних групп на каждой ступени равно
 (соответствует операции сдвига влево 2<<m).
Код инстанцирования выглядит следующим образом.
Здесь одномерные и двумерные адреса матричных сигналов xm_real (xm_imag) — это идентификаторы, представляющие ступень и группу.
При определении связей между сигнальными портами используется кажущаяся сложной логика проверки, и она также содержит операторы умножения. Фактически итоговая сгенерированная схема в точности совпадает с написанным вручную кодом для инстанцирования 12 блоков бабочки. Это объясняется тем, что переменные в блоке generate лишь помогают генерировать реальную схему, а вычисление и проверка соответствующих значений выполняются во время компиляции. Эти переменные, конечно, не создают реальных схем; они лишь предоставляют способ более быстрого инстанцирования модулей.
Пример
module fft8 (
input clk,
input rstn,
input en,
input signed [23:0] x0_real,
input signed [23:0] x0_imag,
input signed [23:0] x1_real,
input signed [23:0] x1_imag,
input signed [23:0] x2_real,
input signed [23:0] x2_imag,
input signed [23:0] x3_real,
input signed [23:0] x3_imag,
input signed [23:0] x4_real,
input signed [23:0] x4_imag,
input signed [23:0] x5_real,
input signed [23:0] x5_imag,
input signed [23:0] x6_real,
input signed [23:0] x6_imag,
input signed [23:0] x7_real,
вход знаковый [23:0] x7_imag,
output valid,
выход знаковый [23:0] y0_real,
выход знаковый [23:0] y0_imag,
выход знаковый [23:0] y1_real,
выход знаковый [23:0] y1_imag,
выход знаковый [23:0] y2_real,
выход знаковый [23:0] y2_imag,
выход знаковый [23:0] y3_real,
выход знаковый [23:0] y3_imag,
выход знаковый [23:0] y4_real,
выход знаковый [23:0] y4_imag,
выход знаковый [23:0] y5_real,
output signed [23:0] y5_imag,
output signed [23:0] y6_real,
output signed [23:0] y6_imag,
output signed [23:0] y7_real,
output signed [23:0] y7_imag
);
//рабочие данные
wire signed [23:0] xm_real [3:0] [7:0];
wire signed [23:0] xm_imag [3:0] [7:0];
wire en_connect [15:0] ;
assign en_connect[0] = en;
assign en_connect[1] = en;
assign en_connect[2] = en;
assign en_connect[3] = en;
//коэффициент, умноженный на 0x2000
wire signed [15:0] factor_real [3:0] ;
wire signed [15:0] factor_imag [3:0];
assign factor_real[0] = 16'h2000; //1
assign factor_imag[0] = 16'h0000; //0
assign factor_real[1] = 16'h16a0; //sqrt(2)/2
assign factor_imag[1] = 16'he95f; //-sqrt(2)/2
assign factor_real[2] = 16'h0000; //0
assign factor_imag[2] = 16'he000; //-1
assign factor_real[3] = 16'he95f; //-sqrt(2)/2
assign factor_imag[3] = 16'he95f; //-sqrt(2)/2
// Инициализация входных данных; связана с обратным порядком битов
assign xm_real[0][0] = x0_real;
assign xm_real[0][1] = x4_real;
assign xm_real[0][2] = x2_real;
assign xm_real[0][3] = x6_real;
assign xm_real[0][4] = x1_real;
assign xm_real[0][5] = x5_real;
assign xm_real[0][6] = x3_real;
assign xm_real[0][7] = x7_real;
assign xm_imag[0][0] = x0_imag;
assign xm_imag[0][1] = x4_imag;
assign xm_imag[0][2] = x2_imag;
assign xm_imag[0][3] = x6_imag;
assign xm_imag[0][4] = x1_imag;
assign xm_imag[0][5] = x5_imag;
assign xm_imag[0][6] = x3_imag;
assign xm_imag[0][7] = x7_imag;
//инстанцирование butter
//integer index[11:0] ;
genvar m, k;
generate
//3 ступени
for(m=0; m<=2; m=m+1) begin: stage
for (k=0; k<=3; k=k+1) begin: единица
butterfly u_butter(
.clk (clk ) ,
.rstn (rstn ) ,
.en (en_connect[m*4 + k] ) ,
// Находится ли внутри группы? индекс группы + внутригрупповой индекс : индекс следующей группы + новый внутригрупповой индекс
.xp_real (xm_real[ m ] [k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))] ),
.xp_imag (xm_imag[ m ] [k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))] ),
.xq_real (xm_real[ m ] [(k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))) + (1<<m) ]), // Увеличить расстояние между двумя входными портами блока butterfly
.xq_imag (xm_imag[ m ] [(k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))) + (1<<m) ]),
.factor_real(factor_real[k[m:0]<(1<<m)?
k[m:0] : k[m:0]-(1<<m) ]),
.factor_imag(factor_imag[k[m:0]<(1<<m)?
k[m:0] : k[m:0]-(1<<m) ]),
//выходные данные
.valid (en_connect[ (m+1)*4 + k ] ),
.yp_real (xm_real[ m+1 ][k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))] ),
.yp_imag (xm_imag[ m+1 ][(k[m:0]) < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))] ),
.yq_real (xm_real[ m+1 ][(k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))) + (1<<m) ]),
.yq_imag (xm_imag[ m+1 ][((k[m:0]) < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))) + (1<<m) ])
);
end
end
endgenerate
assign valid = en_connect[12];
assign y0_real = xm_real[3][0] ;
assign y0_imag = xm_imag[3][0] ;
присвоить y1_real = xm_real[3][1] ;
присвоить y1_imag = xm_imag[3][1] ;
присвоить y2_real = xm_real[3][2] ;
присвоить y2_imag = xm_imag[3][2] ;
присвоить y3_real = xm_real[3][3] ;
присвоить y3_imag = xm_imag[3][3] ;
присвоить y4_real = xm_real[3][4] ;
присвоить y4_imag = xm_imag[3][4] ;
присвоить y5_real = xm_real[3][5] ;
присвоить y5_imag = xm_imag[3][5] ;
присвоить y6_real = xm_real[3][6] ;
присвоить y6_imag = xm_imag[3][6] ;
assign y7_real = xm_real[3][7] ;
assign y7_imag = xm_imag[3][7] ;
endmodule
testbench
Тестовый стенд написан следующим образом, в основном для непрерывного ввода 16 каналов вещественных и комплексных данных. Поскольку каждое БПФ имеет только 8 точек данных, входные данные произвольны, а не регулярны, как, например, синусоидальные волны.
Пример
module test ;
reg clk;
reg rstn;
reg en ;
reg signed [23:0] x0_real;
reg signed [23:0] x0_imag;
reg signed [23:0] x1_real;
reg signed [23:0] x1_imag;
reg signed [23:0] x2_real;
reg signed [23:0] x2_imag;
reg signed [23:0] x3_real;
reg signed [23:0] x3_imag;
reg signed [23:0] x4_real;
reg signed [23:0] x4_imag;
reg signed [23:0] x5_real;
reg signed [23:0] x5_imag;
reg signed [23:0] x6_real;
reg signed [23:0] x6_imag;
reg signed [23:0] x7_real;
reg signed [23:0] x7_imag;
wire valid;
wire signed [23:0] y0_real;
wire signed [23:0] y0_imag;
wire signed [23:0] y1_real;
wire signed [23:0] y1_imag;
wire signed [23:0] y2_real;
wire signed [23:0] y2_imag;
wire signed [23:0] y3_real;
wire signed [23:0] y3_imag;
wire signed [23:0] y4_real;
wire signed [23:0] y4_imag;
wire signed [23:0] y5_real;
wire signed [23:0] y5_imag;
wire signed [23:0] y6_real;
wire signed [23:0] y6_imag;
wire signed [23:0] y7_real;
wire signed [23:0] y7_imag;
initial begin
clk = 0; //50MHz
rstn = 0 ;
#10 rstn = 1;
forever begin
#10 clk = ~clk; //50MHz
end
end
fft8 u_fft (
.clk (clk ),
.rstn (rstn ),
.en (en ),
.x0_real (x0_real),
.x0_imag (x0_imag),
.x1_real (x1_real),
.x1_imag (x1_imag),
.x2_real (x2_real),
.x2_imag (x2_imag),
.x3_real (x3_real),
.x3_imag (x3_imag),
.x4_real (x4_real),
.x4_imag (x4_imag),
.x5_real (x5_real),
.x5_imag (x5_imag),
.x6_real (x6_real),
.x6_imag (x6_imag),
.x7_real (x7_real),
.x7_imag (x7_imag),
.valid (valid),
.y0_real (y0_real),
.y0_imag (y0_imag),
.y1_real (y1_real),
.y1_imag (y1_imag),
.y2_real (y2_real),
.y2_imag (y2_imag),
.y3_real (y3_real),
.y3_imag (y3_imag),
.y4_real (y4_real),
.y4_imag (y4_imag),
.y5_real (y5_real),
.y5_imag (y5_imag),
.y6_real (y6_real),
.y6_imag (y6_imag),
.y7_real (y7_real),
.y7_imag (y7_imag));
//ввод данных
initial begin
en = 0 ;
x0_real = 24'd10;
⟦⟧x1_real = 24'd20;
x_real = 24'd30;
x3_real = 24'd40;
x4_real = 24'd10;
x5_real = 24'd20;
x6_real = 24'd30;
x7_real = 24'd40;
x0_imag = 24'd0;
x1_imag = 24'd0;
x2_imag = 24'd0;
x3_imag = 24'd0;
x4_imag = 24'd0;
x5_imag = 24'd0;
x6_imag = 24'd0;
x7_imag = 24'd0;
@(negedge clk) ;
en = 1 ;
forever begin
@(negedge clk) ;
x0_real = (x0_real > 22'h3F_ffff) ? 'b0 : x0_real + 1 ;
x1_real = (x1_real > 22'h3F_ffff) ? 'b0 : x1_real + 1 ;
x2_real = (x2_real > 22'h3F_ffff) ? 'b0 : x2_real + 31 ;
x3_real = (x3_real > 22'h3F_ffff) ? 'b0 : x3_real + 1 ;
x4_real = (x4_real > 22'h3F_ffff) ? 'b0 : x4_real + 23 ;
x5_real = (x5_real > 22'h3F_ffff) ? 'b0 : x5_real + 1 ;
x6_real = (x6_real > 22'h3F_ffff) ? 'b0 : x6_real + 6 ;
x7_real = (x7_real > 22'h3F_ffff) ? 'b0 : x7_real + 1 ;
x0_imag = (x0_imag > 22'h3F_ffff) ? 'b0 : x0_imag + 2 ;
x1_imag = (x1_imag > 22'h3F_ffff) ? 'b0 : x1_imag + 5 ;
x2_imag = (x2_imag > 22'h3F_ffff) ? 'b0 : x2_imag + 3 ;
x3_imag = (x3_imag > 22'h3F_ffff) ? 'b0 : x3_imag + 6 ;
x4_imag = (x4_imag > 22'h3F_ffff) ? 'b0 : x4_imag + 4 ;
x5_imag = (x5_imag > 22'h3F_ffff) ? 'b0 : x5_imag + 8 ;
x6_imag = (x6_imag > 22'h3F_ffff) ? 'b0 : x6_imag + 11 ;
x7_imag = (x7_imag > 22'h3F_ffff) ? 'b0 : x7_imag + 7 ;
end
end
//завершить моделирование
initial #1000 $finish ;
endmodule
Результаты моделирования
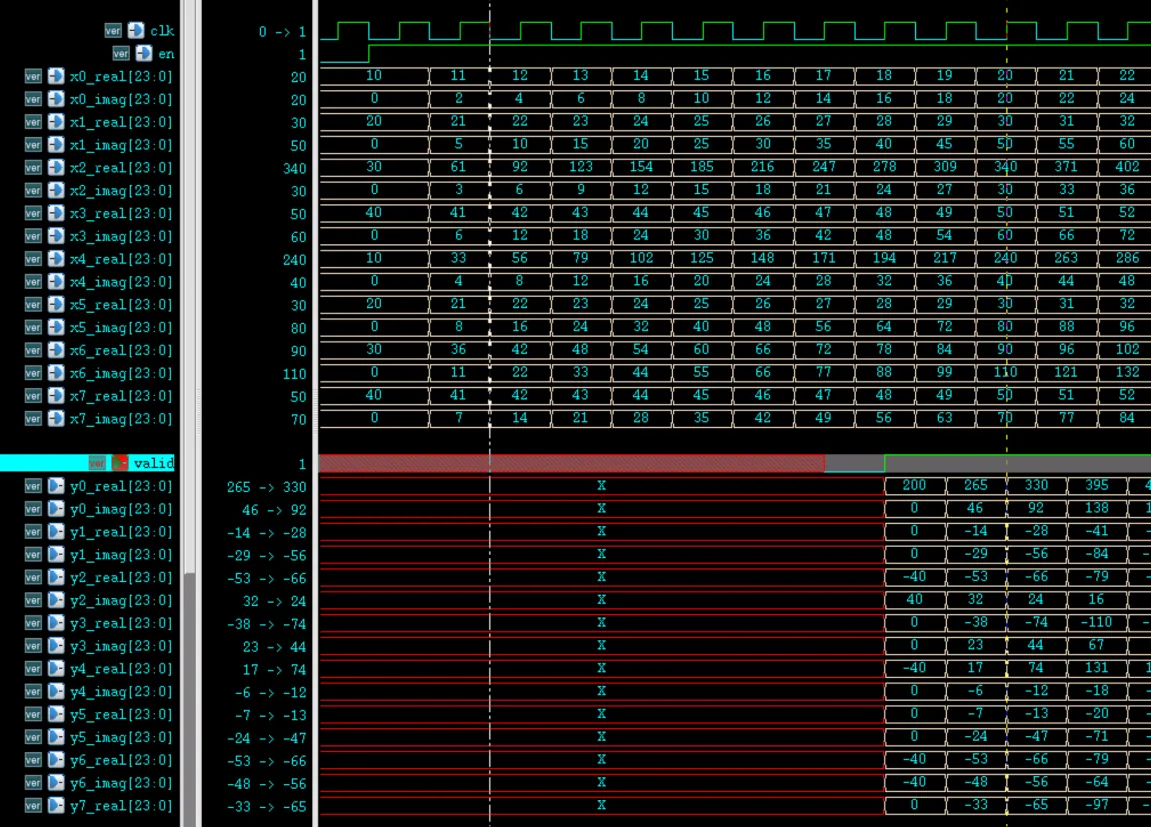
Можно приблизительно увидеть, что результаты БПФ могут выводиться конвейерным способом.
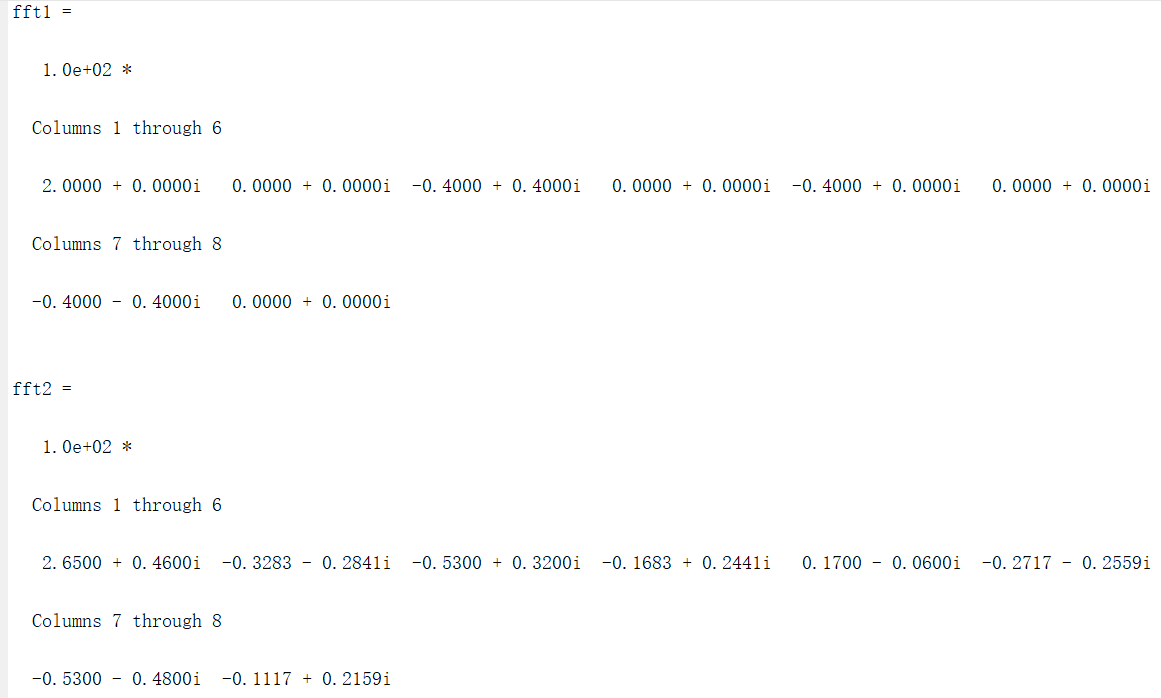
Используя встроенную функцию БПФ MATLAB для обработки тех же данных, результаты БПФ первых 2 групп данных выглядят следующим образом.
Видно, что когда у первого входного сигнала данных действительна только вещественная часть, результаты БПФ полностью совпадают.
Однако, когда вторые входные данные также содержат сигнал в мнимой части, в результатах этих двух начинают появляться ошибки, и иногда ошибки довольно велики.
При моделировании в MATLAB процесса БПФ, реализованного на Verilog, обнаружено, что результаты БПФ этого процесса в основном совпадают с результатами БПФ, реализованного на Verilog.
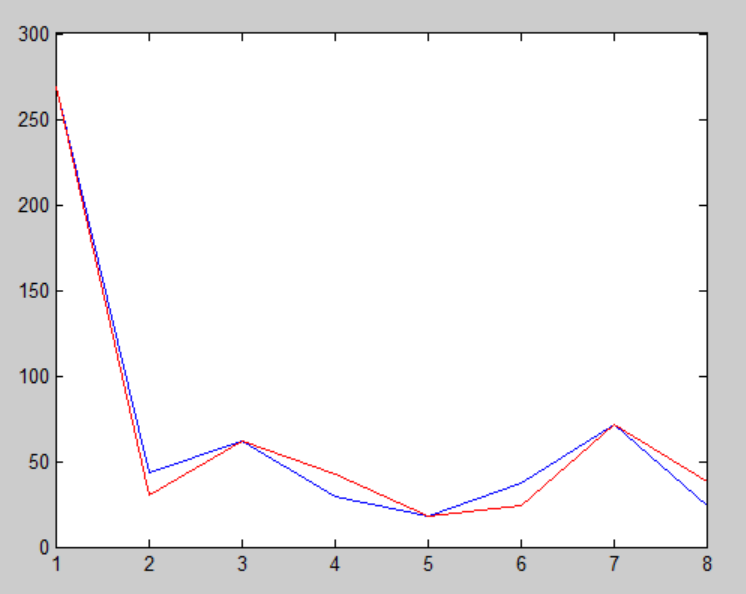
Возьмите абсолютные значения двух ошибочных результатов БПФ для сравнения, как показано на рисунке ниже.
Видно, что тенденции результатов БПФ примерно одинаковы, но в отдельных точках видны ошибки.
Итоги проектирования:
Как упоминалось при проектировании блока «бабочка», при квантовании поворотного множителя выбор разрядности вносит ошибки.
Кроме того, результат операции каждого блока «бабочка» усекается, что также вносит ошибки.
MATLAB не нужно учитывать вопросы точности при вычислении БПФ; он выполняет вычисления БПФ над данными с максимальной точностью.
Всё вышеперечисленное приведёт к различиям между результатами двух методов вычисления БПФ.
Заинтересованные читатели могут дополнительно увеличить разрядность поворотного множителя и входных данных, а также увеличить число точек БПФ, затем выполнить сравнительное моделирование; относительная ошибка должна уменьшиться.
Приложение: использование MATLAB
Генерация поворотных множителей
8-точечное БПФ требует всего 4 поворотных множителя. Поворотные множители масштабируются с коэффициентом 8192.
Пример
%=======================================================
% Вычисление Wnr
%=======================================================
for r = 0:3
Wnr_factor = cos(pi/4*r) - j*sin(пи/4*r) ;
Wnr_integer = floor(Wnr_factor * 2^13) ;
if (real(Wnr_integer)<0)
Wnr_real = real(Wnr_integer) + 2^16 ; %Дополнительный код отрицательных чисел
else
Wnr_real = real(Wnr_integer) ;
end
if (imag(Wnr_integer)<0)
Wnr_imag = imag(Wnr_integer) + 2^16 ;
else
Wnr_imag = imag(Wnr_integer);
end
Wnr(2*r+1,:) = dec2hex(Wnr_real) %Действительная часть
Wnr(2*r+2,:) = dec2hex(Wnr_imag) %Мнимая часть
end
Сравнение результатов БПФ
Моделирование в MATLAB процесса БПФ, реализованного на Verilog, выглядит следующим образом, и оно также включает сравнение двух результатов БПФ.
Пример
%=======================================================
% 8-точечное БПФ
%=======================================================
for r=0:3
Wnr(r+1) = cos(pi/4*r) - j*sin(пи/4*r) ;
end
x = [10, 20, 30, 40, 10, 20 ,30 ,40];
шаг = [1+2j, 1+5j, 31+3j, 1+6j, 23+4j, 1+8j, 6+11j, 1+7j];
x2 = x + шаг;
xm0 = [x2(0+1), x2(4+1), x2(2+1), x2(6+1), x2(1+1), x2(5+1), x2(3+1), x2(7+1)] ;
%% stage1
xm1(1) = xm0(1) + xm0(2)*Wnr(1) ;
xm1(2) = xm0(1) - xm0(2)*Wnr(1) ;
xm1(3) = xm0(3) + xm0(4)*Wnr(1) ;
xm1(4) = xm0(3) - xm0(4)*Wnr(1) ;
xm1(5) = xm0(5) + xm0(6)*Wnr(1) ;
xm1(6) = xm0(5) - xm0(6)*Wnr(1) ;
xm1(7) = xm0(7) + xm0(8)*Wnr(1) ;
xm1(8) = xm0(7) - xm0(8)*Wnr(1) ;
floor(xm1(:))
%% stage2
xm2(1) = xm1(1) + xm1(3)*Wnr(1) ;
xm2(3) = xm1(1) - xm1(3)*Wnr(1) ;
xm2(2) = xm1(2) + xm1(4)*Wnr(2) ;
xm2(4) = xm1(2) - xm1(4)*Wnr(2) ;
xm2(5) = xm1(5) + xm1(7)*Wnr(1) ;
xm2(7) = xm1(5) - xm1(7)*Wnr(1) ;
xm2(6) = xm1(6) + xm1(8)*Wnr(2) ;
xm2(8) = xm1(6) - xm1(8)*Wnr(2) ;
floor(xm2(:))
%% stage3
xm3(1) = xm2(1) + xm2(5)*Wnr(1) ;
xm3(5) = xm2(1) - xm2(5)*Wnr(1) ;
xm3(2) = xm2(2) + xm2(6)*Wnr(2) ;
xm3(6) = xm2(2) - xm2(6)*Wnr(2) ;
xm3(3) = xm2(3) + xm2(7)*Wnr(3) ;
xm3(7) = xm2(3) - xm2(7)*Wnr(3) ;
xm3(4) = xm2(4) + xm2(8)*Wnr(4) ;
xm3(8) = xm2(4) - xm2(8)*Wnr(4) ;
floor(xm3(:))
%% fft
fft1 = fft(x)
fft2 = fft(x2)
plot(1:8, abs(fft2))
hold on
plot(1:8, abs(xm3), 'r')
Скачать исходный код
Скачать