キーワード:パイプライン,乗算器
ハードウェア記述言語の顕著な利点は、命令実行の並列性である。複数のステートメントが同じクロック周期内で複数の信号データを並列に処理できる。
しかし、データがシリアル入力される場合、命令実行の並列性はその利点を発揮できない。また、多くの場合、一部の計算は1つまたは2つのクロック周期内で完了できない。もしシリアル入力されるデータが毎回、前回の計算が完了するのを待ってから次の計算を開始しなければならないなら、効率はかなり低い。パイプラインは、マルチサイクルにおけるシリアルデータ計算の効率低下の問題を解決するものである。
パイプライン
パイプラインの基本的な考え方は、反復的なプロセスを複数のサブプロセスに分解し、各サブプロセスを専用の機能ユニットで実現するというものである。複数の処理プロセスを時間的にずらして、各機能段を順に通過させることで、各サブプロセスは他のサブプロセスと並行して実行できる。
あるコインランドリーで洗濯のプロセスが4つの段階に分かれているとしよう:衣類の受け取り、洗濯、乾燥、クローゼットへの収納。各段階に30分かかる場合、1回の洗濯には2時間かかる。
最悪のケースを考えると、コインランドリーには洗濯機が1台、乾燥機が1台、クローゼットが1つしかない。30分ごとに1バッチの洗濯物が届く場合、毎回前のバッチの洗濯が完了するまで2時間待つ必要がある。すると4バッチの洗濯物を洗い終えるのに必要な時間は8時間となる。
図は以下の通り:

このコインランドリーの設備をアップグレードし、合計4セットの洗濯設備を導入し、スタッフも4人に増やし、各人が1つの洗濯段階を担当する。これにより、各バッチの衣類は、同じ担当者によってタイムリーに異なる洗濯機に入れられる。時間的にずれているため、各バッチの衣類は、同じ担当者によって異なる設備と時間帯(30分)で洗濯・乾燥・収納が行われる。図は以下の通り。

わかるように、4バッチの衣類を洗い終えるのにわずか3時間半しかかからず、効率が明らかに向上する。
実際、2時間後には最初の洗濯設備が洗濯プロセスを完了してアイドル状態になる。この時点で5バッチ目の衣類が届けられれば、最初の設備は再び作業を開始できる。同様に、衣類のバッチが絶えず投入される限り、4台の洗濯設備はすべての衣類の洗濯プロセスを途切れることなく完了できる。また、最初のバッチの洗濯に2時間かかる以外は、以降30分ごとに1バッチの洗濯が完了する。
衣類のバッチ数が多ければ多いほど、節約できる時間は顕著になる。Nバッチの衣類がある場合、必要な時間は(4+N)×30分である。
もちろん、アップグレード後の洗濯プロセスにも欠点がある。設備とスタッフの増加により投入コストが増加し、コインランドリー内の残りスペースも狭くなり、作業状態が忙しそうに見える。
洗濯プロセスと同様に、データ処理経路も生産ラインとみなすことができる。経路上の各デジタル処理ユニットは1つの段階とみなすことができ、遅延が発生する。
パイプライン設計とは、経路をシステム的に個々のデジタル処理ユニット(段階)に分割し、各処理ユニットの間にレジスタを挿入して中間段階のデータを一時保存するものである。分割されたユニットは段階ごとに並列に実行でき、相互に影響を与えない。したがって、最終的にパイプライン設計はデータのスループットを向上させることができ、すなわちデータの処理速度を向上させる。
パイプライン設計の欠点は、各処理段階で中間計算状態を保存するためのレジスタを追加する必要があり、また複数の命令が並列に実行されるため、消費電力の増加を招くことである。
次に、乗算器を設計し、パイプライン設計を採用するかどうかを比較する。
一般的な乗算器設計
はじめに
疑問に思う人もいるかもしれない、直接乗算記号を使うほうが*2つの数の乗算を完了するのがより速くて簡単ではないか?
もしこのような疑問があれば、ハードウェア記述言語に対する理解がまだ不足しているということだ。前述のように、Verilogはハードウェア回路を記述するものであり、直接乗算記号で乗算プロセスを実行すると、コンパイラはコンパイル時にこの乗算式をデフォルトの乗算器にマッピングするが、その構造は知ることができない。
例えば、FPGA設計では、IPコアを直接呼び出して高性能な乗算器を生成できる。ビット幅が小さい場合は1周期で結果を出力でき、ビット幅が大きい場合でもパイプライン出力が可能である。要件を満たせる前提下では、慎重に使用してもよい*あるいは直接IPを呼び出して乗算演算を完了してもよい。
しかし、乗算器IPにも多くの欠点がある。例えば、ビット幅の制限、未知のタイミングなどである。特に乗算記号を使用すると、デジタル設計の不確実性に大きな隠れたリスクをもたらすことになる。
多くの場合、定数との乗算はシフト加算の形式で実装される。例えば:
例
A = (A<<1) + A ; //A * 3 に相当
A = (A<<3) + (A<<2) + (A<<1) + A ; //A * 15 に相当
1つのシフトレジスタと1つの加算器で3倍の演算を実現できる。しかし15倍する場合は、3つのシフトレジスタと3つの加算器が必要となる(もちろん15倍はシフト減算の方法でも実現できる)。
デジタル回路は1周期内で複数の変数の同時加算演算を完了できないことがある。したがって、デジタル設計において最も安全な加算操作は、同時に2つのデータのみに対して加算演算を行うことであり、最も悪い設計は、同時に4つ以上のデータに対して加算演算を行うことである。
設計内に同時に4つのデータに対して加算演算を行う操作が含まれている場合、その部分の設計は危険を伴い、タイミング要件を満たさない可能性がある。
このような場合、設計パラメータが設定可能で、タイミングを制御できるパイプライン方式の乗算器が必要となる。
設計原理
10進数の乗算と同様に、13と5の乗算プロセスは以下の通りである:
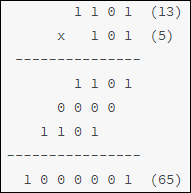
これにより、被乗数を乗数の対応するビットに従ってシフト加算すれば、乗算プロセスを完了できることがわかる。
各周期で1回の累加しか完了できないと仮定すると、1回の乗算計算に必要な最小クロック数はちょうど乗数のビット幅となる。したがって、ビット幅が狭い数を乗数にすることを推奨する。この場合、計算周期が短くなる。
乗算器設計
毎回の乗算演算が1つの結果しか出力できないことを考慮した(非パイプライン設計)、設計コードは以下の通りである。
例
#(parameter N=4,
parameter M=4)
(
input clk,
input rstn,
input data_rdy , //データ入力イネーブル
input [N-1:0] mult1, //被乗数
input [M-1:0] mult2, //乗数
output res_rdy , //データ出力イネーブル
output [N+M-1:0] res //乗算結果
);
//calculate counter
reg [31:0] cnt ;
//乗算周期カウンタ
wire [31:0] cnt_temp = (cnt == M)? 'b0 : cnt + 1'b1 ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
cnt <= 'b0 ;
end
else if (data_rdy) begin //データイネーブル時にカウント開始
cnt <= cnt_temp ;
end
else if (cnt != 0 ) begin //入力イネーブル端子の持続時間が短すぎるのを防ぐ
cnt <= cnt_temp ;
end
else begin
cnt <= 'b0 ;
end
end
//multiply
reg [M-1:0] mult2_shift ;
reg [M+N-1:0] mult1_shift ;
reg [M+N-1:0] mult1_acc ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
mult2_shift <= 'b0 ;
mult1_shift <= 'b0 ;
mult1_acc <= 'b0 ;
end
else if (data_rdy && cnt=='b0) begin //初期化
mult1_shift <= {{(N){1'b0}}, mult1} << 1 ;
mult2_shift <= mult2 >> 1 ;
mult1_acc <= mult2[0] ? {{(N){1'b0}}, mult1} : 'b0 ;
end
else if (cnt != M) begin
mult1_shift <= mult1_shift << 1 ; //被乗数を2倍
mult2_shift <= mult2_shift >> 1 ; //乗数を右シフトして判定しやすくする
//乗数の対応ビットが1かどうかを判定し、1なら累加
mult1_acc <= mult2_shift[0] ? mult1_acc + mult1_shift : mult1_acc ;
end
else begin
mult2_shift <= 'b0 ;
mult1_shift <= 'b0 ;
mult1_acc <= 'b0 ;
end
end
//results
reg [M+N-1:0] res_r ;
reg res_rdy_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
res_r <= 'b0 ;
res_rdy_r <= 'b0 ;
end
else if (cnt == M) begin
res_r <= mult1_acc ; //乗算周期終了時に結果を出力
res_rdy_r <= 1'b1 ;
end
else begin
res_r <= 'b0 ;
res_rdy_r <= 'b0 ;
end
end
assign res_rdy = res_rdy_r;
assign res = res_r;
endmodule
testbench
例
module test ;
parameter N = 8 ;
parameter M = 4 ;
reg clk, rstn;
//clock
always begin
clk = 0 ; #5 ;
clk = 1 ; #5 ;
end
//reset
initial begin
rstn = 1'b0 ;
#8 ; rstn = 1'b1 ;
end
//no pipeline
reg data_rdy_low ;
reg [N-1:0] mult1_low ;
reg [M-1:0] mult2_low ;
wire [M+N-1:0] res_low ;
wire res_rdy_low ;
//タスクを使用した周期激励
task mult_data_in ;
input [M+N-1:0] mult1_task, mult2_task ;
begin
wait(!test.u_mult_low.res_rdy) ; //not output state
@(negedge clk ) ;
data_rdy_low = 1'b1 ;
mult1_low = mult1_task ;
mult2_low = mult2_task ;
@(negedge clk ) ;
data_rdy_low = 1'b0 ;
wait(test.u_mult_low.res_rdy) ; //test the output state
end
endtask
//driver
initial begin
#55 ;
mult_data_in(25, 5 ) ;
mult_data_in(16, 10 ) ;
mult_data_in(10, 4 ) ;
mult_data_in(15, 7) ;
mult_data_in(215, 9) ;
end
mult_low #(.N(N), .M(M))
u_mult_low
(
.clk (clk),
.rstn (rstn),
.data_rdy (data_rdy_low),
.mult1 (mult1_low),
.mult2 (mult2_low),
.res_rdy (res_rdy_low),
.res (res_low));
//simulation finish
initial begin
forever begin
#100;
if ($time >= 10000) $finish ;
end
end
endmodule // test
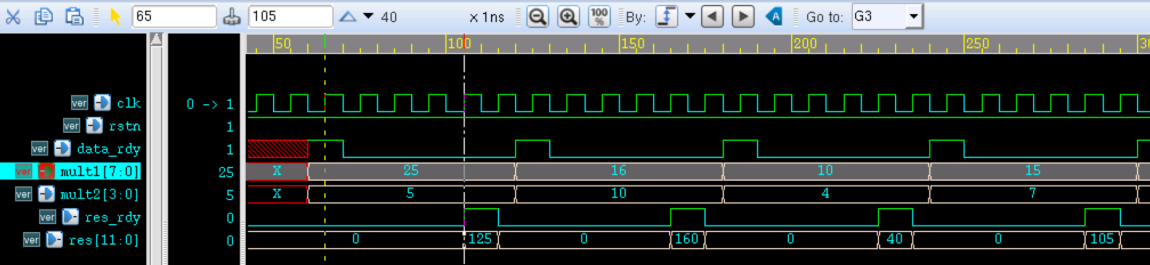
シミュレーション結果は以下の通りである。
図からわかるように、入力された2つのデータは4周期の遅延後に正しい乗算結果を得た。途中でのデータ入力の遅延時間も含めると、4回の乗算計算には約20クロック周期が必要である。
パイプライン乗算器設計
次に、乗算実行プロセスの途中状態を保存してパイプライン動作を可能にする。設計コードは以下の通りである。
単一累加計算プロセスのコードファイルは以下の通りである(mult_cell.v):
例
#(parameter N=4,
parameter M=4)
(
input clk,
input rstn,
input en,
input [M+N-1:0] mult1, //被乗数
input [M-1:0] mult2, //乗数
input [M+N-1:0] mult1_acci, //前回の累加結果
output reg [M+N-1:0] mult1_o, //被乗数のシフト後の保存値
output reg [M-1:0] mult2_shift, //乗数のシフト後の保存値
output reg [N+M-1:0] mult1_acco, //現在の累積結果
output reg rdy );
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
rdy <= 'b0 ;
mult1_o <= 'b0 ;
mult1_acco <= 'b0 ;
mult2_shift <= 'b0 ;
end
else if (en) begin
rdy <= 1'b1 ;
mult2_shift <= mult2 >> 1 ;
mult1_o <= mult1 << 1 ;
if (mult2[0]) begin
//乗数の対応ビットが1なら累加
mult1_acco <= mult1_acci + mult1 ;
end
else begin
mult1_acco <= mult1_acci ; //乗数の対応ビットが1なら保持
end
end
else begin
rdy <= 'b0 ;
mult1_o <= 'b0 ;
mult1_acco <= 'b0 ;
mult2_shift <= 'b0 ;
end
end
endmodule
トップレベルのインスタンス化
モジュールの複数回のインスタンス化により複数回の累加を実現する。コードファイルは以下の通りである(mult_man.v):
例
#(parameter N=4,
parameter M=4)
(
input clk,
input rstn,
input data_rdy ,
input [N-1:0] mult1,
input [M-1:0] mult2,
output res_rdy ,
output [N+M-1:0] res );
wire [N+M-1:0] mult1_t [M-1:0] ;
wire [M-1:0] mult2_t [M-1:0] ;
wire [N+M-1:0] mult1_acc_t [M-1:0] ;
wire [M-1:0] rdy_t ;
//最初のインスタンス化は初期化に相当するため、generate文は使用できない
mult_cell #(.N(N), .M(M))
u_mult_step0
(
.clk (clk),
.rstn (rstn),
.en (data_rdy),
.mult1 ({{(M){1'b0}}, mult1}),
.mult2 (mult2),
.mult1_acci ({(N+M){1'b0}}),
//output
.mult1_acco (mult1_acc_t[0]),
.mult2_shift (mult2_t[0]),
.mult1_o (mult1_t[0]),
.rdy (rdy_t[0]) );
//モジュールの複数回のインスタンス化には、generate文を使用する
genvar i ;
generate
for(i=1; i<=M-1; i=i+1) begin: mult_stepx
mult_cell #(.N(N), .M(M))
u_mult_step
(
.clk (clk),
.rstn (rstn),
.en (rdy_t[i-1]),
.mult1 (mult1_t[i-1]),
.mult2 (mult2_t[i-1]),
//前回の累加結果を次の累加の入力とする
.mult1_acci (mult1_acc_t[i-1]),
//output
.mult1_acco (mult1_acc_t[i]),
.mult1_o (mult1_t[i]), //被乗数のシフト状態を伝達
.mult2_shift (mult2_t[i]), //乗数のシフト状態を伝達
.rdy (rdy_t[i]) );
end
endgenerate
assign res_rdy = rdy_t[M-1];
assign res = mult1_acc_t[M-1];
endmodule
testbench
以下のシミュレーション記述を非パイプライン乗算器設計例のテストベンチに追加すると、パイプライン式乗算演算のシミュレーション結果を得ることができる。
2チャネルのデータは途切れのないシリアル入力であり、自動検証モジュールを備えているため、乗算演算結果の正しさを自動的に判定できる。
例
reg [N-1:0] mult1 ;
reg [M-1:0] mult2 ;
wire res_rdy ;
wire [N+M-1:0] res ;
//driver
initial begin
#55 ;
@(negedge clk ) ;
data_rdy = 1'b1 ;
mult1 = 25; mult2 = 5;
#10 ; mult1 = 16; mult2 = 10;
#10 ; mult1 = 10; mult2 = 4;
#10 ; mult1 = 15; mult2 = 7;
mult2 = 7; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 1; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 15; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 3; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 11; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 4; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 9; repeat(32) #10 mult1 = mult1 + 1 ;
end
//入力データをシフトして、後続の検証を容易にする
reg [N-1:0] mult1_ref [M-1:0];
reg [M-1:0] mult2_ref [M-1:0];
always @(posedge clk) begin
mult1_ref[0] <= mult1 ;
mult2_ref[0] <= mult2 ;
end
genvar i ;
generate
for(i=1; i<=M-1; i=i+1) begin
always @(posedge clk) begin
mult1_ref[i] <= mult1_ref[i-1];
mult2_ref[i] <= mult2_ref[i-1];
end
end
endgenerate
//自動検証
reg error_flag ;
always @(posedge clk) begin
# 1 ;
if (mult1_ref[M-1] * mult2_ref[M-1] != res && res_rdy) begin
error_flag <= 1'b1 ;
end
else begin
error_flag <= 1'b0 ;
end
end
//module instantiation
mult_man #(.N(N), .M(M))
u_mult
(
.clk (clk),
.rstn (rstn),
.data_rdy (data_rdy),
.mult1 (mult1),
.mult2 (mult2),
.res_rdy (res_rdy),
.res (res));
シミュレーション結果
最初の数十クロック周期のシミュレーション結果は以下の通りである。
図からわかるように、シミュレーション結果の判定信号 error_flag は常に0であり、乗算設計が正しいことを示している。
データはクロック駆動で絶えずシリアル入力され、乗算出力結果は4クロック周期の遅延後、各クロックで遅延なく次々と出力され、パイプライン方式の動作を実現している。
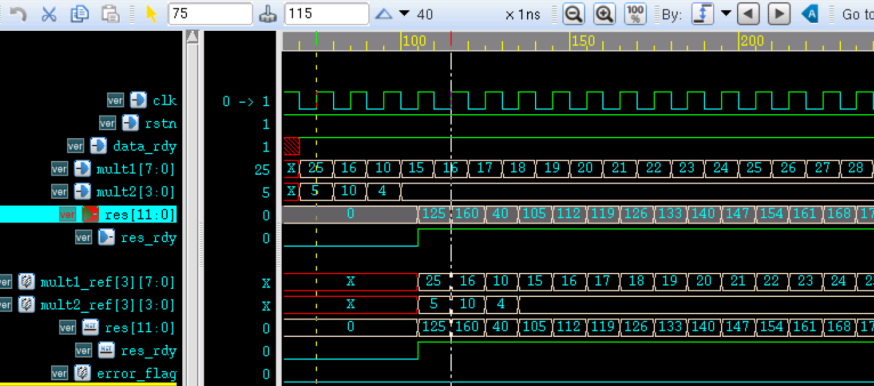
一般的にパイプラインを採用しない乗算器と比較して、乗算計算効率は大幅に改善された。
ただし、パイプライン式乗算器が使用するレジスタリソースは、以前のパイプライン非採用時の約4倍である。
したがって、デジタル設計においてパイプライン設計を採用するかどうかは、リソースと効率の両面から比較検討する必要があります。
ソースコードのダウンロード
Download