Palabras clave: pipeline, multiplicador
Una de las ventajas más destacadas de los lenguajes de descripción de hardware es el paralelismo en la ejecución de instrucciones. Múltiples sentencias pueden procesar simultáneamente múltiples señales de datos en el mismo ciclo de reloj.
Sin embargo, cuando los datos se ingresan en serie, el paralelismo en la ejecución de instrucciones no muestra su ventaja. Además, en muchos casos algunos cálculos no pueden completarse en uno o dos ciclos de reloj. Si cada dato de entrada en serie tiene que esperar a que finalice el cálculo anterior para poder iniciar el siguiente, la eficiencia es bastante baja. El pipeline es la solución al problema de la baja eficiencia del cálculo de datos en serie en múltiples ciclos.
Pipeline
La idea básica del pipeline es: descomponer un proceso repetitivo en varios subprocesos, cada uno implementado por un componente funcional dedicado. Al escalonar en el tiempo múltiples procesos de procesamiento y hacerlos pasar secuencialmente por las etapas funcionales, cada subproceso puede ejecutarse en paralelo con otros subprocesos.
Supongamos que el proceso de lavado de ropa en una lavandería se divide en 4 etapas: recoger la ropa, lavarla, secarla y guardarla en el armario. Cada etapa tarda media hora en completarse, por lo que lavar una vez la ropa toma 2 horas.
Considerando el peor caso, la lavandería solo tiene una lavadora, una secadora y un armario. Si cada media hora llega un lote de ropa para lavar, y cada vez hay que esperar 2 horas a que el lote anterior termine, entonces el tiempo necesario para lavar 4 lotes de ropa es de 8 horas.
El diagrama es el siguiente:

Al actualizar el equipo de esta lavandería, se introducen 4 conjuntos de equipos de lavado y el personal aumenta a 4 personas, cada una responsable de una etapa del lavado. Así, cada lote de ropa puede ser puesto a tiempo por la misma persona en diferentes lavadoras. Como los tiempos están escalonados, cada lote de ropa puede ser lavado, secado y guardado por la misma persona en diferentes equipos y periodos de tiempo (media hora). El diagrama es el siguiente.

Se puede observar que lavar 4 lotes de ropa solo toma 3 horas y media, la eficiencia mejora notablemente.
De hecho, después de 2 horas, el primer equipo de lavado ya ha completado el proceso de lavado y está inactivo. Si en ese momento llega el quinto lote de ropa, el primer equipo puede comenzar a trabajar de nuevo. Y así sucesivamente, mientras los lotes de ropa sigan entrando, los 4 equipos de lavado pueden completar sin interrupción el proceso de limpieza de toda la ropa. Además, excepto el primer lote que tarda 2 horas, a partir de entonces cada media hora se completará el lavado de un lote.
Cuantos más lotes de ropa haya, más evidente será el tiempo ahorrado. Si hay N lotes de ropa, el tiempo necesario es de (4+N) medias horas.
Por supuesto, el proceso de lavado actualizado también tiene desventajas. El aumento de equipos y personal incrementa el costo de inversión, reduce el espacio restante en la lavandería y hace que el estado de trabajo parezca más ocupado.
Similar al proceso de lavado de ropa, la ruta de procesamiento de datos también puede verse como una línea de producción. Cada unidad de procesamiento digital en la ruta puede considerarse una etapa, que introduce retraso.
El diseño con pipeline consiste en dividir sistemáticamente la ruta en unidades de procesamiento digital (etapas) e insertar registros entre las unidades para almacenar temporalmente los datos de las etapas intermedias. Las unidades divididas pueden ejecutarse en paralelo por etapas, sin influirse entre sí. Por lo tanto, el diseño con pipeline puede mejorar la tasa de transferencia de datos, es decir, aumentar la velocidad de procesamiento de los datos.
La desventaja del diseño con pipeline es que cada etapa de procesamiento requiere registros adicionales para guardar el estado de cálculo intermedio, y la ejecución paralela de múltiples instrucciones inevitablemente aumentará el consumo de potencia.
A continuación, diseñaremos un multiplicador y compararemos si se utiliza o no el diseño con pipeline.
Diseño de multiplicador general
Prefacio
Quizás alguien pregunte: ¿no es más rápido y simple usar directamente el signo de multiplicación*para completar la multiplicación de 2 números?
Si tienes esta duda, significa que tu comprensión de los lenguajes de descripción de hardware aún es insuficiente. Como se dijo antes, Verilog describe circuitos de hardware. Si usas directamente el signo de multiplicación para completar el proceso de multiplicación, el compilador también mapeará esta expresión de multiplicación a un multiplicador predeterminado al compilar, pero su estructura interna no se conoce.
Por ejemplo, en el diseño con FPGA, se puede llamar directamente al núcleo IP para generar un multiplicador de alto rendimiento. Cuando el ancho de bits es pequeño, el resultado puede obtenerse en un ciclo; cuando el ancho es mayor, también se puede generar en pipeline. Siempre que se cumplan los requisitos, se puede usar con precaución*o llamar directamente al IP para completar la operación de multiplicación.
Pero el multiplicador IP también tiene muchos defectos, como la limitación del ancho de bits, tiempos desconocidos, etc. Especialmente el uso del signo de multiplicación puede ocultar una gran incertidumbre en el diseño digital.
En muchas ocasiones, la multiplicación por constantes se implementa mediante desplazamiento y suma, por ejemplo:
Ejemplo
A = (A<<1) + A ; //Corresponde a A * 3
A = (A<<3) + (A<<2) + (A<<1) + A ; //Corresponde a A * 15
Con un registro de desplazamiento y un sumador se puede completar la operación de multiplicar por 3. Pero multiplicar por 15 requiere 3 registros de desplazamiento y 3 sumadores (por supuesto, multiplicar por 15 se puede hacer mediante desplazamiento y resta).
A veces, un circuito digital no puede completar la suma de múltiples variables simultáneamente en un solo ciclo. Por lo tanto, en el diseño digital, la operación de suma más segura es sumar solo 2 datos al mismo tiempo; el peor diseño es sumar 4 o más datos al mismo tiempo.
Si en el diseño hay una operación que suma 4 datos al mismo tiempo, esa parte del diseño será peligrosa y puede provocar que no se cumplan los tiempos.
En este caso, resulta necesario diseñar un multiplicador con pipeline de parámetros configurables y tiempos controlables.
Principio de diseño
Similar a la multiplicación decimal, el proceso de calcular 13 por 5 se muestra a continuación:
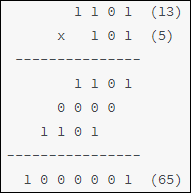
De esto se deduce que el multiplicando se desplaza y acumula según el bit correspondiente del multiplicador, completando así el proceso de multiplicación.
Suponiendo que solo se puede completar una acumulación por ciclo, el número mínimo de ciclos de reloj para un cálculo de multiplicación es exactamente el ancho de bits del multiplicador. Por lo tanto, se recomienda usar el número de ancho de bits menor como multiplicador, así el ciclo de cálculo es corto.
Diseño del multiplicador
Considerando que cada operación de multiplicación solo puede generar un resultado (diseño sin pipeline), el código de diseño es el siguiente.
Ejemplo
#(parameter N=4,
parameter M=4)
(
input clk,
input rstn,
input data_rdy , //Habilitación de entrada de datos
input [N-1:0] mult1, //Multiplicando
input [M-1:0] mult2, //Multiplicador
output res_rdy , //Habilitación de salida de datos
output [N+M-1:0] res //Resultado de la multiplicación
);
//calculate counter
reg [31:0] cnt ;
//Contador de ciclos de multiplicación
wire [31:0] cnt_temp = (cnt == M)? 'b0 : cnt + 1'b1 ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
cnt <= 'b0 ;
end
else if (data_rdy) begin //Comenzar a contar cuando la habilitación de datos esté activa
cnt <= cnt_temp ;
end
else if (cnt != 0 ) begin //Evitar que el terminal de habilitación de entrada dure demasiado poco
cnt <= cnt_temp ;
end
else begin
cnt <= 'b0 ;
end
end
//multiply
reg [M-1:0] mult2_shift ;
reg [M+N-1:0] mult1_shift ;
reg [M+N-1:0] mult1_acc ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
mult2_shift <= 'b0 ;
mult1_shift <= 'b0 ;
mult1_acc <= 'b0 ;
end
else if (data_rdy && cnt=='b0) begin //Inicialización
mult1_shift <= {{(N){1'b0}}, mult1} << 1 ;
mult2_shift <= mult2 >> 1 ;
mult1_acc <= mult2[0] ? {{(N){1'b0}}, mult1} : 'b0 ;
end
else if (cnt != M) begin
mult1_shift <= mult1_shift << 1 ; //Multiplicando multiplicado por 2
mult2_shift <= mult2_shift >> 1 ; //Desplazar el multiplicador a la derecha para facilitar la comprobación
//Comprobar si el bit correspondiente del multiplicador es 1; si es 1, acumular
mult1_acc <= mult2_shift[0] ? mult1_acc + mult1_shift : mult1_acc ;
end
else begin
mult2_shift <= 'b0 ;
mult1_shift <= 'b0 ;
mult1_acc <= 'b0 ;
end
end
//results
reg [M+N-1:0] res_r ;
reg res_rdy_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
res_r <= 'b0 ;
res_rdy_r <= 'b0 ;
end
else if (cnt == M) begin
res_r <= mult1_acc ; //Generar el resultado al final del ciclo de multiplicación
res_rdy_r <= 1'b1 ;
end
else begin
res_r <= 'b0 ;
res_rdy_r <= 'b0 ;
end
end
assign res_rdy = res_rdy_r;
assign res = res_r;
endmodule
testbench
Ejemplo
module test ;
parameter N = 8 ;
parameter M = 4 ;
reg clk, rstn;
//clock
always begin
clk = 0 ; #5 ;
clk = 1 ; #5 ;
end
//reset
initial begin
rstn = 1'b0 ;
#8 ; rstn = 1'b1 ;
end
//no pipeline
reg data_rdy_low ;
reg [N-1:0] mult1_low ;
reg [M-1:0] mult2_low ;
wire [M+N-1:0] res_low ;
wire res_rdy_low ;
//Usar estímulo periódico de tarea
task mult_data_in ;
input [M+N-1:0] mult1_task, mult2_task ;
begin
wait(!test.u_mult_low.res_rdy) ; //not output state
@(negedge clk ) ;
data_rdy_low = 1'b1 ;
mult1_low = mult1_task ;
mult2_low = mult2_task ;
@(negedge clk ) ;
data_rdy_low = 1'b0 ;
wait(test.u_mult_low.res_rdy) ; //test the output state
end
endtask
//driver
initial begin
#55 ;
mult_data_in(25, 5 ) ;
mult_data_in(16, 10 ) ;
mult_data_in(10, 4 ) ;
mult_data_in(15, 7) ;
mult_data_in(215, 9) ;
end
mult_low #(.N(N), .M(M))
u_mult_low
(
.clk (clk),
.rstn (rstn),
.data_rdy (data_rdy_low),
.mult1 (mult1_low),
.mult2 (mult2_low),
.res_rdy (res_rdy_low),
.res (res_low));
//simulation finish
initial begin
forever begin
#100;
if ($time >= 10000) $finish ;
end
end
endmodule // test
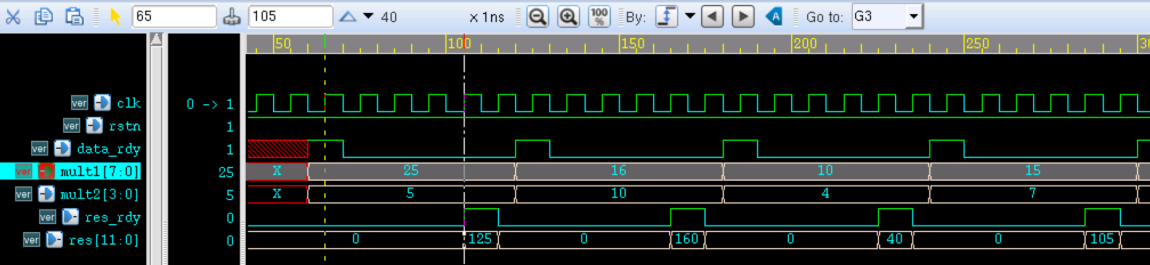
El resultado de la simulación es el siguiente.
Como se muestra en la figura, los 2 datos de entrada obtienen el resultado correcto de la multiplicación después de un retraso de 4 ciclos. Incluyendo el tiempo de retraso de los datos enviados en el medio, calcular 4 multiplicaciones requiere aproximadamente 20 ciclos de reloj.
Diseño de multiplicador con pipeline
A continuación se guardan los estados intermedios del proceso de multiplicación para permitir el trabajo en pipeline. El código de diseño es el siguiente.
El archivo de código para el proceso de cálculo de una sola acumulación es el siguiente (mult_cell.v):
Ejemplo
#(parameter N=4,
parameter M=4)
(
input clk,
input rstn,
input en,
input [M+N-1:0] mult1, //Multiplicando
input [M-1:0] mult2, //Multiplicador
input [M+N-1:0] mult1_acci, //Resultado de la acumulación anterior
output reg [M+N-1:0] mult1_o, //Valor guardado después de desplazar el multiplicando
output reg [M-1:0] mult2_shift, //Valor guardado después de desplazar el multiplicador
output reg [N+M-1:0] mult1_acco, //Resultado de la acumulación actual
output reg rdy );
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
rdy <= 'b0 ;
mult1_o <= 'b0 ;
mult1_acco <= 'b0 ;
mult2_shift <= 'b0 ;
end
else if (en) begin
rdy <= 1'b1 ;
mult2_shift <= mult2 >> 1 ;
mult1_o <= mult1 << 1 ;
if (mult2[0]) begin
//Si el bit correspondiente del multiplicador es 1, acumular
mult1_acco <= mult1_acci + mult1 ;
end
else begin
mult1_acco <= mult1_acci ; //Si el bit correspondiente del multiplicador es 1, mantener
end
end
else begin
rdy <= 'b0 ;
mult1_o <= 'b0 ;
mult1_acco <= 'b0 ;
mult2_shift <= 'b0 ;
end
end
endmodule
Instanciación de nivel superior
La instanciación múltiple de módulos completa múltiples acumulaciones. El archivo de código es el siguiente (mult_man.v):
Ejemplo
#(parameter N=4,
parameter M=4)
(
input clk,
input rstn,
input data_rdy ,
input [N-1:0] mult1,
input [M-1:0] mult2,
output res_rdy ,
output [N+M-1:0] res );
wire [N+M-1:0] mult1_t [M-1:0] ;
wire [M-1:0] mult2_t [M-1:0] ;
wire [N+M-1:0] mult1_acc_t [M-1:0] ;
wire [M-1:0] rdy_t ;
//La primera instanciación equivale a la inicialización, no se puede usar la sentencia generate
mult_cell #(.N(N), .M(M))
u_mult_step0
(
.clk (clk),
.rstn (rstn),
.en (data_rdy),
.mult1 ({{(M){1'b0}}, mult1}),
.mult2 (mult2),
.mult1_acci ({(N+M){1'b0}}),
//output
.mult1_acco (mult1_acc_t[0]),
.mult2_shift (mult2_t[0]),
.mult1_o (mult1_t[0]),
.rdy (rdy_t[0]) );
//Instanciación múltiple de módulos, usando sentencia generate
genvar i ;
generate
for(i=1; i<=M-1; i=i+1) begin: mult_stepx
mult_cell #(.N(N), .M(M))
u_mult_step
(
.clk (clk),
.rstn (rstn),
.en (rdy_t[i-1]),
.mult1 (mult1_t[i-1]),
.mult2 (mult2_t[i-1]),
//El resultado de la acumulación anterior se usa como entrada de la siguiente acumulación
.mult1_acci (mult1_acc_t[i-1]),
//output
.mult1_acco (mult1_acc_t[i]),
.mult1_o (mult1_t[i]), //Transferencia del estado de desplazamiento del multiplicando
.mult2_shift (mult2_t[i]), //Transferencia del estado de desplazamiento del multiplicador
.rdy (rdy_t[i]) );
end
endgenerate
assign res_rdy = rdy_t[M-1];
assign res = mult1_acc_t[M-1];
endmodule
testbench
Agregue la siguiente descripción de simulación al testbench del ejemplo de diseño de multiplicador sin pipeline para obtener el resultado de simulación de la multiplicación en pipeline.
Los 2 canales de datos son entrada en serie ininterrumpida y cuentan con un módulo de autoverificación que puede determinar automáticamente la corrección del resultado de la multiplicación.
Ejemplo
reg [N-1:0] mult1 ;
reg [M-1:0] mult2 ;
wire res_rdy ;
wire [N+M-1:0] res ;
//driver
initial begin
#55 ;
@(negedge clk ) ;
data_rdy = 1'b1 ;
mult1 = 25; mult2 = 5;
#10 ; mult1 = 16; mult2 = 10;
#10 ; mult1 = 10; mult2 = 4;
#10 ; mult1 = 15; mult2 = 7;
mult2 = 7; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 1; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 15; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 3; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 11; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 4; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 9; repeat(32) #10 mult1 = mult1 + 1 ;
end
//Desplazar los datos de entrada para facilitar la verificación posterior
reg [N-1:0] mult1_ref [M-1:0];
reg [M-1:0] mult2_ref [M-1:0];
always @(posedge clk) begin
mult1_ref[0] <= mult1 ;
mult2_ref[0] <= mult2 ;
end
genvar i ;
generate
for(i=1; i<=M-1; i=i+1) begin
always @(posedge clk) begin
mult1_ref[i] <= mult1_ref[i-1];
mult2_ref[i] <= mult2_ref[i-1];
end
end
endgenerate
//Autoverificación
reg error_flag ;
always @(posedge clk) begin
# 1 ;
if (mult1_ref[M-1] * mult2_ref[M-1] != res && res_rdy) begin
error_flag <= 1'b1 ;
end
else begin
error_flag <= 1'b0 ;
end
end
//module instantiation
mult_man #(.N(N), .M(M))
u_mult
(
.clk (clk),
.rstn (rstn),
.data_rdy (data_rdy),
.mult1 (mult1),
.mult2 (mult2),
.res_rdy (res_rdy),
.res (res));
Resultado de la simulación
El resultado de la simulación de las primeras decenas de ciclos de reloj es el siguiente.
Como se muestra en la figura, la señal de juicio error_flag del resultado de la simulación permanece en 0, lo que indica que el diseño de la multiplicación es correcto.
Los datos se ingresan en serie continuamente bajo el impulso del reloj. Después de un retraso de 4 ciclos de reloj, los resultados de la multiplicación también se generan sin retraso en cada ciclo de reloj, completando el trabajo en pipeline.
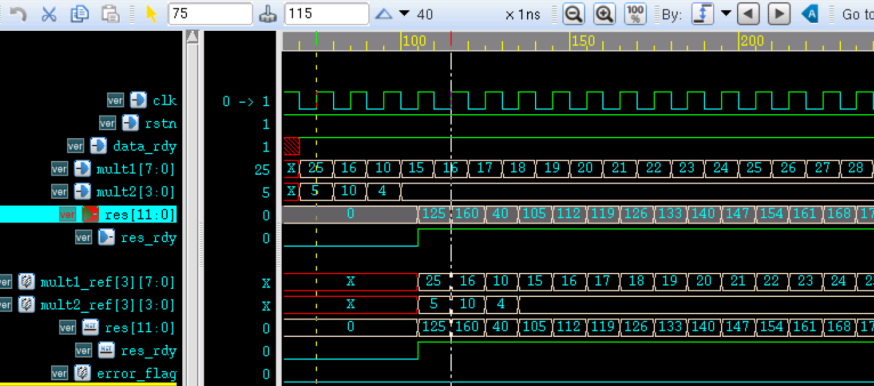
En comparación con el multiplicador que generalmente no usa pipeline, la eficiencia del cálculo de multiplicación ha mejorado enormemente.
Sin embargo, los recursos de registros utilizados por el multiplicador con pipeline son aproximadamente 4 veces los del multiplicador sin pipeline anterior.
Por lo tanto, en un diseño digital, si se adopta o no un diseño de pipeline, se deben sopesar tanto los recursos como la eficiencia.
Descarga del código fuente
Download