FFT(Fast Fourier Transform、高速フーリエ変換)は、DFT(離散フーリエ変換)の効率的なアルゴリズムです。時間周波数変換解析を基礎とするデジタル処理方法において、代替不可能な役割を果たします。
FFT の原理
公式の導出
DFT の演算公式は次のとおりです:
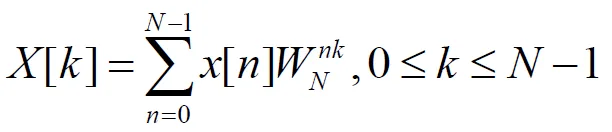
ただし、
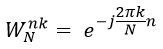
離散フーリエ変換の公式を奇数項と偶数項に分解すると、前半の N/2 個の点は次のように表せます:
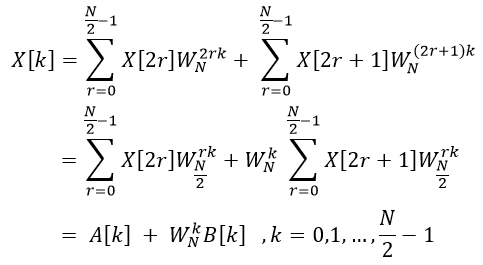
同様に、後半の N/2 個の点は次のように表せます:
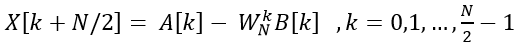
このことから、後半の N/2 個の点の値は、前半の N/2 個の点を計算する際の中間過程の値によって完全に決定できることがわかります。A[k] と B[k] に対してさらに奇数・偶数分解を、2 点の DFT になるまで繰り返すことで、多くの重複計算を避けることができ、高速離散フーリエ変換(FFT)のプロセスが実現されます。
アルゴリズム構造
8 点 FFT 計算の構造概略図は次のとおりです。
図からわかるように、数回の乗算と加算を簡単に計算するだけで離散フーリエ変換のプロセスを完了でき、各データに対して煩雑な乗算と累積を行う必要はありません。

重要な特性
(1) 段の概念
1 回分割するごとに、1 段の演算と呼びます。
FFT の演算点数を N とし、全体で M 段の演算があるとすると、次の関係が成り立ちます:
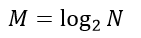
各段の演算の識別子は m = 0, 1, 2, ..., M-1 です。
分割計算を容易にするため、FFT の点数 N はしばしば 2 の整数乗の値が使われます。
(2) バタフライ演算ユニット
FFT の計算構造は複数のバタフライ演算ユニットから構成され、各演算ユニットの概略図は次のとおりです:
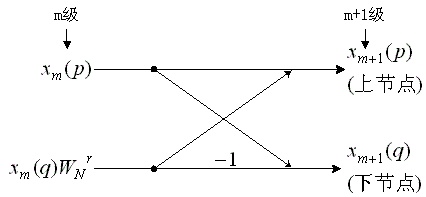
バタフライユニットの入力と出力は次を満たします:
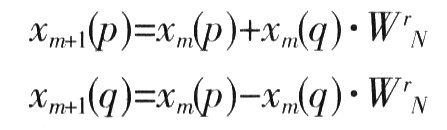
ただし、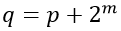
各バタフライユニットの演算では、1 回の乗算と 2 回の加算が行われます。
各段には N/2 個のバタフライユニットがあります。
したがって、1 回の FFT を完了するために必要な乗算回数と加算回数はそれぞれ次のとおりです:
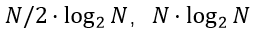
(3) グループの概念
各段の N/2 個のバタフライユニットは複数のグループに分けることができ、各グループは同じ構造と 回転因子の分布を持ちます。
例えば m=0 のときは、N/2=4 グループに分けられます。
m=1 のときは、N/4=2 グループに分けられます。
m=M-1 のときは、1 グループにしか分けられません。
(4) 回転因子の分布 回転因子は m 段に存在し、ここで
 。
8 点 FFT の第 2 段目の演算、すなわち m=1 では、バタフライ演算の回転因子は次のように簡略化できます:
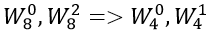
(5) ビット反転
N=8 点の FFT 計算では、X(0) ~ X(7) の位置に対応する 2 進コードは次のとおりです:
X(000), X(001), X(010), X(011), X(100), X(101), X(110), X(111)
その位置の 2 進コードを反転します:
X(000), X(100), X(010), X(110), X(001), X(101), X(011), X(111)
このとき位置に対応する 10 進数は次のとおりです:
X(0), X(4), X(2), X(6), X(1), X(5), X(3), X(7)
これはちょうど FFT の第 1 段入力データの順序に対応します。
この特性は FFT のプログラミング実装に役立ちます。
FFT 設計
設計説明
シミュレーションで FFT の変換プロセスを簡単に説明するために、データ点数は小さい値の 8 とします。
データがシリアル入力の場合、まずバッファリングが必要なため、設計ではデータ入力方式をパラレルにします。
データ入力は実部と虚部の合計 2 部に分かれるため、計算結果も実部と虚部に分かれます。
設計はパイプライン構造を採用し、当面はリソース消費の問題は考慮しません。
設計構造をより簡単にするために、ここでは妥協として、乗算計算は直接乗算記号を使用します。FFT 設計を実際に応用する場合は、必ず乗算構造をパイプライン化可能な乗算器に置き換えるか、公式が提供する効率の高い乗算器 IP を使用してください。
バタフライ演算ユニットの設計
バタフライ演算ユニットは固定小数点数演算のため、回転因子を固定小数点数に量子化する必要があります。
matlab を用いて回転因子を 8192 倍(13 ビット左シフト)に拡大します。付録を参照してください。
バタフライ演算における乗算と加算によってビット幅が段階的に増大するのを防ぐため、各段の演算完了後に、出力データに対して固定ビット幅の切り詰め(ビット切り捨て)を行います。これにより、回転因子の倍数拡大による影響も取り除くことができます。コードは次のとおりです:
例
/**************** butter unit *************************
Xm(p) ------------------------> Xm+1(p)
- ->
- -
-
- -
- ->
Xm(q) ------------------------> Xm+1(q)
Wn -1
*//////////////////////////////////////////////////////
module butterfly
(
input clk,
input rstn,
input en,
input signed [23:0] xp_real, // Xm(p)
input signed [23:0] xp_imag,
input signed [23:0] xq_real, // Xm(q)
input signed [23:0] xq_imag,
input signed [15:0] factor_real, // Wnr
input signed [15:0] factor_imag,
output valid,
output signed [23:0] yp_real, //Xm+1(p)
output signed [23:0] yp_imag,
output signed [23:0] yq_real, //Xm+1(q)
output signed [23:0] yq_imag);
reg [4:0] en_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
en_r <= 'b0 ;
end
else begin
en_r <= {en_r[3:0], en} ;
end
end
//=====================================================//
//(1.0) Xm(q) mutiply and Xm(p) delay
reg signed [39:0] xq_wnr_real0;
reg signed [39:0] xq_wnr_real1;
reg signed [39:0] xq_wnr_imag0;
reg signed [39:0] xq_wnr_imag1;
reg signed [39:0] xp_real_d;
reg signed [39:0] xp_imag_d;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
xp_real_d <= 'b0;
xp_imag_d <= 'b0;
xq_wnr_real0 <= 'b0;
xq_wnr_real1 <= 'b0;
xq_wnr_imag0 <= 'b0;
xq_wnr_imag1 <= 'b0;
end
else if (en) begin
xq_wnr_real0 <= xq_real * factor_real;
xq_wnr_real1 <= xq_imag * factor_imag;
xq_wnr_imag0 <= xq_real * factor_imag;
xq_wnr_imag1 <= xq_imag * factor_real;
//expanding 8192 times as Wnr
xp_real_d <= {{4{xp_real[23]}}, xp_real[22:0], 13'b0};
xp_imag_d <= {{4{xp_imag[23]}}, xp_imag[22:0], 13'b0};
end
end
//(1.1) get Xm(q) mutiplied-results and Xm(p) delay again
reg signed [39:0] xp_real_d1;
reg signed [39:0] xp_imag_d1;
reg signed [39:0] xq_wnr_real;
reg signed [39:0] xq_wnr_imag;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
xp_real_d1 <= 'b0;
xp_imag_d1 <= 'b0;
xq_wnr_real <= 'b0 ;
xq_wnr_imag <= 'b0 ;
end
else if (en_r[0]) begin
xp_real_d1 <= xp_real_d;
xp_imag_d1 <= xp_imag_d;
// ビット幅の余裕をあらかじめ設定し、データのオーバーフローを防ぐ
xq_wnr_real <= xq_wnr_real0 - xq_wnr_real1 ;
xq_wnr_imag <= xq_wnr_imag0 + xq_wnr_imag1 ;
end
end
//======================================================//
//(2.0) butter results
reg signed [39:0] yp_real_r;
reg signed [39:0] yp_imag_r;
reg signed [39:0] yq_real_r;
reg signed [39:0] yq_imag_r;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
yp_real_r <= 'b0;
yp_imag_r <= 'b0;
yq_real_r <= 'b0;
yq_imag_r <= 'b0;
end
else if (en_r[1]) begin
yp_real_r <= xp_real_d1 + xq_wnr_real;
yp_imag_r <= xp_imag_d1 + xq_wnr_imag;
yq_real_r <= xp_real_d1 - xq_wnr_real;
yq_imag_r <= xp_imag_d1 - xq_wnr_imag;
end
end
//(3) discard the low 13bits because of Wnr
assign yp_real = {yp_real_r[39], yp_real_r[13+23:13]};
assign yp_imag = {yp_imag_r[39], yp_imag_r[13+23:13]};
assign yq_real = {yq_real_r[39], yq_real_r[13+23:13]};
assign yq_imag = {yq_imag_r[39], yq_imag_r[13+23:13]};
assign valid = en_r[2];
endmodule
トップレベルのインスタンス化
FFT アルゴリズム構造の概略図に従ってバタフライ演算ユニットをインスタンス化し、最終的な FFT 機能を完成させます。
各段のバタフライ演算ユニットの入力・出力の対応関係に基づいて、順に手動で 12 回インスタンス化することもできますし、generate を利用してインスタンス化することもできます。その場合、FFT における「グループ」と「段」の特徴をよく理解している必要があります:
-
(1) 8 点 FFT 設計では、3 段の演算が必要で、各段には 4 個のバタフライ演算ユニットがあり、各段のグループ数はそれぞれ 4、2、1 です。
-
(2) 各段のグループ内の 1 つのバタフライ演算ユニットにおける 2 つの入力ポートの距離は常に
 (m は段番号で、左シフト演算 1<<m に対応します)。グループ内の 2 つのバタフライ演算ユニットの最初の入力ポート間の距離は 1 です。
-
(3) 各段の隣接するグループ間における最初のバタフライ演算ユニットの最初の入力ポートの距離は
 (左シフト演算 2<<m に対応します)。
インスタンス化コードは次のとおりです。
ここで、行列信号 xm_real(xm_imag)の 1 次元・2 次元アドレスは、段とグループを表す識別子です。
信号ポート間の接続関係を判断する際に、一見複雑な判断ロジックと乗算記号を使用していますが、実際に最終的に生成される回路は、手動でコードを書いて 12 個のバタフライ演算ユニットをインスタンス化する方法と完全に同じです。generate 内の変数は実際の回路を生成するのを補助するだけで、関連する値の計算や判断はすべてコンパイル時に完了します。これらの変数は実際の回路を生成することはなく、より高速なモジュールのインスタンス化のための方法を提供するにすぎません。
例
module fft8 (
input clk,
input rstn,
input en,
input signed [23:0] x0_real,
input signed [23:0] x0_imag,
input signed [23:0] x1_real,
input signed [23:0] x1_imag,
input signed [23:0] x2_real,
input signed [23:0] x2_imag,
input signed [23:0] x3_real,
input signed [23:0] x3_imag,
input signed [23:0] x4_real,
input signed [23:0] x4_imag,
input signed [23:0] x5_real,
input signed [23:0] x5_imag,
input signed [23:0] x6_real,
input signed [23:0] x6_imag,
input signed [23:0] x7_real,
input signed [23:0] x7_imag,
output valid,
output signed [23:0] y0_real,
output signed [23:0] y0_imag,
output signed [23:0] y1_real,
output signed [23:0] y1_imag,
output signed [23:0] y2_real,
output signed [23:0] y2_imag,
output signed [23:0] y3_real,
output signed [23:0] y3_imag,
output signed [23:0] y4_real,
output signed [23:0] y4_imag,
output signed [23:0] y5_real,
output signed [23:0] y5_imag,
output signed [23:0] y6_real,
output signed [23:0] y6_imag,
output signed [23:0] y7_real,
output signed [23:0] y7_imag
);
//operating data
wire signed [23:0] xm_real [3:0] [7:0];
wire signed [23:0] xm_imag [3:0] [7:0];
wire en_connect [15:0] ;
assign en_connect[0] = en;
assign en_connect[1] = en;
assign en_connect[2] = en;
assign en_connect[3] = en;
//factor, multiplied by 0x2000
wire signed [15:0] factor_real [3:0] ;
wire signed [15:0] factor_imag [3:0];
assign factor_real[0] = 16'h2000; //1
assign factor_imag[0] = 16'h0000; //0
assign factor_real[1] = 16'h16a0; //sqrt(2)/2
assign factor_imag[1] = 16'he95f; //-sqrt(2)/2
assign factor_real[2] = 16'h0000; //0
assign factor_imag[2] = 16'he000; //-1
assign factor_real[3] = 16'he95f; //-sqrt(2)/2
assign factor_imag[3] = 16'he95f; //-sqrt(2)/2
// 入力初期化。ビット位置に関連する反転
assign xm_real[0][0] = x0_real;
assign xm_real[0][1] = x4_real;
assign xm_real[0][2] = x2_real;
assign xm_real[0][3] = x6_real;
assign xm_real[0][4] = x1_real;
assign xm_real[0][5] = x5_real;
assign xm_real[0][6] = x3_real;
assign xm_real[0][7] = x7_real;
assign xm_imag[0][0] = x0_imag;
assign xm_imag[0][1] = x4_imag;
assign xm_imag[0][2] = x2_imag;
assign xm_imag[0][3] = x6_imag;
assign xm_imag[0][4] = x1_imag;
assign xm_imag[0][5] = x5_imag;
assign xm_imag[0][6] = x3_imag;
assign xm_imag[0][7] = x7_imag;
//butter instantiaiton
//integer index[11:0] ;
genvar m, k;
generate
//3 stage
for(m=0; m<=2; m=m+1) begin: stage
for (k=0; k<=3; k=k+1) begin: unit
butterfly u_butter(
.clk (clk ) ,
.rstn (rstn ) ,
.en (en_connect[m*4 + k] ) ,
// グループ内かどうか? グループ番号+グループ内番号 : 次のグループ番号+新しいグループ内番号
.xp_real (xm_real[ m ] [k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))] ),
.xp_imag (xm_imag[ m ] [k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))] ),
.xq_real (xm_real[ m ] [(k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))) + (1<<m) ]), // バタフライ演算ユニットの 2 つの入力ポート間の距離を増やす
.xq_imag (xm_imag[ m ] [(k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))) + (1<<m) ]),
.factor_real(factor_real[k[m:0]<(1<<m)?
k[m:0] : k[m:0]-(1<<m) ]),
.factor_imag(factor_imag[k[m:0]<(1<<m)?
k[m:0] : k[m:0]-(1<<m) ]),
//output data
.valid (en_connect[ (m+1)*4 + k ] ),
.yp_real (xm_real[ m+1 ][k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))] ),
.yp_imag (xm_imag[ m+1 ][(k[m:0]) < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))] ),
.yq_real (xm_real[ m+1 ][(k[m:0] < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))) + (1<<m) ]),
.yq_imag (xm_imag[ m+1 ][((k[m:0]) < (1<<m) ?
(k[3:m] << (m+1)) + k[m:0] :
(k[3:m] << (m+1)) + (k[m:0]-(1<<m))) + (1<<m) ])
);
end
end
endgenerate
assign valid = en_connect[12];
assign y0_real = xm_real[3][0] ;
assign y0_imag = xm_imag[3][0] ;
assign y1_real = xm_real[3][1] ;
assign y1_imag = xm_imag[3][1] ;
assign y2_real = xm_real[3][2] ;
assign y2_imag = xm_imag[3][2] ;
assign y3_real = xm_real[3][3] ;
assign y3_imag = xm_imag[3][3] ;
assign y4_real = xm_real[3][4] ;
assign y4_imag = xm_imag[3][4] ;
assign y5_real = xm_real[3][5] ;
assign y5_imag = xm_imag[3][5] ;
assign y6_real = xm_real[3][6] ;
assign y6_imag = xm_imag[3][6] ;
assign y7_real = xm_real[3][7] ;
assign y7_imag = xm_imag[3][7] ;
endmodule
testbench
testbench は次のように作成します。主に 16 チャネルの実データ・複素データの連続入力に使用します。毎回の FFT は 8 点データのみのため、入力するデータは任意であり、正弦波などの規則的なデータではありません。
例
module test ;
reg clk;
reg rstn;
reg en ;
reg signed [23:0] x0_real;
reg signed [23:0] x0_imag;
reg signed [23:0] x1_real;
reg signed [23:0] x1_imag;
reg signed [23:0] x2_real;
reg signed [23:0] x2_imag;
reg signed [23:0] x3_real;
reg signed [23:0] x3_imag;
reg signed [23:0] x4_real;
reg signed [23:0] x4_imag;
reg signed [23:0] x5_real;
reg signed [23:0] x5_imag;
reg signed [23:0] x6_real;
reg signed [23:0] x6_imag;
reg signed [23:0] x7_real;
reg signed [23:0] x7_imag;
wire valid;
wire signed [23:0] y0_real;
wire signed [23:0] y0_imag;
wire signed [23:0] y1_real;
wire signed [23:0] y1_imag;
wire signed [23:0] y2_real;
wire signed [23:0] y2_imag;
wire signed [23:0] y3_real;
wire signed [23:0] y3_imag;
wire signed [23:0] y4_real;
wire signed [23:0] y4_imag;
wire signed [23:0] y5_real;
wire signed [23:0] y5_imag;
wire signed [23:0] y6_real;
wire signed [23:0] y6_imag;
wire signed [23:0] y7_real;
wire signed [23:0] y7_imag;
initial begin
clk = 0; //50MHz
rstn = 0 ;
#10 rstn = 1;
forever begin
#10 clk = ~clk; //50MHz
end
end
fft8 u_fft (
.clk (clk ),
.rstn (rstn ),
.en (en ),
.x0_real (x0_real),
.x0_imag (x0_imag),
.x1_real (x1_real),
.x1_imag (x1_imag),
.x2_real (x2_real),
.x2_imag (x2_imag),
.x3_real (x3_real),
.x3_imag (x3_imag),
.x4_real (x4_real),
.x4_imag (x4_imag),
.x5_real (x5_real),
.x5_imag (x5_imag),
.x6_real (x6_real),
.x6_imag (x6_imag),
.x7_real (x7_real),
.x7_imag (x7_imag),
.valid (valid),
.y0_real (y0_real),
.y0_imag (y0_imag),
.y1_real (y1_real),
.y1_imag (y1_imag),
.y2_real (y2_real),
.y2_imag (y2_imag),
.y3_real (y3_real),
.y3_imag (y3_imag),
.y4_real (y4_real),
.y4_imag (y4_imag),
.y5_real (y5_real),
.y5_imag (y5_imag),
.y6_real (y6_real),
.y6_imag (y6_imag),
.y7_real (y7_real),
.y7_imag (y7_imag));
//data input
initial begin
en = 0 ;
x0_real = 24'd10;
x1_real = 24'd20;
x2_real = 24'd30;
x3_real = 24'd40;
x4_real = 24'd10;
x5_real = 24'd20;
x6_real = 24'd30;
x7_real = 24'd40;
x0_imag = 24'd0;
x1_imag = 24'd0;
x2_imag = 24'd0;
x3_imag = 24'd0;
x4_imag = 24'd0;
x5_imag = 24'd0;
x6_imag = 24'd0;
x7_imag = 24'd0;
@(negedge clk) ;
en = 1 ;
forever begin
@(negedge clk) ;
x0_real = (x0_real > 22'h3F_ffff) ? 'b0 : x0_real + 1 ;
x1_real = (x1_real > 22'h3F_ffff) ? 'b0 : x1_real + 1 ;
x2_real = (x2_real > 22'h3F_ffff) ? 'b0 : x2_real + 31 ;
x3_real = (x3_real > 22'h3F_ffff) ? 'b0 : x3_real + 1 ;
x4_real = (x4_real > 22'h3F_ffff) ? 'b0 : x4_real + 23 ;
x5_real = (x5_real > 22'h3F_ffff) ? 'b0 : x5_real + 1 ;
x6_real = (x6_real > 22'h3F_ffff) ? 'b0 : x6_real + 6 ;
x7_real = (x7_real > 22'h3F_ffff) ? 'b0 : x7_real + 1 ;
x0_imag = (x0_imag > 22'h3F_ffff) ? 'b0 : x0_imag + 2 ;
x1_imag = (x1_imag > 22'h3F_ffff) ? 'b0 : x1_imag + 5 ;
x2_imag = (x2_imag > 22'h3F_ffff) ? 'b0 : x2_imag + 3 ;
x3_imag = (x3_imag > 22'h3F_ffff) ? 'b0 : x3_imag + 6 ;
x4_imag = (x4_imag > 22'h3F_ffff) ? 'b0 : x4_imag + 4 ;
x5_imag = (x5_imag > 22'h3F_ffff) ? 'b0 : x5_imag + 8 ;
x6_imag = (x6_imag > 22'h3F_ffff) ? 'b0 : x6_imag + 11 ;
x7_imag = (x7_imag > 22'h3F_ffff) ? 'b0 : x7_imag + 7 ;
end
end
//finish simulation
initial #1000 $finish ;
endmodule
シミュレーション結果
おおよそ、FFT 結果をパイプライン出力できることがわかります。
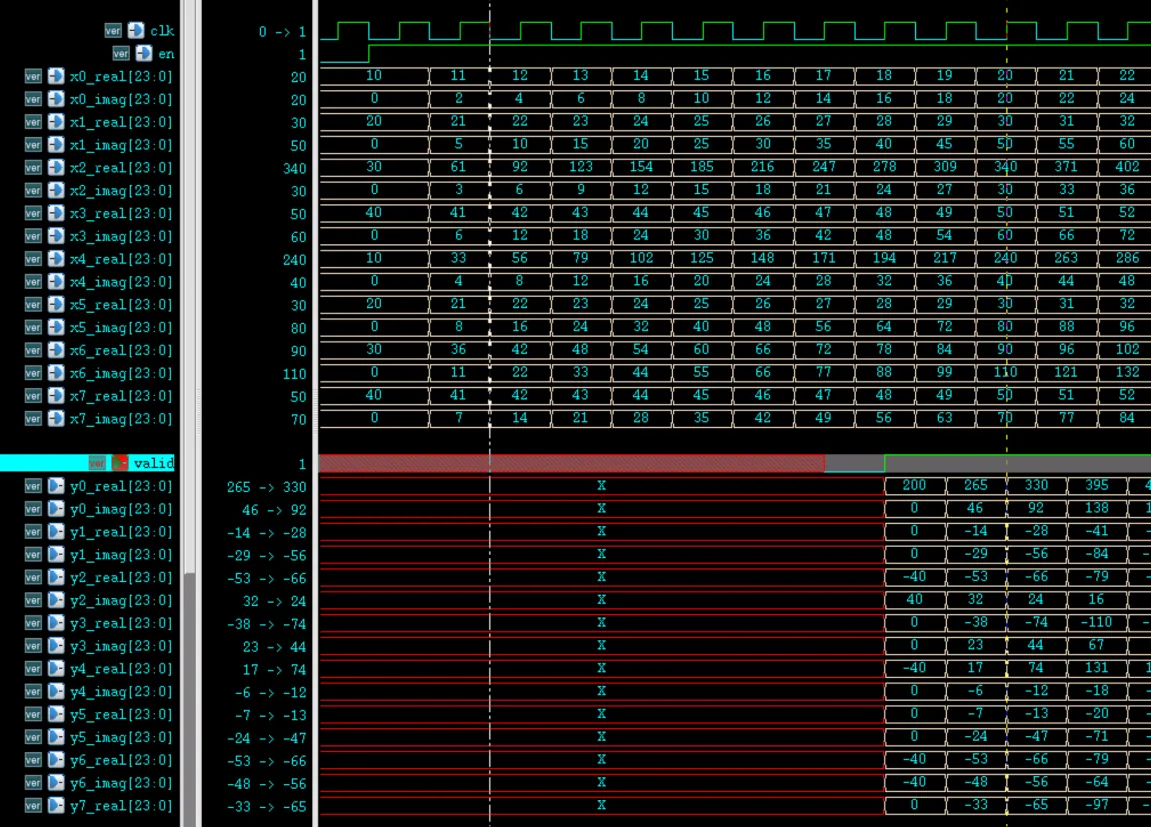
matlab 標準の FFT 関数を使用して同じデータを演算した場合の、最初の 2 グループのデータの FFT 結果は次のとおりです。
最初に入力したデータ信号が実部のみ有効な場合、FFT 結果は完全に一致することがわかります。
しかし、2 回目に入力したデータは虚部にも信号があるため、このとき両者の結果に誤差が生じ始め、場合によっては誤差が非常に大きくなります。
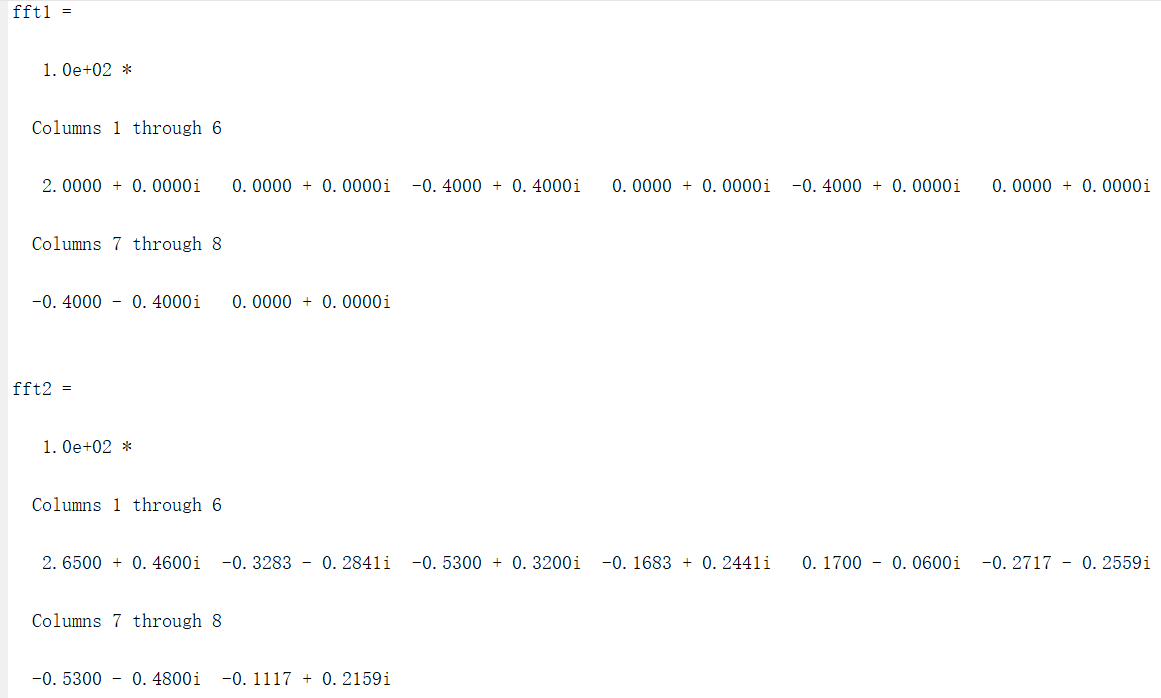
matlab で Verilog 実装の FFT プロセスをシミュレートしたところ、このプロセスの FFT 結果と Verilog 実装の FFT 結果はほぼ一致することがわかりました。
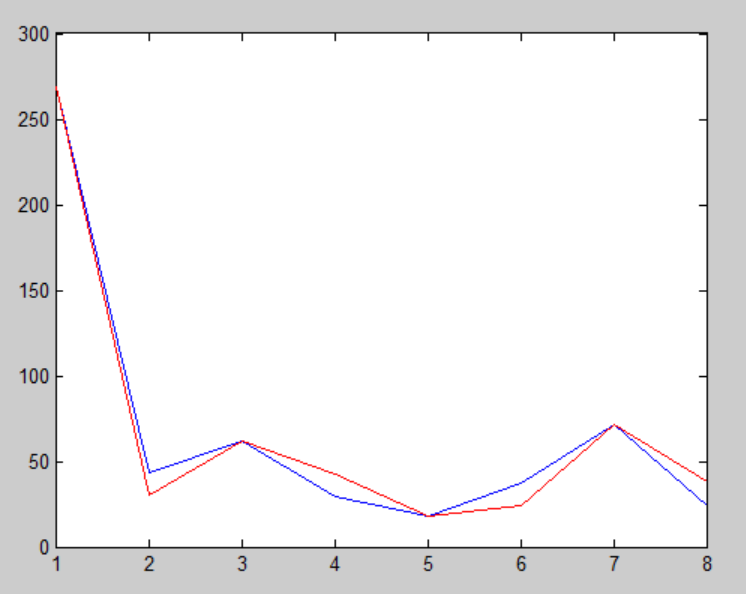
誤差のある 2 種類の FFT 結果の絶対値を取って比較した図は次のとおりです。
FFT 結果の傾向はおおよそ同じですが、一部の点で目に見える誤差があることがわかります。
設計のまとめ:
バタフライ演算ユニットの設計時に述べたように、回転因子を量子化する際、ビット幅の選択によって誤差が生じます。
さらに、各バタフライ演算ユニットの演算結果は切り詰められるため、これによっても誤差が生じます。
matlab で FFT を計算するときは精度の問題を考慮する必要がなく、その最高精度でデータに対して FFT 計算を行います。
以上のことから、最終的に 2 つの FFT 計算方法の結果に差異が生じます。
興味のある方は、回転因子と入力データのビット幅をさらに増やしたり、FFT の点数も増やしたりしてからシミュレーションで比較すると、相対誤差は小さくなるはずです。
付録:matlab の使用
回転因子の生成
8 点 FFT では 4 つの回転因子だけを使用します。回転因子の拡大倍率は 8192 です。
例
%=======================================================
% Wnr calcuting
%=======================================================
for r = 0:3
Wnr_factor = cos(pi/4*r) - j*sin(pi/4*r) ;
Wnr_integer = floor(Wnr_factor * 2^13) ;
if (real(Wnr_integer)<0)
Wnr_real = real(Wnr_integer) + 2^16 ; %負数の 2 の補数
else
Wnr_real = real(Wnr_integer) ;
end
if (imag(Wnr_integer)<0)
Wnr_imag = imag(Wnr_integer) + 2^16 ;
else
Wnr_imag = imag(Wnr_integer);
end
Wnr(2*r+1,:) = dec2hex(Wnr_real) %実部
Wnr(2*r+2,:) = dec2hex(Wnr_imag) %虚部
end
FFT 結果の比較
matlab で Verilog 実装の FFT プロセスをシミュレートしたものを以下に示します。2 種類の FFT 結果の比較も含まれます。
例
%=======================================================
% 8dots fft
%=======================================================
for r=0:3
Wnr(r+1) = cos(pi/4*r) - j*sin(pi/4*r) ;
end
x = [10, 20, 30, 40, 10, 20 ,30 ,40];
step = [1+2j, 1+5j, 31+3j, 1+6j, 23+4j, 1+8j, 6+11j, 1+7j];
x2 = x + step;
xm0 = [x2(0+1), x2(4+1), x2(2+1), x2(6+1), x2(1+1), x2(5+1), x2(3+1), x2(7+1)] ;
%% stage1
xm1(1) = xm0(1) + xm0(2)*Wnr(1) ;
xm1(2) = xm0(1) - xm0(2)*Wnr(1) ;
xm1(3) = xm0(3) + xm0(4)*Wnr(1) ;
xm1(4) = xm0(3) - xm0(4)*Wnr(1) ;
xm1(5) = xm0(5) + xm0(6)*Wnr(1) ;
xm1(6) = xm0(5) - xm0(6)*Wnr(1) ;
xm1(7) = xm0(7) + xm0(8)*Wnr(1) ;
xm1(8) = xm0(7) - xm0(8)*Wnr(1) ;
floor(xm1(:))
%% stage2
xm2(1) = xm1(1) + xm1(3)*Wnr(1) ;
xm2(3) = xm1(1) - xm1(3)*Wnr(1) ;
xm2(2) = xm1(2) + xm1(4)*Wnr(2) ;
xm2(4) = xm1(2) - xm1(4)*Wnr(2) ;
xm2(5) = xm1(5) + xm1(7)*Wnr(1) ;
xm2(7) = xm1(5) - xm1(7)*Wnr(1) ;
xm2(6) = xm1(6) + xm1(8)*Wnr(2) ;
xm2(8) = xm1(6) - xm1(8)*Wnr(2) ;
floor(xm2(:))
%% stage3
xm3(1) = xm2(1) + xm2(5)*Wnr(1) ;
xm3(5) = xm2(1) - xm2(5)*Wnr(1) ;
xm3(2) = xm2(2) + xm2(6)*Wnr(2) ;
xm3(6) = xm2(2) - xm2(6)*Wnr(2) ;
xm3(3) = xm2(3) + xm2(7)*Wnr(3) ;
xm3(7) = xm2(3) - xm2(7)*Wnr(3) ;
xm3(4) = xm2(4) + xm2(8)*Wnr(4) ;
xm3(8) = xm2(4) - xm2(8)*Wnr(4) ;
floor(xm3(:))
%% fft
fft1 = fft(x)
fft2 = fft(x2)
plot(1:8, abs(fft2))
hold on
plot(1:8, abs(xm3), 'r')
ソースコードのダウンロード
Download