除算器の原理(固定小数点)
10進数の除算と同様に、27 を 5 で割る計算過程は以下のようになります。
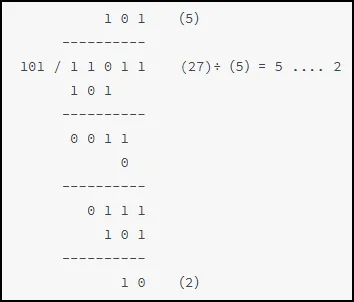
除算の計算手順は以下のとおりです。
- (1) 被除数の上位数ビットを取り出します。ビット幅は除数と同じにします(例では 3bit データ)。
- (2) 被除数の上位データと除数を比較し、前者が後者以上であれば、対応するビットの商は 1 となり、両者の差が最初の余りになります。そうでなければ、対応する商は 0 となり、前者をそのまま余りとします。
- (3) 前のステップの余りと、被除数の残りの最上位 1bit データを連結して新しいデータとし、除数と比較します。これにより新しい商と余りが得られます。
- (4) 被除数の最下位ビットまで計算に参加するまで、手順 (3) を繰り返します。
注意すべき点として、商のビット幅は被除数と同じにする必要があります。除数が 1 の可能性があるためです。したがって、上記の手計算による除算の例では、最初の比較の際に、数値 27 の最上位ビット 1 (3'b001) と 3'b101 を比較する必要があります。この計算手順に基づき、ビット幅が設定可能なパイプライン方式の除算器を設計します。パイプライン遅延サイクル数は被除数のビット幅と一致させます。
除算器の設計
単段演算の設計
単段除算計算では、単段の被除数ビット幅(信号 dividend)は、元の除数(信号 divisor)のビット幅より 1bit 多くする必要があります(オーバーフローを防ぐため)。
パイプライン処理を容易にするため、出力側には元の除数(信号 divisor および divisor_kp)と被除数情報(信号 dividend_ci および dividend_kp)を保持するレジスタが必要です。
単段の演算結果として、新しい 1bit の商データ(信号 merchant)と余り(信号 remainder)が得られます。
最終的な除算結果を得るために、新しい 1bit の商データ(信号 merchant)は、前のサイクルの商結果(merchant_ci)とシフト加算する必要があります。
単段演算ユニットの設計は次のとおりです(ファイル名 divider_cell.v):
例
module divider_cell
#(parameter N=5,
parameter M=3)
(
input clk,
input rstn,
input en,
input [M:0] dividend,
input [M-1:0] divisor,
input [N-M:0] merchant_ci , //前の段が出力する商
input [N-M-1:0] dividend_ci , //元の除数
output reg [N-M-1:0] dividend_kp, //元の被除数情報
output reg [M-1:0] divisor_kp, //元の除数情報
output reg rdy ,
output reg [N-M:0] merchant , //演算ユニットが出力する商
output reg [M-1:0] remainder //演算ユニットが出力する余り
);
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
rdy <= 'b0 ;
merchant <= 'b0 ;
remainder <= 'b0 ;
divisor_kp <= 'b0 ;
dividend_kp <= 'b0 ;
end
else if (en) begin
rdy <= 1'b1 ;
divisor_kp <= divisor ; //元の除数を保持
dividend_kp <= dividend_ci ; //元の被除数を伝播
if (dividend >= {1'b0, divisor}) begin
merchant <= (merchant_ci<<1) + 1'b1 ; //商は1
remainder <= dividend - {1'b0, divisor} ; //余りを求める
end
else begin
merchant <= merchant_ci<<1 ; //商は0
remainder <= dividend ; //余りはそのまま
end
end // if (en)
else begin
rdy <= 'b0 ;
merchant <= 'b0 ;
remainder <= 'b0 ;
divisor_kp <= 'b0 ;
dividend_kp <= 'b0 ;
end
end
endmodule
パイプライン段のインスタンス化
単段計算の余り(信号 remainder)と、元の被除数(信号 dividend)の対応するビットの 1bit データを再連結し、新しい単段被除数として次の段の単段除算演算ユニットに入力します。
その際、被除数、除数、および商のデータ情報も次の段の演算ユニットに渡す必要があります。
パイプライン段のモジュールをインスタンス化して除算を実現した設計は次のとおりです(ファイル名 divider_man.v):
例
//using 29/5=5...4
module divider_man
#(parameter N=5,
parameter M=3,
parameter N_ACT = M+N-1)
(
input clk,
input rstn,
input data_rdy , //データイネーブル
input [N-1:0] dividend, //被除数
input [M-1:0] divisor, //除数
output res_rdy ,
output [N_ACT-M:0] merchant , //商のビット幅:N
output [M-1:0] remainder ); //最終余り
wire [N_ACT-M-1:0] dividend_t [N_ACT-M:0] ;
wire [M-1:0] divisor_t [N_ACT-M:0] ;
wire [M-1:0] remainder_t [N_ACT-M:0];
wire [N_ACT-M:0] rdy_t ;
wire [N_ACT-M:0] merchant_t [N_ACT-M:0] ;
//最初の演算ユニットを初期化
divider_cell #(.N(N_ACT), .M(M))
u_divider_step0
( .clk (clk),
.rstn (rstn),
.en (data_rdy),
//被除数の最上位 1bit データを最初の単段演算の被除数として使用し、上位ビットは0で埋める
.dividend ({{(M){1'b0}}, dividend[N-1]}),
.divisor (divisor),
.merchant_ci ({(N_ACT-M+1){1'b0}}), //商の初期値は0
.dividend_ci (dividend[N_ACT-M-1:0]), //元の被除数
//output
.dividend_kp (dividend_t[N_ACT-M]), //元の被除数情報を伝播
.divisor_kp (divisor_t[N_ACT-M]), //元の除数情報を伝播
.rdy (rdy_t[N_ACT-M]),
.merchant (merchant_t[N_ACT-M]), //最初の商結果
.remainder (remainder_t[N_ACT-M]) //最初の余り
);
genvar i ;
generate
for(i=1; i<=N_ACT-M; i=i+1) begin: sqrt_stepx
divider_cell #(.N(N_ACT), .M(M))
u_divider_step
(.clk (clk),
.rstn (rstn),
.en (rdy_t[N_ACT-M-i+1]),
.dividend ({remainder_t[N_ACT-M-i+1], dividend_t[N_ACT-M-i+1][N_ACT-M-i]}), //余りと元の被除数の単一ビットデータを連結
.divisor (divisor_t[N_ACT-M-i+1]),
.merchant_ci (merchant_t[N_ACT-M-i+1]),
.dividend_ci (dividend_t[N_ACT-M-i+1]),
//output
.divisor_kp (divisor_t[N_ACT-M-i]),
.dividend_kp (dividend_t[N_ACT-M-i]),
.rdy (rdy_t[N_ACT-M-i]),
.merchant (merchant_t[N_ACT-M-i]),
.remainder (remainder_t[N_ACT-M-i])
);
end // block: sqrt_stepx
endgenerate
assign res_rdy = rdy_t[0];
assign merchant = merchant_t[0]; //最後の商結果を最終的な商とする
assign remainder = remainder_t[0]; //最後の余りを最終的な余りとする
endmodule
testbench
被除数ビット幅を 5、除数ビット幅を 3 とし、testbench に自己検証を追加した例は次のとおりです。
例
module test ;
parameter N = 5 ;
parameter M = 3 ;
reg clk;
reg rstn ;
reg data_rdy ;
reg [N-1:0] dividend ;
reg [M-1:0] divisor ;
wire res_rdy ;
wire [N-1:0] merchant ;
wire [M-1:0] remainder ;
//clock
always begin
clk = 0 ; #5 ;
clk = 1 ; #5 ;
end
//driver
initial begin
rstn = 1'b0 ;
#8 ;
rstn = 1'b1 ;
#55 ;
@(negedge clk ) ;
data_rdy = 1'b1 ;
dividend = 25; divisor = 5;
#10 ; dividend = 16; divisor = 3;
#10 ; dividend = 10; divisor = 4;
#10 ; dividend = 15; divisor = 1;
repeat(32) #10 dividend = dividend + 1 ;
divisor = 7;
repeat(32) #10 dividend = dividend + 1 ;
divisor = 5;
repeat(32) #10 dividend = dividend + 1 ;
divisor = 4;
repeat(32) #10 dividend = dividend + 1 ;
divisor = 6;
repeat(32) #10 dividend = dividend + 1 ;
end
//入力を遅延させ、データ結果と同一サイクルで比較して自己検証を行う
reg [N-1:0] dividend_ref [N-1:0];
reg [M-1:0] divisor_ref [N-1:0];
always @(posedge clk) begin
dividend_ref[0] <= dividend ;
divisor_ref[0] <= divisor ;
end
genvar i ;
generate
for(i=1; i<=N-1; i=i+1) begin
always @(posedge clk) begin
dividend_ref[i] <= dividend_ref[i-1];
divisor_ref[i] <= divisor_ref[i-1];
end
end
endgenerate
//自己検証
reg error_flag ;
always @(posedge clk) begin
# 1 ;
if (merchant * divisor_ref[N-1] + remainder != dividend_ref[N-1] && res_rdy) beginb //testbench では演算サイクルを考慮せずに乗算記号を直接使用できる
error_flag <= 1'b1 ;
end
else begin
error_flag <= 1'b0 ;
end
end
//module instantiation
divider_man #(.N(N), .M(M))
u_divider
(
.clk (clk),
.rstn (rstn),
.data_rdy (data_rdy),
.dividend (dividend),
.divisor (divisor),
.res_rdy (res_rdy),
.merchant (merchant),
.remainder (remainder));
//simulation finish
initial begin
forever begin
#100;
if ($time >= 10000) $finish ;
end
end
endmodule // test
シミュレーション結果
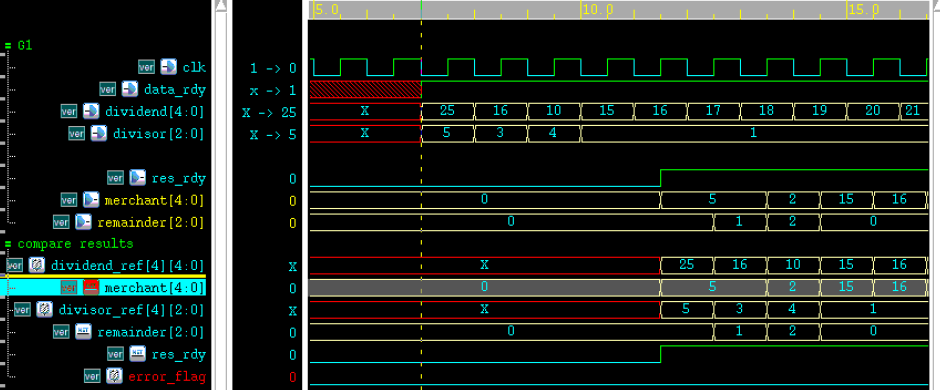
図からわかるように、2 つの入力データは被除数と同じビット幅のサイクル数だけ遅延した後に、正しい除算結果を出力しています。しかもパイプライン方式で遅延なく出力できるため、設計に適合しています。
ソースコードダウンロード
Download