Классификация текста
Классификация текста — одна из самых фундаментальных и важных задач в обработке естественного языка (NLP). Её цель — автоматически относить заданный текстовый документ к одной или нескольким предопределённым категориям.
Базовые понятия
Классификация текста похожа на библиотекаря, которому нужно классифицировать книги и расставить их по правильным полкам в зависимости от их содержания. В области вычислений нам нужно научить машины понимать содержание текста и принимать правильные решения о классификации.
Сценарии применения
Классификация текста имеет широкий спектр применений в современном обществе:
- Анализ тональности: определить, является ли отзыв положительным или отрицательным
- Фильтрация спама: отличать обычные письма от спама
- Классификация новостей: распределять новости по разделам, таким как спорт, финансы и технологии
- Распознавание намерений: Понимание истинного намерения запросов пользователей
- Медицинская диагностика: Классификация типов заболеваний по описаниям симптомов
Базовый рабочий процесс классификации текста
Полная система классификации текста обычно включает следующие этапы:
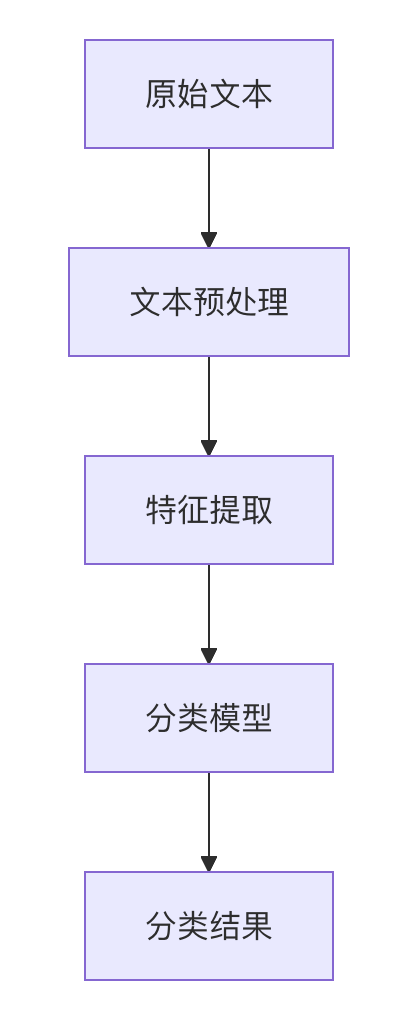
1. Предобработка текста
Предобработка текста преобразует необработанный текст в форму, подходящую для обработки моделями машинного обучения:
Пример
import nltk
from nltk.corpus import stopwords
from nltk.stem import PorterStemmer
def preprocess_text(text):
# Преобразовать в нижний регистр
text = text.lower()
# Удалить специальные символы и цифры
text = re.sub(r'[^a-zA-Z\s]', '', text)
# Токенизация
words = text.split()
# Удаление стоп-слов
stop_words = set(stopwords.words('english'))
words = [word for word in words if word not in stop_words]
# Стемминг
stemmer = PorterStemmer()
words = [stemmer.stem(word) for word in words]
return ' '.join(words)
2. Извлечение признаков
Преобразование текста в числовые представления признаков. Обычные методы включают:
| Метод | Описание | Преимущества | Недостатки |
|---|---|---|---|
| Мешок слов (BoW) | Подсчитывает частоту слов | Простой и интуитивно понятный | Игнорирует порядок слов и семантику |
| TF-IDF | Учитывает важность слов | Точнее, чем BoW | Всё ещё игнорирует контекст |
| Word2Vec | Векторные представления слов | Улавливает семантические связи | Не может обрабатывать многозначные слова |
| BERT | Контекстные эмбеддинги | Передовое представление | Высокие требования к вычислительным ресурсам |
3. Выбор модели классификации
Выберите подходящий алгоритм классификации на основе требований задачи и характеристик данных:
Традиционные методы машинного обучения:
- Наивный Байес
- Машина опорных векторов (SVM)
- Логистическая регрессия
- Случайный лес
Методы глубокого обучения:
- Свёрточная нейронная сеть (CNN)
- Рекуррентная нейронная сеть (RNN/LSTM)
- Модели Transformer (BERT и т. д.)
Практический пример: классификация новостей
Давайте на практическом примере продемонстрируем, как реализовать классификацию текста с помощью Python. Мы будем использовать набор данных 20 Newsgroups — классический набор данных для классификации новостей.
1. Подготовка данных
Пример
# Выберите 4 категории в качестве примера
categories = ['alt.atheism', 'soc.religion.christian', 'comp.graphics', 'sci.med']
# Загрузка обучающего и тестового наборов
newsgroups_train = fetch_20newsgroups(subset='train', categories=categories)
newsgroups_test = fetch_20newsgroups(subset='test', categories=categories)
print(f"Количество образцов в обучающем наборе: {len(newsgroups_train.data)}")
print(f"Количество образцов в тестовом наборе: {len(newsgroups_test.data)}")
2. Извлечение признаков (TF-IDF)
Пример
# Создание векторизатора TF-IDF
vectorizer = TfidfVectorizer(max_features=5000)
# Преобразование обучающего и тестового наборов
X_train = vectorizer.fit_transform(newsgroups_train.data)
X_test = vectorizer.transform(newsgroups_test.data)
y_train = newsgroups_train.target
y_test = newsgroups_test.target
3. Обучение модели (логистическая регрессия)
Пример
from sklearn.metrics import accuracy_score, classification_report
# Создание и обучение модели
model = LogisticRegression(max_iter=1000)
model.fit(X_train, y_train)
# Выполните прогноз на тестовом наборе
y_pred = model.predict(X_test)
# Оценка модели
print(f"Точность: {accuracy_score(y_test, y_pred):.2f}")
print("\nОтчёт о классификации:)
print(classification_report(y_test, y_pred, target_names=newsgroups_test.target_names))
4. Анализ результатов
Типичный вывод может выглядеть так:
准确率: 0.91

分类报告:
                        precision    recall  f1-score   support

           alt.atheism       0.90      0.87      0.89       319
soc.religion.christian       0.93      0.95      0.94       389
         comp.graphics       0.89      0.90      0.90       396
               sci.med       0.92      0.91      0.92       398

              accuracy                           0.91      1502
             macro avg       0.91      0.91      0.91      1502
          weighted avg       0.91      0.91      0.91      1502
Продвинутые методы и проблемы
Обработка дисбаланса классов
Когда в одних категориях образцов гораздо больше, чем в других, можно попробовать:
- Ресэмплирование (оверсэмплинг класса меньшинства или андерсэмплинг класса большинства)
- Использование весов классов
- Использование различных метрик оценки (например, F1-score вместо accuracy)
Методы повышения производительности модели
Инженерия признаков:
- Попробуйте разные диапазоны n-gram
- Добавление признаков частей речи
- Использование более совершенных эмбеддингов слов
Оптимизация модели:
- Настройка гиперпараметров
- Ансамблирование моделей
- Попробуйте модели глубокого обучения
Аугментация данных:
- Обратный перевод
- Замена синонимами
- Генеративно-состязательная сеть (GAN)
Распространённые проблемы
- Многометочная классификация: документ может принадлежать нескольким категориям
- Доменная адаптация: производительность модели снижается в новых доменах
- Обучение на малом числе примеров: ситуации с ограниченным объёмом размеченных данных
- Интерпретируемость: понимание того, почему модель принимает конкретное решение о классификации
Резюме и путь обучения
Классификация текста — фундаментальная задача NLP, и её освоение крайне важно для понимания более сложных приложений NLP. Рекомендуемый путь обучения:
- Начните с традиционных методов машинного обучения (таких как TF-IDF + SVM)
- Разберитесь в концепциях и применении векторных представлений слов (Word2Vec, GloVe)
- Изучите применение моделей глубокого обучения (CNN, LSTM) в классификации текста
- Исследуйте трансферное обучение с предварительно обученными языковыми моделями (BERT, GPT)
Благодаря постоянной практике и экспериментам с разными методами вы сможете создавать мощные и практичные системы классификации текста.
Другие расширения