Модели серии BERT
BERT (Bidirectional Encoder Representations from Transformers) — революционная модель обработки естественного языка, предложенная Google в 2018 году, которая полностью изменила парадигмы исследований и применения в области NLP.
В этой статье систематически представлены основные принципы BERT, методы обучения, техники тонкой настройки и основные варианты моделей.
Архитектура и обучение BERT
На рисунке ниже показаныBERT(Bidirectional Encoder Representations from Transformers)основная архитектура модели и задача маскированного языкового моделирования (Masked Language Modeling, MLM) во время предварительного обучения.
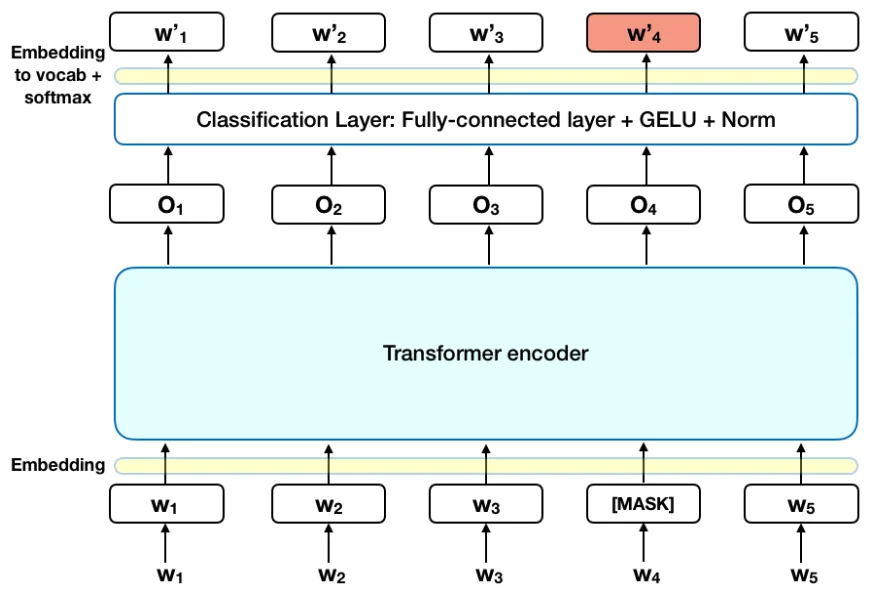
1. Входной слой (Embedding)
- Входная последовательность: текст, состоящий из слов (или подслов), например
[W₁, W₂, W₃, [MASK], W₅, W₆, W₇, W₂, W₃, W₄, W₅]。[MASK]это слово, случайно замаскированное BERT во время предварительного обучения (как в исходном тексте,W₄заменяется на[MASK])。
- Слой эмбеддингов: преобразует каждое слово в векторное представление фиксированной размерности (например, 768 измерений), включая:
- Эмбеддинги токенов: семантическая информация словаря.
- Позиционные эмбеддинги: информация о позиции слов в последовательности.
- Сегментные эмбеддинги: различают предложения (полезны для задач на пары предложений, явно не показаны на рисунке).
2. Энкодер Transformer
- Многослойные блоки Transformer: детали не раскрыты на рисунке, но каждый блок содержит:
- Механизм самовнимания: двунаправленно улавливает контекстные зависимости (ключевая особенность BERT).
- Сеть прямого распространения: нелинейное преобразование.
- Остаточные соединения и нормализация слоя: стабилизируют процесс обучения.
- Выход: векторное представление с учётом контекста, соответствующее каждому входному слову (например,
O₁, O₂, ..., O₅)。
3. Задача маскированного языкового моделирования (MLM)
- Цель: предсказать замаскированное слово
[MASK]соответствующее исходному слову (на рисункеW₄)。 - Слой классификации:
- Полносвязный слой: отображает выходной вектор Transformer (например,
O₄) к размерности, равной размеру словаря. - Функция активации GELU: Gaussian Error Linear Unit (нелинейная функция, используемая в BERT).
- Нормализация слоя (Norm): стандартизирует выход.
- Softmax: вычисляет вероятность каждого слова в словаре и выбирает слово с наибольшей вероятностью в качестве результата предсказания (например,
W'₁, W'₂, ..., W'₅является словом-кандидатом).
- Полносвязный слой: отображает выходной вектор Transformer (например,
Структура энкодера Transformer
BERT построен на основе энкодерной части Transformer, ядром которой является многослойный механизм самовнимания:
Пример
class TransformerEncoderLayer(nn.Module):
def __init__(self, d_model, nhead, dim_feedforward=2048):
super().__init__()
self.self_attn = MultiheadAttention(d_model, nhead)
self.linear1 = nn.Linear(d_model, dim_feedforward)
self.linear2 = nn.Linear(dim_feedforward, d_model)
self.norm1 = nn.LayerNorm(d_model)
self.norm2 = nn.LayerNorm(d_model)
def forward(self, src):
# Механизм самовнимания
src2 = self.self_attn(src, src, src)[0]
src = src + self.norm1(src2)
# Сеть прямого распространения
src2 = self.linear2(F.relu(self.linear1(src)))
src = src + self.norm2(src2)
return src
Ключевая инновация: двунаправленное моделирование контекста
В отличие от традиционных языковых моделей, BERT достигает двунаправленного понимания контекста с помощью следующих двух задач предварительного обучения:
- Маскированная языковая модель (MLM): случайным образом маскирует 15% входных токенов и предсказывает замаскированные слова
- Предсказание следующего предложения (NSP): определяет, следуют ли два предложения подряд
Параметры и конфигурация обучения
| Параметр | BERT-base | BERT-large |
|---|---|---|
| Количество слоёв | 12 | 24 |
| Размер скрытого слоя | 768 | 1024 |
| Количество голов внимания | 12 | 16 |
| Общее количество параметров | 110M | 340M |
Методы тонкой настройки BERT
Стандартный процесс тонкой настройки
- Добавление слоя адаптации для конкретной задачи: добавьте слой классификации/регрессии в соответствии с целевой задачей
- Настройка скорости обучения: обычно используют небольшую скорость обучения (2e-5 до 5e-5)
- Размер пакета: 16 или 32 — распространённый выбор
- Эпохи обучения: обычно достаточно 2-4 эпох
Эффективные методы тонкой настройки
Пример
from transformers import BertForSequenceClassification, Trainer
model = BertForSequenceClassification.from_pretrained('bert-base-uncased')
trainer = Trainer(
model=model,
args=training_args,
train_dataset=train_dataset,
eval_dataset=eval_dataset
)
trainer.train()
Сравнение распространённых стратегий тонкой настройки
| Метод | Преимущество | Недостаток |
|---|---|---|
| Полная тонкая настройка параметров | Лучшая производительность | Высокие вычислительные затраты |
| Извлечение признаков (заморозка BERT) | Вычислительно эффективный | Неоптимальная производительность |
| Adapter | Параметроэффективный | Требует изменения архитектуры |
| Промпт-обучение | Хорошая производительность в few-shot режиме | Требует разработки шаблонов промптов |
Основные варианты моделей BERT
RoBERTa (робастно оптимизированный BERT)
- Улучшения:
- Больший размер батча (8k vs 256)
- Более длительное время обучения
- Удаление задачи NSP
- Динамический шаблон маскирования
- Производительность: средний прирост 2-3% на бенчмарке GLUE
ALBERT (облегчённый BERT)
- Ключевые инновации:
- Разделение параметров (совместное использование параметров внимания между слоями)
- Факторизация эмбеддингов (разложение эмбеддинга слова на две небольшие матрицы)
- Эффект: количество параметров сокращено на 89%, скорость увеличена в 1.7 раза
Другие важные варианты
- DistilBERT: сжимает модель посредством дистилляции знаний
- ELECTRA: заменяет MLM на архитектуру генератор-дискриминатор
- SpanBERT: оптимизирует моделирование текстовых фрагментов
Китайские модели BERT
Обзор китайских предобученных моделей
| Модель | Организация | Особенности |
|---|---|---|
| BERT-wwm | Харбинский технологический институт | Маскирование целых слов |
| RoBERTa-wwm-ext | Харбинский технологический институт | Расширенные обучающие данные |
| ERNIE (Baidu) | Baidu | Включает графы знаний |
| NEZHA | Huawei | Относительное позиционное кодирование |
Пример использования китайского BERT
Пример
tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')
model = BertModel.from_pretrained('bert-base-chinese')
inputs = tokenizer("Обработка естественного языка очень интересна", return_tensors="pt")
outputs = model(**inputs)
Рекомендации по тонкой настройке для задач на китайском языке
- Использование версии Whole Word Masking (wwm) даёт лучшие результаты
- Обратите внимание на обработку проблем границ сегментации китайских слов
- Для специализированных областей рассмотрите доменно-адаптивное предобучение
Практические рекомендации и ресурсы
Дорожная карта обучения
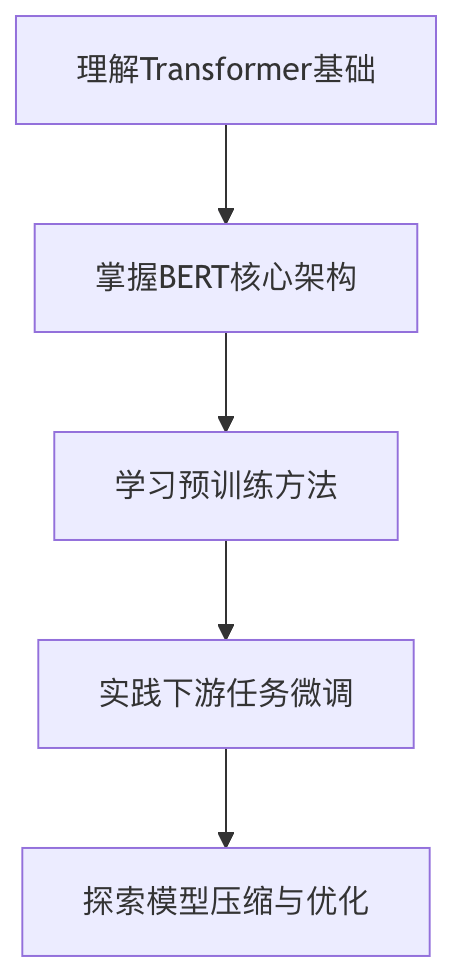
Рекомендуемые ресурсы
- Статьи:
- Оригинальная статья BERT (arXiv:1810.04805)
- Статьи о вариантах, таких как RoBERTa, ALBERT, и т. д.
- Репозитории с кодом:
- HuggingFace Transformers
- Реализация китайского BERT на GitHub
- Онлайн-курсы:
- Специализация Coursera по обработке естественного языка
- Курс глубокого обучения Хун-и Ли
Благодаря систематическому обучению и практике модели серии BERT могут стать мощным инструментом для решения задач NLP. Рекомендуется начать с базовой версии и постепенно переходить к более продвинутым вариантам и методам оптимизации.
Другие расширения