Мультимодальные предобученные модели
Мультимодальные предобученные модели — это модели глубокого обучения, которые могут одновременно обрабатывать и пониматьнесколько модальностей данных(таких как текст, изображения, аудио и т. д.). В отличие от традиционных унимодальных моделей, эти модели изучают связи и соответствия между различными модальностями посредством крупномасштабного предварительного обучения.
Ключевые преимущества мультимодального обучения
- Взаимодополняющая информация: Различные модальности могут предоставлять взаимодополняющую информацию (например, изображения предоставляют визуальную информацию, а текст — семантическую информацию)
- Повышенная устойчивость: Когда данные одной модальности отсутствуют или имеют низкое качество, другие модальности могут обеспечить поддержку
- Расширенные сценарии применения: Поддерживает более разнообразные кросс-модальные задачи (такие как поиск изображение-текст, генерация подписей к изображениям и т. д.)
CLIP: веха в контрастивном обучении сопоставлению изображений и текста
Базовые понятия
CLIP (Contrastive Language-Image Pre-training) — это мультимодальная модель, предложенная OpenAI в 2021 году, которая устанавливает связи между изображениями и текстом с помощью контрастивного обучения.
CLIP состоит из двух основных компонентов:
- Энкодер изображений: Преобразует изображения в векторы признаков (например, с использованием Vision Transformer или ResNet).
- Энкодер текста: Преобразует текстовые описания в векторы признаков (например, с использованием Transformer).
Рабочий процесс:
- Ввод:
- Пары изображение-текст (например, фотография собаки + описание "фотография собаки").
- Кодирование:
- Энкодер изображений извлекает признаки изображения, а энкодер текста извлекает признаки текста.
- Контрастивное обучение:
- Вычислите матрицу сходства для всех пар изображение–текст и оптимизируйте модель с помощью функции потерь (например, InfoNCE), чтобы признаки совпадающих пар сближались, а несовпадающих — отдалялись.
Векторные признаки, выводимые обоими кодировщиками, отображаются в одно и то же семантическое пространство, выравнивая представления изображений и текста посредством контрастивного обучения.
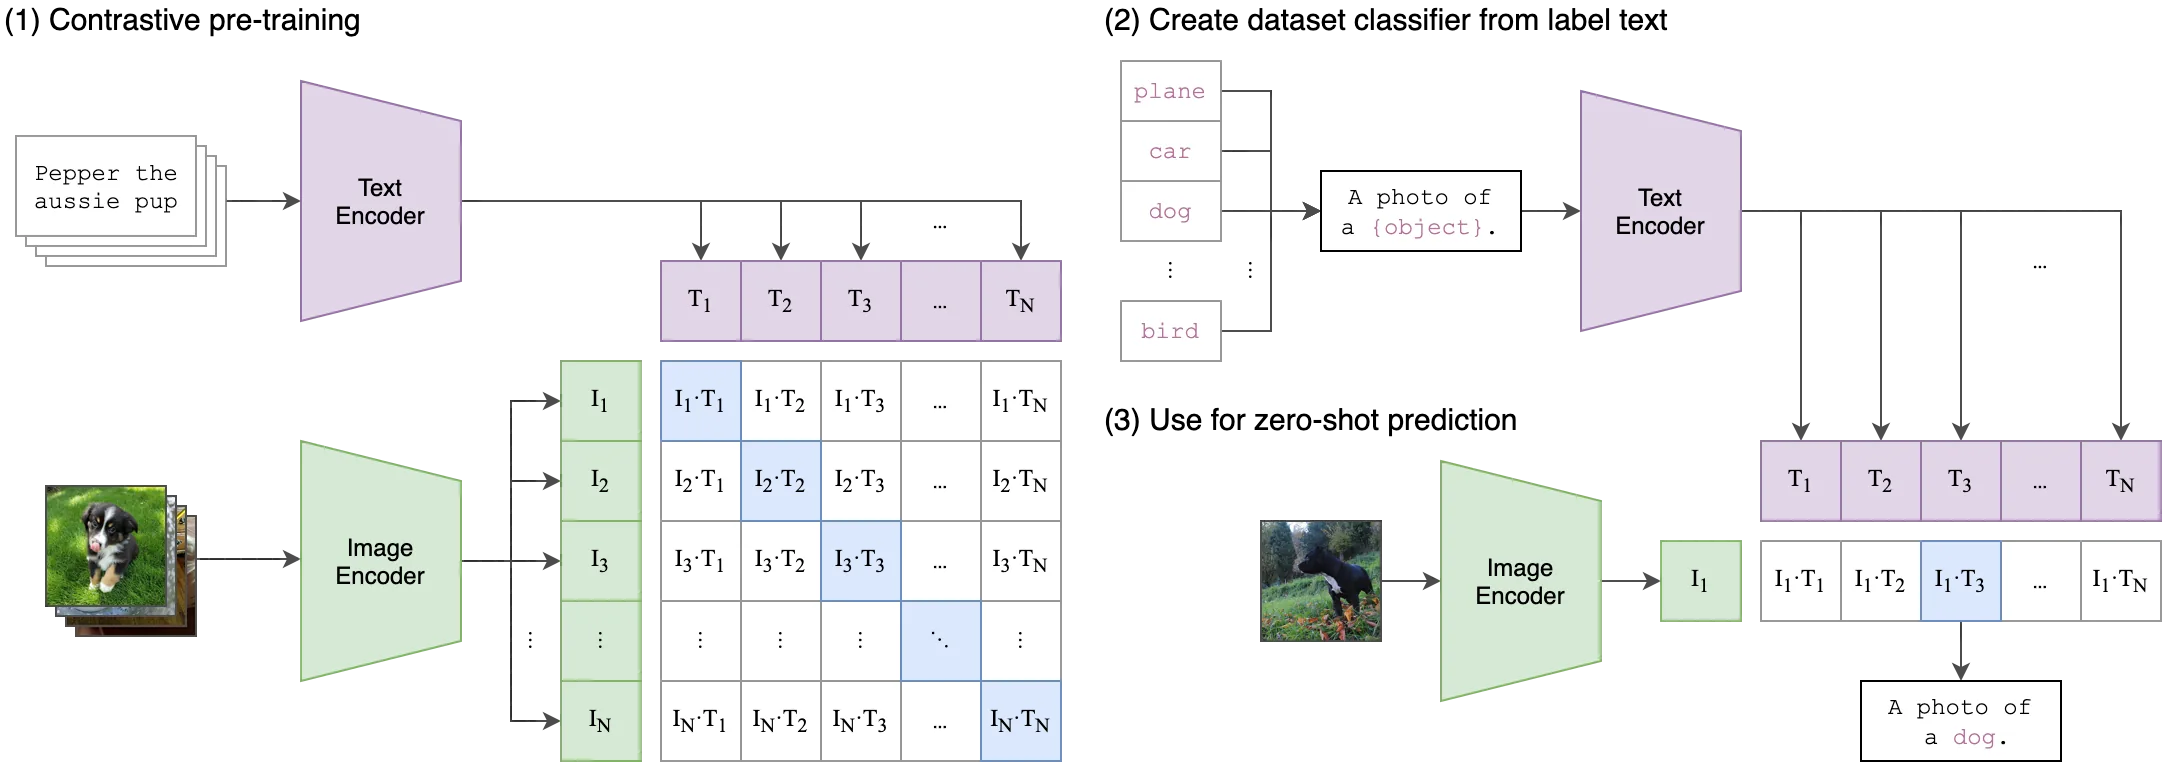
Пояснение ключевых частей на рисунке
Раздел таблицы: матрица контрастивного обучения
В таблице показано вычисление сходства для пар изображение–текст (предполагается, что имеетсяNтекстов и4изображений):
- Строки (изображения):
I1, I2, I3, I4Представляют различные признаки изображений. - Столбцы (тексты):
T1, T2, ..., TNПредставляют различные признаки текстов. - Значения ячеек(e.g.,
I1-T1): Косинусное сходство между векторами признаков изображенияI1и текстаT1.
Цель:
Максимизировать сходство на диагонали (правильные пары, например,I1-T1), и минимизировать сходство вне диагонали (неправильные пары, например,I1-T2). В этом заключается основная идея контрастивного обучения.
Раздел с примерами
- Примеры изображений:
- "Пеппер — австралийский щенок" (фотография щенка австралийской овчарки).
- "Planer car dog" (возможно, шум или неправильная аннотация; на самом деле это должен быть текст шаблона "A photo of a (object)").
- Текстовый шаблон:
- "A photo of a (object)" — это часто используемый шаблон текстового запроса во время предварительного обучения CLIP, используемый для обобщения на разные категории (например, "a photo of a dog").
Архитектура модели
- Двухэнкодерная архитектура:
- Энкодер изображений: обычно Vision Transformer (ViT) или ResNet
- Энкодер текста: основан на архитектуре Transformer
- Целевая функция контрастивного обучения:
- Положительные пары (согласованные пары изображение-текст) близки в пространстве признаков
- Отрицательные пары (несовпадающие пары изображение-текст) находятся далеко друг от друга в пространстве признаков
Процесс обучения
Пример
image_features = image_encoder(image_batch) # Извлечение признаков изображения
text_features = text_encoder(text_batch) # Извлечение признаков текста
# Вычисление матрицы сходства
logits = torch.matmul(image_features, text_features.T) * temperature
labels = torch.arange(batch_size) # По диагонали — положительные примеры
# Симметричная контрастивная функция потерь
loss_img = cross_entropy(logits, labels)
loss_txt = cross_entropy(logits.T, labels)
total_loss = (loss_img + loss_txt)/2
Сценарии применения
- Zero-shot классификация изображений: Классифицируйте новые категории без дообучения
- Поиск изображение-текст: Обеспечивает эффективный поиск текст→изображение или изображение→текст
- Модерация контента: Выявление содержимого изображений, не соответствующего текстовым описаниям
DALL-E: магия генерации изображений по тексту
Базовые понятия
DALL-E — это модель генерации изображений по тексту, разработанная OpenAI, которая может создавать высококачественные изображения по описаниям на естественном языке.
Технические особенности
Двухэтапное обучение:
- Этап 1: Дискретный вариационный автоэнкодер (dVAE) сжимает изображения в визуальные токены
- Этап 2: Авторегрессионный трансформер изучает отображение из текста в визуальные токены
Ключевые инновации:
- Рассматривает генерацию изображений как задачу предсказания последовательности
- Использует модель-трансформер с 12 миллиардами параметров
Пример процесса генерации
Пример
text = "Сиба-ину в скафандре играет в видеоигру на космической станции"
text_tokens = tokenizer(text) # Кодирование текста
image_tokens = transformer.generate(text_tokens) # Генерация визуальных токенов
image = dvae.decode(image_tokens) # Декодирование в изображение
Эволюция модели
| Version | Основные улучшения | Возможность генерации |
|---|---|---|
| DALL-E 1 | Базовая архитектура | Разрешение 256x256 |
| DALL-E 2 | Диффузионная модель | Разрешение 1024x1024, более точное |
| DALL-E 3 | Интегрирован с ChatGPT | Понимание более сложных промптов |
Другие важные мультимодальные модели
ALIGN(Google)
- Обучена на зашумлённых данных веб-масштаба
- Продемонстрировала эффективность крупномасштабных слаборазмеченных данных
Flamingo(DeepMind)
- Обрабатывает чередующиеся мультимодальные последовательности (например, чередование текста и изображений)
- Поддерживает обучение с малым числом примеров
BEiT-3(Microsoft)
- Единый фреймворк мультимодального предварительного обучения
- Превосходно справляется с задачами обработки изображений, текста и визуально-языковыми задачами
Проблемы применения мультимодальных моделей
- Требования к данным: Требуются огромные объёмы высококачественных согласованных мультимодальных данных
- Вычислительные затраты: Обучение этих моделей требует огромных вычислительных ресурсов
- Трудности оценки: отсутствие единых стандартов оценки для мультимодальных задач
- Проблемы предвзятости: могут усиливать социальные предубеждения, присутствующие в обучающих данных
Практическое занятие: классификация без примеров с CLIP
Пример
import torch
from PIL import Image
# Загрузка модели и предобработка
device = "cuda" if torch.cuda.is_available() else "cpu"
model, preprocess = clip.load("ViT-B/32", device=device)
# Подготовка входных данных
image = preprocess(Image.open("dog.jpg")).unsqueeze(0).to(device)
text_inputs = clip.tokenize(["a dog", "a cat", "птица"]).на(device)
# Вычисление признаков
with torch.no_grad():
image_features = model.encode_image(image)
text_features = model.encode_text(text_inputs)
# Вычисление сходства
logits = (image_features @ text_features.T).softmax(dim=-1)
print("Предсказанные вероятности:", logits.cpu().numpy())
Направления дальнейшего развития
- Более эффективные архитектуры: сокращение вычислительных затрат и повышение скорости инференса
- Более широкое объединение модальностей: включение большего числа модальностей, таких как аудио и видео
- Способность к причинно-следственному пониманию: улучшение глубокого понимания моделью мультимодального контента
- Управляемая генерация: улучшение точного контроля и редактируемости генерируемого контента
Мультимодальные предварительно обученные модели меняют то, как люди взаимодействуют с машинами. От кросс-модального понимания CLIP до творческой генерации DALL-E — эти технологии открывают совершенно новые возможности для приложений ИИ.
Другие расширения