Основы лингвистики
Как важная ветвь искусственного интеллекта, обработка естественного языка (NLP) направлена на то, чтобы компьютеры могли понимать, интерпретировать и генерировать человеческий язык. Чтобы овладеть NLP, необходимо сначала понять базовые принципы, лежащие в основе человеческого языка, - это фундамент лингвистики.
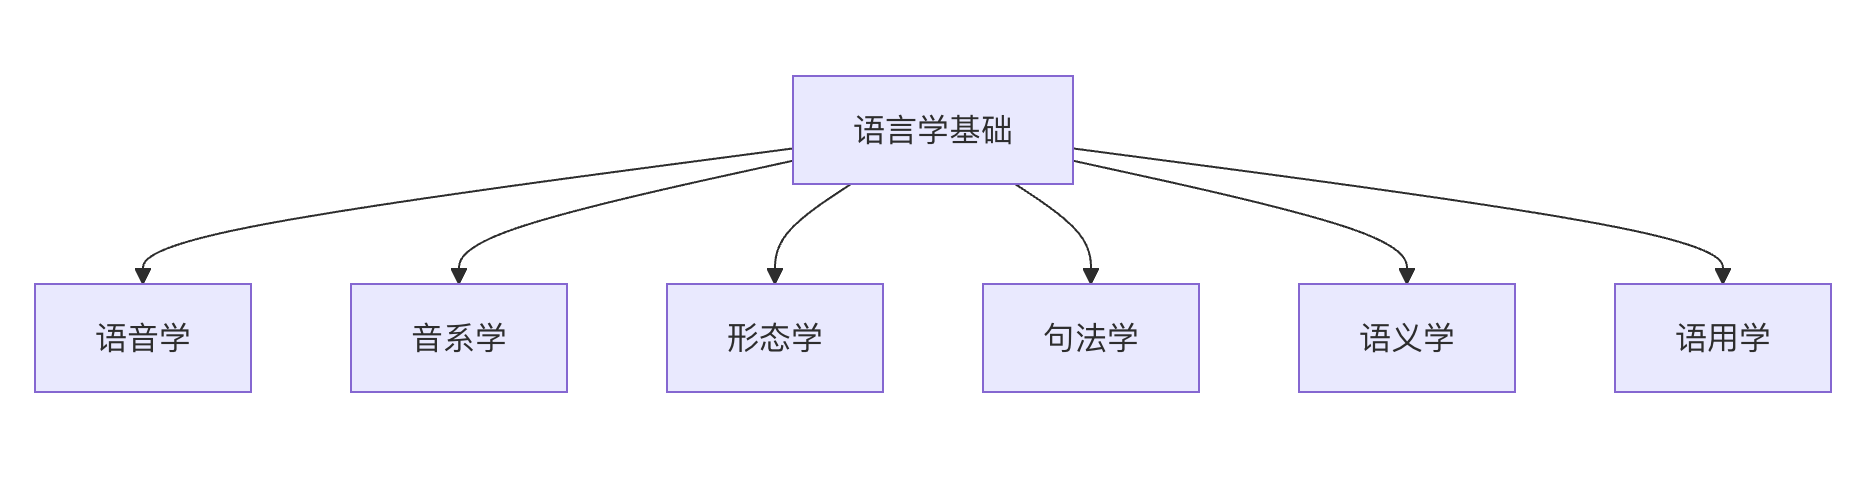
Лингвистика предоставляет теоретическую основу и аналитические инструменты для NLP, в основном включая следующие ключевые аспекты:
- Фонетика: изучает звуковую систему языка
- Фонология: изучает, как звуки сочетаются, образуя значимые языковые единицы
- Морфология: изучает внутреннюю структуру слов
- Синтаксис: изучает структуру предложения
- Семантика: изучает значение языка
- Прагматика: изучает использование языка в контексте
Фонетика и фонология
Фонетика
Фонетика изучает физические свойства и механизмы производства звуков речи, сосредотачиваясь на акустических и физиологических характеристиках речи.
Артикуляционные органы и способы артикуляции
- Артикуляционные органы:
- Лёгкие: обеспечивают воздушный поток
- Гортань: вибрация голосовых связок создаёт звонкие звуки
- Ротовая полость: язык, зубы и губы модулируют воздушный поток
- Носовая полость: производит носовые звуки
Классификация согласных
Классифицируются по способу артикуляции и месту артикуляции:
-
Способ артикуляции:
- Взрывные: /p/, /b/, /t/, /d/, /k/, /g/
- Фрикативные: /f/, /v/, /s/, /z/
- Аффрикаты: /ts/, /tʃ/
- Носовые: /m/, /n/, /ŋ/
- Боковой: /l/
- Дрожащий: /r/
-
Место артикуляции:
- Губно-губные: /p/, /b/, /m/
- Губно-зубные: /f/, /v/
- Альвеолярные: /t/, /d/, /n/
- Велярные: /k/, /g/, /ŋ/
Классификация гласных
Классифицируются по положению языка и форме губ:
- Высота подъёма языка: гласные верхнего подъёма /i/, /u/, гласные среднего подъёма /e/, /o/, гласная нижнего подъёма /a/
- Ряд языка: гласные переднего ряда /i/, /e/, гласная среднего ряда /a/, гласные заднего ряда /u/, /o/
- Форма губ: огублённые гласные /u/, /o/, неогублённые гласные /i/, /e/, /a/
Особенности китайской фонетики
- Тоновый язык: тоны служат для различения смысла
- Четыре основных тона путунхуа: иньпин (阴平, ровный), янпин (阳平, восходящий), шаншэн (上声, нисходяще-восходящий), цюйшэн (去声, нисходящий)
- Пример: мама (mā), конопля (má), лошадь (mǎ), ругать (mà)
- Структура слога: структура инициали (声母) + финали (韵母)
- Инициали: 21 основная инициаль
- Финали: 39 базовых финалей
Фонология
Фонология изучает структуру и правила звуковых систем, сосредоточиваясь на функции звуков в конкретном языке.
Фонема
- Мельчайшая фонологическая единица, обладающая функцией различения значения
- Пример: в английском /p/ и /b/ — разные фонемы (pit vs bit)
- В китайском языке тоны являются неотъемлемой частью фонем
Аллофон
- Фонетические реализации одной и той же фонемы в разных окружениях
- Пример: в английском /p/ имеет разную степень аспирации в разных позициях
Фонологические правила
- Описывают закономерности звуковых изменений в определённых окружениях
- Пример: правила тонального сандхи для китайского иероглифа «один»
- Фонетические изменения английского множественного числа: cats /s/, dogs /z/, horses /ɪz/
Применения в NLP
- Распознавание речи: преобразование звуковых сигналов в текст
- Синтез речи: преобразование текста в речь
- Преобразование фонем в иероглифы: преобразование из пиньиня в китайские иероглифы
- Анализ просодии: вычислительный анализ стихотворной просодии
Морфология
Морфология изучает внутреннюю структуру слов и правила словообразования и является основой анализа на лексическом уровне.
Базовые понятия
Морфема
- Наименьшая значимая грамматическая единица языка
- Свободная морфема: морфема, которая может использоваться самостоятельно, например «书» (книга), «run»
- Связанная морфема: должна присоединяться к другим морфемам, таким как префиксы и суффиксы
Корень, аффикс и основа
- Корень: носитель основного значения слова
- Пример: в «unhappiness» «happy» — корень
- Аффикс:
- Префикс: un-, re-, pre-
- Суффикс: -ness, -tion, -ly
- Инфикс: относительно редкий, например, в тагальском
- Основа: форма после удаления словоизменительных аффиксов
Словообразование
Вывод
- Изменяет часть речи или значение слова путём добавления словообразовательных аффиксов
- Примеры:
- happy → unhappy (добавление отрицательного префикса)
- happy → happiness (суффикс, образующий существительное)
- teach → teacher (суффикс деятеля)
Словосложение
- Соединение двух или более корней для образования нового слова
- Примеры на английском:
- blackboard(black + board)
- laptop(lap + top)
- Примеры на китайском:
- компьютер (электрический + мозг = компьютер)
- мобильный телефон (рука + машина = мобильный телефон)
Словоизменение
- Изменяет грамматическую форму слова, не меняя его основного значения
- Спряжение английских глаголов: walk, walks, walked, walking
- Множественное число существительных: book → books, child → children
- В китайском языке сравнительно мало словоизменительной морфологии
Особенности морфологии китайского языка
Понятие слова
- Границы слов в китайском языке довольно размыты
- Границы между иероглифами, словами и словосочетаниями менее чёткие, чем в английском
- Пример: «研究生» может быть одним словом, или его можно проанализировать как «研究» + «生»
Способы словообразования
-
Словосложение — доминирующий способ:
- Определительная связь: поезд (огонь + транспортное средство)
- Глагольно-объектная связь: водитель (управлять + машина)
- Субъектно-предикативный: earthquake (earth + quake)
- Сочинительный: friend (friend + friend)
-
Редупликация в словообразовании:
- Редупликация глаголов: 看看 (смотреть-смотреть), 走走 (идти-идти)
- Редупликация прилагательных: redredof (красный-красный), SlowSlowground (медленно-медленно)
- Редупликация существительных: 人人 (человек-человек), 事事 (дело-дело)
Гибкое употребление частей речи
- Один и тот же иероглиф или слово может выступать в роли разных частей речи
- Пример: «水» может быть существительным (喝水 — пить воду) или глаголом (水稻田 — поливать рисовое поле)
Применения в NLP
Стемминг
- Приведение слов к их основе
- Алгоритм Портера: сводит «running», «runs» и «ran» к «run»
Лемматизация
- Приведение слов к их словарной форме (лемме)
- Учитывает информацию о части речи, что повышает точность
Сегментация китайских слов
- Поскольку китайские слова не разделяются пробелами, требуется сегментация слов
- Методы, основанные на словарях, статистике или нейронных сетях
Разметка частей речи
- Определение грамматической категории каждого слова
- Предоставляет основополагающую информацию для синтаксического анализа
Синтаксис
Синтаксис изучает структуру и закономерности организации предложений и является ядром понимания грамматики языка.
Базовые понятия
Структура фразы
- Именная группа (NP): фраза, в центре которой стоит существительное
- Пример: та интересная книга (та интересная книга)
- Глагольная фраза (VP): фраза, центром которой является глагол
- Пример: быстро бежать (быстро бежать)
- Предложная фраза (PP): фраза, центром которой является предлог
- Пример: на столе (на столе)
- Адъективная фраза (AP): фраза, центром которой является прилагательное
- Пример: очень красивый (очень красивый)
Члены предложения
- Подлежащее: исполнитель действия
- Сказуемое: описывает действие или состояние подлежащего
- Дополнение: объект, на который направлено действие
- Определение: член предложения, который модифицирует существительное
- Обстоятельство: составляющая, которая модифицирует глагол или прилагательное
- Комплемент: составляющая, которая даёт дополнительное описание
Методы синтаксического анализа
Грамматика фразовой структуры
- Использует правила переписывания для описания структуры предложения
- Пример:
S → NP VP
NP → Det N
VP → V NP
Det → the, a, an
N → cat, dog, book
V → chase, read
Грамматика зависимостей
- Основана на отношениях зависимости между словами
- Каждое слово зависит от главного слова (кроме корневого узла)
- Пример: в предложении «小猫追老鼠» (котёнок преследует мышь):
- «Преследует» — корневой узел
- «котёнок» зависит от «преследовать» (субъектно-предикатное отношение)
- «老鼠» (мышь) зависит от «追» (глагольно-объектное отношение)
- "маленький" (небольшой) зависит от "кот" (кот) (отношение модификатор — вершина)
Древовидное представление
chase
           /  \
       kitten mouse
          /
       small
Характеристики китайского синтаксиса
Характеристики порядка слов
- Базовый порядок слов: подлежащее — сказуемое — дополнение (SVO)
- Модификаторы предшествуют определяемому: de-структуры
- Пример: та красивая девушка в красной одежде
Особые структуры
- ba-конструкция: ba + дополнение + глагол
- Пример: Ihold书Place桌子Top (Я положил книгу на стол)
- bei-конструкция: подлежащее + by + агенс + глагол
- Пример: 书ByIPlace桌子Top (Книга была положена мной на стол)
- Экзистенциальные предложения: выражают существование или появление
- Пример: 桌子Top放着onebook书 (На столе лежит книга)
Степень грамматикализации
- Степень грамматикализации в китайском языке относительно низка
- Порядок слов и контекст играют важную роль в выражении грамматических отношений
- Не обладает богатой морфологической флексией
Сложности синтаксического анализа
Проблемы неоднозначности
- Структурная неоднозначность: предложение может иметь несколько синтаксических анализов
- Пример: "I看seealready拿着望far镜of人" (Я видел человека, держащего бинокль)
- Анализ 1: Я видел человека, использующего бинокль
- Анализ 2: Я видел человека, который держал бинокль
Дистантные зависимости
- Отношения зависимости между составляющими предложения могут охватывать большие расстояния
- Пример: в вопросе "什么书you昨天买already?" (Какую книгу ты купил вчера?), существует отношение зависимости между "什么" (что) и "买" (покупать)
Явления эллипсиса
- В китайском языке часто опускаются подлежащие или другие составляющие
- Пример: (Я) 昨天看already电Shadow,(电Shadow) 很OK看 — (Я) вчера посмотрел фильм, и (фильм) был очень хорошим
Применения в NLP
Синтаксические парсеры
- Основанные на правилах: используют написанные вручную грамматические правила
- Статистические методы: вероятностные модели на основе размеченных корпусов
- Глубокое обучение: использует нейронные сети для сквозного обучения
Синтаксические банки деревьев
- Penn Treebank (английский)
- Китайский банк деревьев (CTB)
- Предоставляет данные для обучения и оценки синтаксического анализа
Прикладные задачи
- Машинный перевод: понимание синтаксической структуры исходного языка
- Извлечение информации: извлечение информации на основе синтаксических шаблонов
- Системы ответов на вопросы: понимание синтаксической структуры вопросов
Семантика
Семантика изучает значение языка и является ядром понимания естественного языка.
Базовые понятия
Лексическая семантика
- Значение слова: понятие или значение, выражаемое словом
- Полисемия: слово имеет несколько связанных значений
- Синонимия: разные слова выражают одинаковые или близкие значения
- Антонимия: оппозиционные отношения между словами
- Гипонимия: отношения включения между понятиями
Семантические отношения
- Синонимы:
- Абсолютные синонимы: относительно редки
- <!-- Путь к файлу: templates/post_detail.html, под заголовком -->
- Антонимы:
- Комплементарные антонимы: 死-活 (мёртвый-живой), мужской-женский (мужской-женский)
- Градуальные антонимы: 冷-热 (холодный-горячий), 大-小 (большой-маленький)
- Реляционные антонимы: 老师-学生 (учитель-ученик), 买-卖 (покупать-продавать)
- Гиперонимы и гипонимы:
- Гиперонимы: животное, цвет
- Гипонимы: собака (dog), кошка (cat) (гипонимы животного)
Семантика предложения
Пропозиция
- Основное семантическое содержание, выражаемое предложением
- Пример: пропозиция, выраженная предложением "small明InGraph书馆看书" (Сяомин читает книгу в библиотеке):
- Агент: Сяомин
- Действие: читать
- Пациенс: книга (book)
- Место: Библиотека
Семантические роли
- Агент: исполнитель действия
- Пациенс: получатель действия
- Инструмент: инструмент, используемый для совершения действия
- Место: место, где происходит действие
- Время: время, когда происходит действие
- Образ действия: способ совершения действия
Аргументная структура
- Семантические участники, требуемые глаголом
- Пример: глагол "give" требует три аргумента:
- Дающий (Агент)
- Получатель (Реципиент)
- Даваемый объект (Пациенс)
Семантическое представление
Логическое представление
- Использует логические формулы для представления смысла
- Логика первого порядка: ∃x (person(x) ∧ happy(x))
- Пример: логическое представление предложения "Yes人Very High兴" (Кто-то очень счастлив)
Фреймовая семантика
- Понимание семантики на основе когнитивных фреймов
- Проект FrameNet: создание семантических ресурсов на основе фреймов
- Пример: фрейм коммерческой сделки включает такие элементы, как покупатель, продавец, товары и цена
Концептуальные графы
- Использование графовых структур для представления понятий и отношений
- Узлы представляют понятия, рёбра — отношения
- Подходит для представления сложных семантических сетей
Семантическая неоднозначность
Лексическая неоднозначность
- Полисемия: bank (финансовое учреждение / берег реки)
- Омофония: они/они (оба tāmen; они для людей / они для животных и предметов)
Структурная неоднозначность
- Неоднозначность модификатора: "漂亮ofFemale孩of衣clothes" (красивая одежда девушки / одежда красивой девушки)
- Неоднозначность сферы действия: "All学生allNoand格" (Все студенты не сдали / Не все студенты сдали)
Прагматическая неоднозначность
- Для определения значения необходим контекст
- Пример: референция местоимений, восстановление эллиптических элементов
Применения в NLP
Лексические семантические ресурсы
- WordNet: английская лексическая семантическая сеть
- HowNet: китайская лексическая семантическая база знаний
- Tongyici Cilin (Лес синонимов): китайская система классификации синонимов
Задачи семантического анализа
- Разрешение неоднозначности значения слова: Определить значение многозначного слова в конкретном контексте
- Разметка семантических ролей: Определить семантические роли в предложении
- Вычисление семантического сходства: Вычислить семантическое сходство между словами или предложениями
Области применения
- Системы ответов на вопросы: Понимать семантическое намерение вопросов
- Машинный перевод: Поддерживать семантическую согласованность при переводе
- Информационный поиск: Сопоставление релевантности на основе семантики
Прагматика
Прагматика изучает использование языка в конкретных коммуникативных ситуациях, уделяя особое внимание влиянию контекста на значение.
Базовые понятия
Контекст
- Лингвистический контекст: Контекстная информация
- Ситуативный контекст: Конкретная ситуация общения
- Культурный контекст: социокультурный фон
Теория речевых актов
- Локутивный акт: сам речевой акт
- Иллокутивный акт: цель, достигаемая посредством говорения
- Перлокутивный акт: эффект, производимый говорением
Типы иллокутивных актов
- Ассертивы: утверждают факты, например, "Сегодня идет дождь"
- Директивы: побуждают к действию, например, "Пожалуйста, закройте дверь"
- Комиссивы: обещают будущее действие, например, "Я приду завтра"
- Экспрессивы: выражают отношение, например, "Поздравляю"
- Декларации: изменяют статус-кво, например, "Объявляю собрание открытым"
Прагматические явления
Дейксис
- Языковые выражения, референция которых может быть определена только по контексту
- Персональный дейксис: я, ты, он
- Темпоральный дейксис: сейчас, вчера, завтра
- Пространственный дейксис: здесь, там, наверху
- Дискурсивный дейксис: как упоминалось выше, в итоге
Пресуппозиция
- Информация, которую говорящий предполагает уже известной слушателю
- Пример: "Жена Сяомина красива" предполагает, что Сяомин женат
Импликатура
- Конверсационная импликатура: Подразумеваемое значение, возникающее при нарушении принципа кооперации
- Пример: A: "Ты знаешь, сколько времени?" B: "Да, знаю."
- Ответ B нарушает максиму количества, подразумевая нежелание раскрывать время
Принцип кооперации
- Максима количества: Предоставляйте уместное количество информации
- Максима качества: Говорите правду
- Максима отношения: Говорите то, что относится к делу
- Максима способа: Выражайтесь ясно
Прагматические особенности китайского языка
Стратегии вежливости
- В китайском языке большое внимание уделяется принципу вежливости
- Использует эвфемизмы и почтительные формы
- Пример: pleaseask (Можно спросить), 麻烦you (Извините за беспокойство), NoOK意思 (Извините)
Высококонтекстная культура
- Опирается на контекст для понимания смысла
- Дискурс имплицитен и не выражается напрямую
- Пример: отказы в китайском языке часто косвенны
Теория лица
- Позитивное лицо: потребность в одобрении
- Негативное лицо: потребность в том, чтобы не быть потревоженным
- Влияет на выбор речевых актов
Применения в NLP
Диалоговые системы
- Распознавание намерений: Понимание истинного намерения пользователя
- Заполнение слотов: Извлечение ключевой информации из диалога
- Управление диалогом: Управление ходом диалога
Анализ тональности
- Имплицитная тональность: распознавание косвенно выраженных эмоций
- Обнаружение иронии: понимание истинного смысла ироничных высказываний
Машинный перевод
- Прагматическая эквивалентность: сохранение прагматической функции исходного текста
- Культурная адаптация: учёт культурных особенностей языка перевода
Особенности китайского языка
Китайский язык, как представитель сино-тибетской языковой семьи, обладает уникальными лингвистическими особенностями, которые создают особые вызовы и возможности для китайского NLP.
Необходимость сегментации слов
Отсутствие разделения пробелами
- Между китайскими словами нет явных разделителей
- Пример: 「Ilove北京天peace门」 нужно сегментировать на 「I/love/北京/天peace门」 (Я / люблю / Пекин / Тяньаньмэнь)
- В отличие от естественной сегментации слов в таких языках, как английский
Понятие «слова» является сложным
- Границы между иероглифами, словами и фразами размыты
- Пример: 「研究」 (исследование) может быть словом, и 「研究生」 (аспирант) тоже может быть словом
- Контекст влияет на результаты сегментации слов
Неоднозначность сегментации слов
Комбинаторная неоднозначность
- Одну и ту же последовательность символов можно сегментировать разными способами
- Пример: 「结婚ofand尚未结婚of」 (женатые и ещё не женатые)
- Неправильная сегментация: 结婚of/and尚/未结婚of (женатый / монах / не женатый)
- Правильная сегментация: 结婚of/and/尚未/结婚of (женатый / и / ещё не / женатый)
Неоднозначность пересечения
- Соседние схемы сегментации перекрываются
- Чанчуньская городская аптека «Чанчунь» / магазин афродизиаков мэра Чанчуня
- Схема 1: long春市/long春/药店 (город Чанчунь / Чанчунь / аптека)
- Схема 2: Чанчунь / мэр / весенняя аптека
Истинная неоднозначность
- Разные результаты сегментации одинаково грамматически и семантически приемлемы
- Ракетки для пинг-понга распроданы / Аукцион по пинг-понгу завершён
- Схема 1: ракетки для настольного тенниса / распроданы
- Схема 2: настольный теннис / аукцион / завершён
Методы сегментации слов
Словарные методы
- Алгоритмы максимального совпадения (прямой, обратный, двунаправленный)
- Преимущества: простота и эффективность
- Недостатки: не могут справляться с неоднозначностью и словами вне словаря
Статистические методы
- N-граммные языковые модели
- Скрытая марковская модель (HMM)
- Условные случайные поля (CRF)
Методы на основе глубокого обучения
- Двунаправленная LSTM + CRF
- Предобученные модели, такие как BERT
- Нейронные сети на уровне символов
Китайские иероглифы, лексика и грамматические структуры
Особенности китайских иероглифов
Квадратно-блочная структура
- Китайские иероглифы имеют квадратный внешний вид
- Каждый иероглиф занимает одинаковое по ширине пространство
- Единство формы, звучания и значения иероглифа
Пиктографические и идеографические особенности
- Пиктограммы: день (солнце), месяц (луна), 山 (гора), 水 (вода)
- Простые идеограммы: верх, низ, корень, кончик
- Составные идеограммы: яркий (明), отдых (休), доверие (信)
- Фонетико-семантические соединения: составляют более 80% китайских иероглифов, например, 江 (氵 + 工, река)
Явления многозвучности и многозначности
- Один иероглиф с несколькими произношениями: линия (xíng/háng), длинный (cháng/zhǎng)
- Один иероглиф с несколькими значениями: 「打」 имеет несколько значений, таких как бить, покупать, делать и т. д.
Особенности лексики
Богатые способы словообразования
- Простые слова: Нельзя разделить; например, 桌子 (стол), 葡萄 (виноград)
- Сложные слова: Состоят из двух или более морфем
- Близкие синонимы: счастливый-радостный (счастливый), большой-огромный (большой-огромный)
- Аффиксация: номер один (первый), 老师 (учитель)
Высокая семантическая прозрачность лексики
- Значение слова можно вывести из составляющих его иероглифов
- Пример: 「洗衣machine」 = 洗 (мыть) + 衣 (одежда) + machine (машина)
- Помогает понимать новые слова и термины
Гибкая конверсия частей речи
- Одно и то же слово может выступать в роли разных частей речи
- Пример: "вода"
- Существительное: пить воду (пить воду)
- Глагол: поливать поле (орошать поля)
- Прилагательное: Horizontal很水 (очень плохого/посредственного качества, разговорное)
Характеристики грамматической структуры
Относительно фиксированный порядок слов
- Базовый порядок слов: подлежащее — сказуемое — дополнение (SVO)
- Определения предшествуют главному слову: Redof花 (красные цветы)
- Обстоятельства предшествуют сказуемому: SlowSlowground走 (медленно идти/ходить)
Разнообразные грамматические средства
- Порядок слов: изменение порядка слов выражает разные значения
- Служебные словаof (de - притяжательная/определительная частица), ground (de - частица обстоятельства), 得 (de - частица дополнения), already (le - видовая частица, указывающая на завершение), 着 (zhe - видовая частица, указывающая на продолжающееся состояние), pass (guò - видовая частица, указывающая на прошлый опыт), и т. д.
- Редупликация: 看看 (взглянуть), 走走 (пройтись), redredof (очень красный)
Низкая степень грамматикализации
- Не обладает богатой морфологической флексией
- Глаголы не имеют морфологических изменений по времени и залогу
- Существительные не имеют падежного словоизменения или требований согласования по числу
Особые проблемы в NLP для китайского языка
Проблемы предварительной обработки текста
Сложность сегментации слов
- Разрешение неоднозначности требует семантического понимания
- Сложность распознавания новых слов
- Распознавание специализированной лексики предметной области
Преобразование между упрощённым и традиционным китайским
- Один упрощённый иероглиф соответствует нескольким традиционным иероглифам: после (後/после)
- Один традиционный иероглиф соответствует нескольким упрощённым иероглифам: 髮 (испускать/髪)
- Региональные различия в лексике: 计算机/电脑 (компьютер)
Проблемы с кодировкой
- Несколько схем кодирования: GB2312, GBK, UTF-8
- Преобразование кодировки может привести к потере информации
Обработка языковых вариантов
Различия диалектов
- Региональные различия в произношении, лексике и грамматике
- Пример: «times儿» в пекинском диалекте, «阿拉» в шанхайском диалекте
- Влияет на распознавание речи и понимание текста
Различия регистра/стиля
- Классический китайский против современного китайского
- Формальный регистр против разговорной речи
- Интернет-сленг и модные словечки
Употребление в Гонконге, Макао и Тайване
- Различия в привычном употреблении слов: of士/出租车 (такси), 巴士/公交车 (автобус)
- Грамматические различия: Yes冇 (да/нет, «есть или нет»)
- Обработка заимствований: транслитерация против вольного перевода
Трудности семантического понимания
Сильная зависимость от контекста
- Сложная референция местоимений
- Частые явления эллипсиса
- Требуется больше контекстной информации
Богатые культурные коннотации
- Понимание идиом и аллюзий
- Культурно-специфичные концепции: Face子 (лицо), отношения (гуаньси/связи)
- Знание традиционного культурного фона
Гибкое использование языка
- Вариации порядка слов: take-конструкции, bei-конструкции
- Разнообразные способы выражения: эвфемистические, имплицитные
- Культурные особенности прагматических принципов
Иерархическая структура текста
Как носитель языка, текст обладает многоуровневыми структурными характеристиками. Понимание этих иерархических структур имеет решающее значение для проектирования эффективных систем NLP.
Символьный уровень
Базовые единицы
Определение символа
- Наименьшая визуальная единица текста
- Включает буквы, китайские иероглифы, цифры, знаки препинания и т. д.
- Базовая единица системы кодирования Unicode
Символьные типы
- Буквенные символы:A-Z, a-z
- Цифровые символы:0-9
- Китайские символы: диапазон Unicode 4E00-9FFF
- Знаки пунктуации:。,!?;:""''
- Специальные символы: @#$%^&* и т. д.
Обработка на уровне символов
Обработка кодирования
- Кодировка ASCII: подходит для английского
- Кодировка Unicode: поддерживает несколько языков
- Кодировка UTF-8: кодировка переменной длины, широко используется
Модели последовательностей символов
- RNN на уровне символов: напрямую обрабатывает последовательности символов
- Свёрточные нейронные сети: Извлекают признаки на уровне символов
- Transformer: Механизм самовнимания обрабатывает символы
Сценарии применения
- Проверка орфографии: Обнаруживает ошибки на уровне символов
- Генерация текста: Языковые модели на уровне символов
- Малоресурсные языки: Альтернативный подход при нехватке лексических ресурсов
Уровень слова
Определение слова
Понятие слова
- Языковая единица с полным значением
- Базовая единица синтаксического анализа
- Относительно независимо с точки зрения произношения
Лексические категории
- Знаменательные слова: существительные, глаголы, прилагательные, наречия
- Служебные слова: предлоги, союзы, частицы, междометия
- Служебные слова: высокочастотные служебные слова, такие как the, a, is, have
- Знаменательные слова: слова, несущие основное значение
Представление слов
Унитарное кодирование
- Каждое слово представляется вектором
- Длина вектора равна размеру словаря
- Только соответствующая позиция равна 1, все остальные — 0
- Недостатки: высокая размерность, невозможность представить семантическую близость
Векторные представления слов
- Word2Vec: векторы слов на основе нейронной сети
- CBOW: предсказывает центральное слово на основе контекста
- Skip-gram: предсказывает контекст на основе центрального слова
- GloVe: на основе глобальной статистической информации о словаре
- FastText: векторы слов, учитывающие информацию на уровне символов
Контекстные векторные представления слов
- ELMo: контекстно-зависимые представления, генерируемые двунаправленной LSTM
- BERT: двунаправленный кодировщик на основе Transformer
- Одно и то же слово имеет разные представления в разных контекстах
Лексические отношения
Семантические отношения
- Синонимия: happy-glad (happy-glad)
- Антонимия: big-small (big-small)
- Гипонимия: animal-dog (animal-dog)
Морфологические отношения
- Корневые отношения:run-running-ran
- Словообразовательные отношения:happy-happiness
- Отношения словосложения:black + board → blackboard
Дистрибутивные отношения
- Слова с похожими контекстуальными распределениями обычно семантически связаны
- Пример: «医生» (врач) и «护士» (медсестра) часто встречаются в похожих контекстах
- Это основополагающее предположение обучения векторным представлениям слов
Обработка на уровне слов
Нормализация слов
- Обработка регистра: Приведение текста к нижнему или верхнему регистру
- Лемматизация: Приведение слов к их словарной форме (лемме)
- Стемминг: удаление аффиксов для получения основы
Фильтрация стоп-слов
- Удаление высокочастотных, малоинформативных слов
- Китайские стоп-слова: de, le, shi, zai, he и т. д.
- Английские стоп-слова: the, a, an, is, are и т. д.
Обработка низкочастотных слов
- Замена на единый токен (например, <UNK>)
- Улучшение способности модели к обобщению
- Уменьшение размера словаря
Сценарии применения
- Информационный поиск: построение инвертированных индексов
- Классификация текста: извлечение и представление признаков
- Машинный перевод: выравнивание и замена слов
Фразовый уровень
Определение фразы
Основные концепции
- Грамматическая единица, состоящая из нескольких слов
- Имеет внутреннюю структуру и внешнюю функцию
- Организована вокруг главного слова
Типы фраз
- Именная группа (NP): с центром на существительном
- Пример: интересная книга
- Глагольная группа (VP): с центром на глаголе
- Пример: внимательно читая (внимательно читая)
- Предложная группа (PP): с центром на предлоге
- Пример: на столе (на столе)
- Адъективная группа (AP): с центром на прилагательном
- Пример: очень красивый (очень красивый)
Распознавание фраз
Методы на основе правил
- Использование шаблонов грамматических правил
- Пример: NP → (Det) (Adj) N
- Опирается на вручную написанные грамматические правила
Методы на основе статистики
- Использование n-gram-моделей для выявления распространённых фраз
- Основаны на таких статистических показателях, как взаимная информация, критерий хи-квадрат
- Пример: "纽约whenreport" (New York Times) как устойчивая фраза
Методы на основе глубокого обучения
- Модели разметки последовательностей (например, BiLSTM-CRF)
- Сквозное обнаружение фраз
- Предобученные языковые модели (например, BERT)
Представление фразы
Комбинирование векторов слов
- Простое усреднение: взять среднее составляющих векторов слов
- Взвешенное усреднение: назначить веса на основе важности слов
- Рекуррентная нейронная сеть: комбинирование с учётом порядка слов
Эмбеддинг фразы
- Непосредственно обучать векторные представления на уровне фраз
- Модель Skip-phrase: аналогична Skip-gram
- Задача аналогии для фраз: Китай:Пекин::Франция:Париж
Сценарии применения
- Извлечение информации: выявление ключевых фраз
- Понимание запросов: обработка поисковых запросов
- Анализ тональности: выявление фраз — целей мнений
Уровень предложения
Определение предложения
Основные концепции
- Лингвистическая единица, выражающая законченный смысл
- Обладает грамматической самостоятельностью
- Содержит основную структуру подлежащего и сказуемого
Типы предложений
- Повествовательные предложения: Выражают факты или мнения
- Вопросительные предложения: Задают вопросы
- Побудительные предложения: Выражают просьбы или команды
- Восклицательные предложения: Выражают сильные эмоции
Представление предложения
Комбинирование векторов слов
- Мешок слов (BoW): Простое суммирование, игнорирующее порядок слов
- Взвешивание TF-IDF: учёт важности слов
- Модели последовательностей: RNN/LSTM учитывают информацию о порядке слов
Эмбеддинг предложения
- Skip-Thought: предсказание контекстных предложений
- InferSent: представление на основе задач с учителем
- Sentence-BERT: представление предложения на основе BERT
Представление синтаксической структуры
- Дерево зависимостей: представление отношений зависимости между словами
- Дерево составляющих: представление отношений фразовой структуры
- Графовое представление: объединение нескольких отношений
Обработка на уровне предложений
Сегментация предложений
- Сегментация непрерывного текста на предложения
- Сложность китайского языка: многофункциональность точки
- Методы: на основе правил, машинное обучение
Сжатие предложений
- Упрощение, сохраняющее ключевую информацию
- Удаление избыточных компонентов
- Применение к суммаризации
Переписывание предложений
- Преобразование предложений с сохранением семантики
- Преобразование активного залога в пассивный
- Применение для аугментации данных
Сценарии применения
- Машинный перевод: выравнивание и генерация на уровне предложений
- Суммирование текста: Извлечение ключевых предложений
- Системы ответов на вопросы: Понимание вопроса и генерация ответов
Уровень дискурса
Структура дискурса
Основные концепции
- Связное целое, состоящее из нескольких предложений
- Обладает тематической согласованностью и логической связностью
- Включает такие структуры, как введение, основная часть и заключение
Средства связности
- Референция: Местоимения, указательные местоимения
- Коннективы: потому что, следовательно, но
- Лексическая связность: Повтор, синонимия, гиперонимия/гипонимия
- Эллипсис: Анафорический или катафорический эллипсис
Дискурсивные отношения
- Причинное отношение: потому что...поэтому...
- Контрастивное отношение: хотя...но...
- Сочинительное отношение: с одной стороны...с другой стороны...
- Темпоральное отношение: сначала...затем...наконец...
Анализ дискурса
Разрешение кореференции
- Определите референт местоимения или именной группы
- Пример: В предложении «Сяо Мин опоздал. Он сожалел.» «Он» относится к «Сяо Мин»
- Методы: основанные на правилах, машинное обучение, глубокое обучение
Тематическое моделирование
- LDA: латентное размещение Дирихле (LDA)
- Выявление латентных тематических распределений в тексте
- Применяется для кластеризации и классификации текстов
Анализ траектории тональности
- Отслеживание изменений тональности в дискурсе
- Выявление поворотных точек тональности
- Применяется для анализа отзывов и литературоведческих исследований
Представление дискурса
Глобальный вектор
- Усреднение всех векторов предложений
- Взвешенное среднее (например, веса TF-IDF)
- Иерархическая комбинация
Графовое представление
- Узлы представляют предложения или концепции
- Рёбра представляют отношения
- Применение к суммаризации
Сети памяти
- Хранить и извлекать информацию о дискурсе
- Обрабатывать дальние зависимости
- Применяются в системах ответов на вопросы
Сценарии применения
- Автоматическое реферирование: извлечение основного содержания
- Системы ответов на вопросы: рассуждение по нескольким предложениям
- Генерация текста: поддержание связности дискурса
Языковые модели и вероятностные грамматики
Основы языковых моделей
Основные концепции
Определение языковой модели
- Модель, вычисляющая вероятность последовательностей слов
- Оценить беглость и правдоподобность предложений
- Формальное описание: P(w₁,w₂,…,wₙ)
Области применения
- Распознавание речи: выбрать наиболее вероятную последовательность слов
- Машинный перевод: оценить варианты перевода
- Генерация текста: предсказать следующее слово
N-граммные модели
Марковское предположение
- Текущее слово зависит только от предыдущих n-1 слов
- Упрощённое вычисление вероятности: P(wᵢ|w₁,…,wᵢ₋₁) ≈ P(wᵢ|wᵢ₋ₙ₊₁,…,wᵢ₋₁)
Обучение модели
- Оценка максимального правдоподобия
- Подсчёт и нормализация
- Методы сглаживания (add-one, Good-Turing и т. д.)
Ограничения
- Проблема разреженности данных
- Трудно улавливать дальние зависимости
- Ограниченная контекстная информация
Нейросетевые языковые модели
Модели нейронных сетей прямого распространения
Базовая структура
- Входной слой: one-hot-представления предыдущих n-1 слов
- Слой эмбеддингов: обучение векторов слов
- Скрытый слой: нелинейное преобразование
- Выходной слой: предсказание распределения вероятностей следующего слова
Преимущества
- Распределённые представления смягчают проблему разреженности данных
- Автоматическое изучение комбинаций признаков
- Лучшая способность к обобщению
Модели рекуррентных нейронных сетей
Структура RNN
- Рекуррентная обработка последовательностей переменной длины
- Скрытые состояния передают историческую информацию
- Применение в языковом моделировании
LSTM/GRU
- Решение проблемы исчезающего градиента
- Моделирование дальних зависимостей
- Более стабильный процесс обучения
Модели Transformer
Механизм самовнимания
- Моделирование глобального контекста
- Преимущество параллельных вычислений
- Позиционное кодирование учитывает порядок слов
Предобученные языковые модели
- BERT: двунаправленное контекстное представление
- GPT: авторегрессионная генеративная модель
- Высокая способность к переносу обучения
Вероятностные грамматические модели
Вероятностная контекстно-свободная грамматика (PCFG)
Основные концепции
- Присваивать вероятности правилам CFG
- P(X → γ) представляет вероятность применения правила
- Вероятность предложения равна произведению вероятностей вдоль пути вывода
Оценка параметров
- Подсчёт применений правил из банков деревьев
- Оценка максимального правдоподобия
- Сглаживание для разреженных правил
Приложения
- Синтаксический разбор
- Оценка вероятности предложения
- Разрешение неоднозначности
Модели грамматик зависимостей
Вероятностная грамматика зависимостей
- Присвоение вероятностей отношениям зависимости
- На основе статистики лексической совместной встречаемости
- Учитывать расстояние и синтаксические ограничения
Алгоритмы разбора
- Алгоритмы на основе графов (алгоритм Эйснера)
- Алгоритмы на основе переходов
- Нейросетевые парсеры
Языковые ресурсы и аннотирование
Корпусные ресурсы
Общие корпусы
Английские корпусы
- Корпус Брауна
- Британский национальный корпус (BNC)
- Корпус современного американского английского (COCA)
Китайские корпусы
- Корпус современного китайского языка Пекинского университета
- Сбалансированный корпус современного китайского языка Национальной комиссии по языку
- Корпус китайской Википедии
Аннотированный корпус
Корпус с разметкой частей речи
- Penn Treebank
- Китайский банк деревьев (CTB)
Синтаксический банк деревьев
- Penn Treebank
- Китайский банк деревьев зависимостей
Семантически аннотированный корпус
- PropBank (семантические роли)
- FrameNet (фреймовая семантика)
- SemEval (семантические отношения)
Лексико-семантические ресурсы
Ресурсы английского языка
WordNet
- Набор синонимов (синсет)
- Сеть лексических отношений
- Широко используется в NLP-исследованиях
FrameNet
- Основан на фреймовой семантике
- Аннотирование семантических ролей
- Ресурсы с богатым набором примеров предложений
Ресурсы китайского языка
HowNet
- Китайско-английский словарь понятий
- Система семемного анализа
- Сеть семантических отношений
Tongyici Cilin (китайский тезаурус синонимов)
- Классификация китайских синонимов
- Иерархическая организационная структура
- Ресурсы для расширения словаря
Наборы данных для оценки
Стандартные наборы данных для задач
Сегментация слов и разметка частей речи
- Размеченный корпус PKU
- Размеченный корпус MSRA
Синтаксический разбор
- Chinese Treebank
- CTB 5.1/6.0/7.0
Семантический анализ
- Chinese PropBank
- Данные оценки NLPCC
Наборы данных прикладных задач
Классификация текста
- THUCNews
- Fudan Corpus
Анализ тональности
- ChnSentiCorp
- Корпус тональности Weibo
Системы ответов на вопросы
- Набор данных NLPCC QA
- WebQA
Междисциплинарные исследования в лингвистике и NLP
Компьютерная лингвистика
Области исследований
Речевые технологии
- Распознавание речи
- Синтез речи
- Преобразование голоса
Грамматический анализ
- Автоматический синтаксический анализ
- Индукция грамматики
- Построение банка деревьев
Семантические вычисления
- Разрешение неоднозначности значений слов
- Разметка семантических ролей
- Семантическое сходство
Когнитивная лингвистика и обработка естественного языка
Моделирование усвоения языка
Усвоение языка ребёнком
- Модели роста словарного запаса
- Моделирование развития грамматики
- Обработка естественного языка, вдохновлённая когнитивистикой
Нейрокогнитивные модели
- Моделирование обработки языка мозгом
- Нейросимволические системы
- Мультимодальное обучение
Моделирование эволюции языка
Компьютерное моделирование
- Формирование лексикона
- Возникновение грамматики
- Культурная передача
Многоагентные системы
- Эволюция системы коммуникации
- Проблема заземления символов
- Модели языковых игр
Социолингвистика и NLP
Обработка языковой вариативности
Распознавание диалектов
- Анализ фонетических признаков
- Моделирование лексических различий
- Машинный перевод диалектов
Социолингвистические особенности
- Распознавание возраста и пола
- Прогнозирование уровня образования
- Анализ региональных диалектов
Поддержка языковой политики
Создание языковых ресурсов
- Языки меньшинств
- Сохранение исчезающих языков
- Разработка многоязычных технологий
Технологии языкового образования
- Обучение с компьютерной поддержкой
- Автоматизированная оценка эссе
- Персонализированные обучающие системы