Модели «последовательность-в-последовательность»
Модели Sequence-to-Sequence (Seq2Seq) — важная архитектура в обработке естественного языка (NLP), специально предназначенная для задач преобразования одной последовательности в другую последовательность. Основная идея этой модели — принимать входную последовательность переменной длины и генерировать выходную последовательность переменной длины.
Базовые понятия
Модели Seq2Seq относятся к архитектуреЭнкодер-Декодер:
- Энкодер: кодирует входную последовательность в контекстный вектор фиксированной длины
- Декодер: пошагово генерирует выходную последовательность на основе контекстного вектора
Типичные характеристики
- Длина входной и выходной последовательностей может различаться
- Подходит для задач преобразования между несколькими языками
- Способна обрабатывать данные последовательностей переменной длины
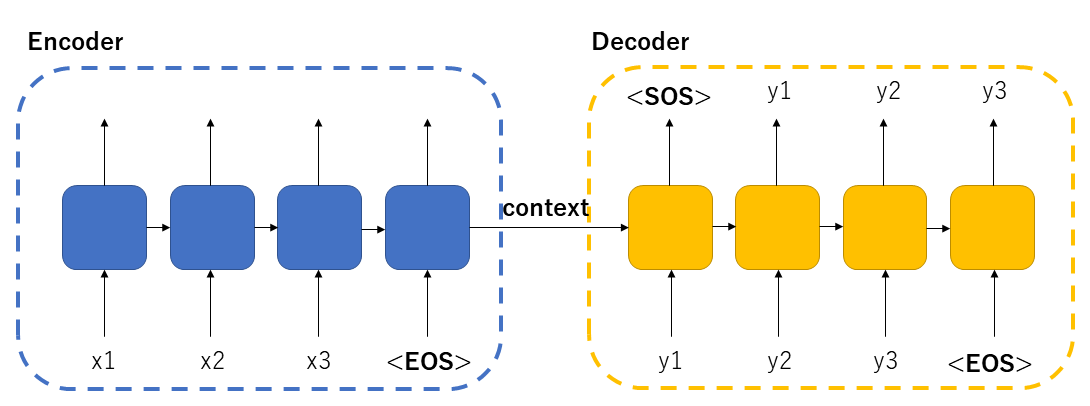
Основные принципы моделей Seq2Seq
Основные компоненты архитектуры
Энкодер
Энкодер обычно использует RNN (например, LSTM или GRU) для обработки входной последовательности, постепенно сжимая информацию о последовательности в скрытые состояния и в конечном итоге генерируя контекстный вектор, представляющий всю входную последовательность.
Декодер
Декодер начинает с контекстного вектора и пошагово генерирует каждый элемент выходной последовательности, пока не сгенерирует конечный токен.
Рабочий процесс
- Кодировщик считывает входную последовательность и генерирует контекстный вектор
- Декодер инициализирует своё скрытое состояние контекстным вектором
- Декодер пошагово генерирует элементы выходной последовательности
- Останавливается, когда сгенерирован конечный токен
Ключевые технические улучшения
- Механизм внимания: решает проблему потери информации в длинных последовательностях
- Архитектура Transformer: модель Seq2Seq, полностью основанная на механизмах самовнимания
- Beam Search: улучшает стратегии декодирования для повышения качества генерации
Примеры
class Seq2Seq(nn.Module):
def __init__(self):
self.encoder = RNN(input_size, hidden_size)
self.decoder = RNN(hidden_size, output_size)
def forward(self, input_seq):
# Фаза кодирования
hidden = self.encoder(input_seq)
# Фаза декодирования
outputs = self.decoder(hidden)
return outputs
Применение Seq2Seq в машинном переводе
Характеристики задач машинного перевода
- Как вход, так и выход являются текстовыми последовательностями
- Длины последовательностей между двумя языками обычно не совпадают
- Требуется понимание исходного языка и генерация целевого языка
Типичные примеры применения
- Система Google Neural Machine Translation (GNMT)
- Система перевода Fairseq от Facebook
- Инструмент с открытым исходным кодом OpenNMT
Ключевые моменты реализации
- Использовать двунаправленные RNN-энкодеры для захвата контекстной информации
- Задействовать механизмы внимания для обработки длинных предложений
- Использовать субсловную токенизацию для обработки редких слов
Примеры
translation_model = Seq2Seq(
encoder=BiLSTM(vocab_size=src_vocab_size),
decoder=LSTM(vocab_size=tgt_vocab_size),
внимание=DotProductAttention()
)
Применение Seq2Seq в суммаризации текста
Классификация задач суммаризации текста
| Тип суммаризации | Характеристики | Пригодность для Seq2Seq |
|---|---|---|
| Экстрактивная суммаризация | Выбирает важные предложения из исходного текста | Не подходит |
| Абстрактивная суммаризация | Генерирует новый сжатый текст | Очень подходит |
Ключевые технические проблемы
- Обработка сжатия информации длинных документов
- Поддержание связности и точности резюме
- Избегание повторной генерации идентичного содержимого
Решения
- Pointer-Generator Network: объединяет экстрактивные и генеративные методы
- Механизм покрытия: отслеживает сгенерированное содержимое, чтобы избежать повторений
- Обучение с подкреплением: оптимизирует метрики суммаризации, такие как ROUGE
Примеры
summarizer = Seq2Seq(
encoder=TransformerEncoder(),
decoder=TransformerDecoder(),
pointer_network=True
)
Применение Seq2Seq в генерации диалогов
Сравнение типов диалоговых систем
| Type | Характеристики | Пригодность для Seq2Seq |
|---|---|---|
| Диалог, ориентированный на задачи | Выполняет конкретные задачи | Ограниченная применимость |
| Диалог-болтовня | Общение на свободные темы | Очень подходит |
Особенности генерации диалога
- Необходимость поддерживать связность диалога
- Ответы должны соответствовать контексту диалога
- Избегать генерации шаблонных, бессмысленных ответов
Методы улучшения
- Персонализированное встраивание: учитывает характеристики говорящего
- Управление тональностью: генерирует ответы с определённой эмоциональной окраской
- Состязательное обучение: улучшает естественность ответов
Примеры
chatbot = Seq2Seq(
encoder=GRU(hidden_size=512),
decoder=GRU(hidden_size=512),
personality_embedding=True
)
Обучение и оптимизация моделей Seq2Seq
Процесс обучения
- Подготовьте наборы данных параллельных корпусов
- Определите функцию потерь (обычно перекрёстная энтропия)
- Обучите с использованием Teacher Forcing
- Настройте гиперпараметры с использованием валидационного набора
Распространённые проблемы и решения
| Проблема | Причина | Решение |
|---|---|---|
| Исчезающий градиент | Длинные зависимости в последовательностях | Используйте LSTM/GRU или Transformer |
| Смещение экспозиции | Несоответствие между обучением и тестированием | Планируемое сэмплирование |
| Шаблонные ответы | Смещение максимального правдоподобия | Состязательное обучение или обучение с подкреплением |
Метрики оценки
- BLEU: часто используемые метрики для машинного перевода
- ROUGE: часто используемые метрики для суммаризации текста
- Оценка человеком: важное дополнение для диалоговых систем
Итоги и перспективы
Как ключевая технология в области NLP, модели Seq2Seq прошли путь от первоначальной простой архитектуры RNN до современных мощных моделей Transformer. Они продемонстрировали сильные возможности в таких задачах, как машинный перевод, суммаризация текста и генерация диалогов. Будущие направления развития включают:
- Более эффективная обработка длинных последовательностей
- Возможности обучения с малым числом примеров/без примеров
- Мультимодальное преобразование последовательностей
- Более управляемая генерация контента
Поняв принципы и применения моделей Seq2Seq, вы освоили мощный инструмент в NLP и можете начать создавать собственные приложения для преобразования последовательностей!
Другие расширения