Рекуррентная нейронная сеть (RNN)
Рекуррентная нейронная сеть (RNN) — это нейронная сеть, специально предназначенная для обработки последовательных данных (таких как текст, речь и временные ряды).
В отличие от традиционных нейронных сетей прямого распространения, RNN обладают способностью к «памяти», которая может сохранять информацию с предыдущих шагов.
RNN используют скрытое состояние с предыдущего шага, чтобы влиять на выход текущего шага, тем самым улавливая временные зависимости в последовательностях.
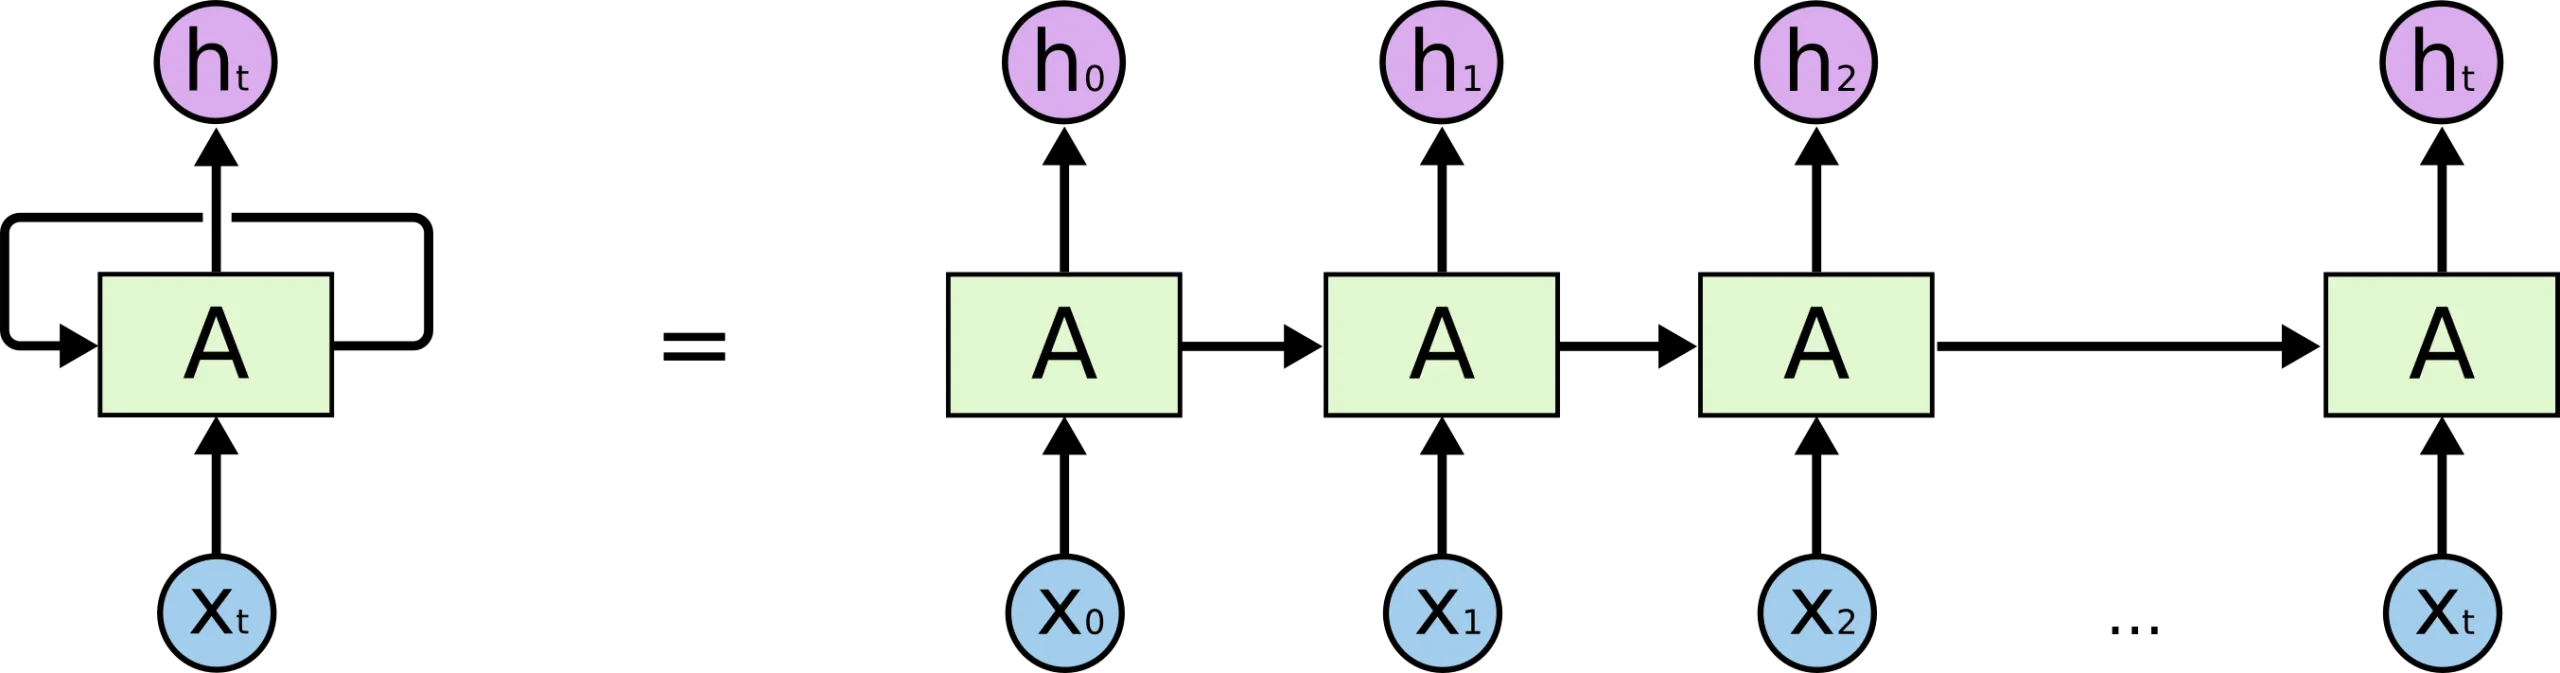
Основная идея RNN
Суть RNN заключается врекуррентных связях(Recurrent Connection), означающих, что выход сети зависит не только от текущего входа, но и от входов на всех предыдущих временных шагах. Такая структура позволяет RNN обрабатывать последовательные данные произвольной длины.
Традиционные нейронные сети: входы и выходы независимы (например, классификация изображений, где отдельные изображения не связаны).
RNN: Черезрекуррентные связи(Recurrent Connection) скрытое состояние с предыдущего шага передаётся на следующий шаг, образуя «память».
Вход на каждом шаге = текущие данные + скрытое состояние с предыдущего шага.
Выход зависит не только от текущего входа, но и от контекста всех предыдущих шагов.
Так же, как при чтении предложения, понимание текущего слова зависит от ранее прочитанного содержимого (например, «Он открыл __», вы предскажете «дверь» или «книгу»).
Пример
import numpy as np
class SimpleRNN:
def __init__(self, input_size, hidden_size):
self.Wx = np.random.randn(hidden_size, input_size) # Веса входа
self.Wh = np.random.randn(hidden_size, hidden_size) # Веса скрытого состояния
self.b = np.zeros((hidden_size, 1)) # Член смещения
def forward(self, x, h_prev):
h_next = np.tanh(np.dot(self.Wx, x) + np.dot(self.Wh, h_prev) + self.b)
return h_next
Как работает RNN
На каждом временном шаге t RNN выполняет следующие вычисления:
- Получает текущий вход xₜ и скрытое состояние hₜ₋₁ с предыдущего временного шага
- Вычисляет новое скрытое состояние hₜ = f(Wₕₕ·hₜ₋₁ + Wₓₕ·xₜ + b)
- Формирует выход yₜ = g(Wₕᵧ·hₜ + c)
Где f и g — обычно функции активации (такие как tanh или softmax).
Преимущества и недостатки RNN
Преимущества:
- Может обрабатывать последовательности переменной длины
- Теоретически может запоминать историческую информацию произвольной длины
- Разделение параметров (один и тот же набор весов используется для всех временных шагов)
Недостатки:
- Проблема исчезающего/взрывающегося градиента (сложно обучаться на долгосрочных зависимостях)
- Низкая вычислительная эффективность (невозможно обрабатывать временные шаги параллельно)
Долгая краткосрочная память (LSTM)
LSTM (долгая краткосрочная память) — улучшенная архитектура RNN, специально разработанная для решения проблемы долгосрочных зависимостей стандартных RNN.
2.1 Основная структура LSTM
LSTM вводит три механизма гейтирования и ячейку памяти:
| Компонент | Функция |
|---|---|
| Входной шлюз | Управляет потоком новой информации |
| Вентиль забывания | Решает, какую старую информацию отбросить |
| Выходной вентиль | Управляет количеством информации для вывода |
| Ячейка памяти | Хранит долговременное состояние |
Пример
class LSTMCell:
def __init__(self, input_size, hidden_size):
# Объединить веса всех вентилей
self.W = np.random.randn(4*hidden_size, input_size+hidden_size)
self.b = np.random.randn(4*hidden_size, 1)
def forward(self, x, h_prev, c_prev):
combined = np.vstack((h_prev, x))
gates = np.dot(self.W, combined) + self.b
# Разделить, чтобы получить каждый
f_gate = sigmoid(gates[:hidden_size]) # Шлюз забывания
i_gate = sigmoid(gates[hidden_size:2*hidden_size]) # Входной шлюз
o_gate = sigmoid(gates[2*hidden_size:3*hidden_size]) # Выходной шлюз
c_candidate = np.tanh(gates[3*hidden_size:]) # Память-кандидат
# Обновить память и скрытое состояние
c_next = f_gate * c_prev + i_gate c_candidate
h_next = o_gate * np.tanh(c_next)
return h_next, c_next
Как LSTM решает проблему долгосрочных зависимостей
- Избирательная память: гейт забывания может решить сохранить или отбросить конкретную информацию
- Путь градиента: ячейка памяти обеспечивает относительно прямой путь для распространения градиента
- Защита информации: сохранённое содержимое памяти не изменяется напрямую операциями на каждом временном шаге
Управляемый рекуррентный блок (GRU)
GRU (управляемый рекуррентный блок) — это упрощённая версия LSTM, которая уменьшает количество параметров, сохраняя схожую производительность.
Базовая структура GRU
GRU объединяет некоторые компоненты LSTM:
| Компонент | Функция |
|---|---|
| Гейт обновления | Решает, сколько старой информации сохранить |
| Гейт сброса | Решает, как объединить новую и старую информацию |
| Активация кандидата | Новое состояние вычисляется на основе вентиля сброса |
Пример
class GRUCell:
def __init__(self, input_size, hidden_size):
self.W = np.random.randn(3*hidden_size, input_size+hidden_size)
self.b = np.random.randn(3*hidden_size, 1)
def forward(self, x, h_prev):
combined = np.vstack((h_prev, x))
gates = np.dot(self.W, combined) + self.b
# Разделение сигналов вентилей
z = sigmoid(gates[:hidden_size]) # Вентиль обновления
r = sigmoid(gates[hidden_size:2*hidden_size]) # Вентиль сброса
h_candidate = np.tanh(np.dot(self.W[2*hidden_size:],
np.vstack((r*h_prev, x))) + self.b[2*hidden_size:]
# Обновление скрытого состояния
h_next = (1-z)*h_prev + z*h_candidate
return h_next
GRU против LSTM
| Характеристика | GRU | LSTM |
|---|---|---|
| Количество параметров | Меньше | Подробнее |
| Скорость обучения | Быстрее | Медленнее |
| Ячейка памяти | Отсутствует | Да |
| Количество вентилей | 2 | 3 |
| Производительность | Лучше подходит для небольших наборов данных | Может быть лучше для больших наборов данных |
Двунаправленная RNN (Bi-RNN)
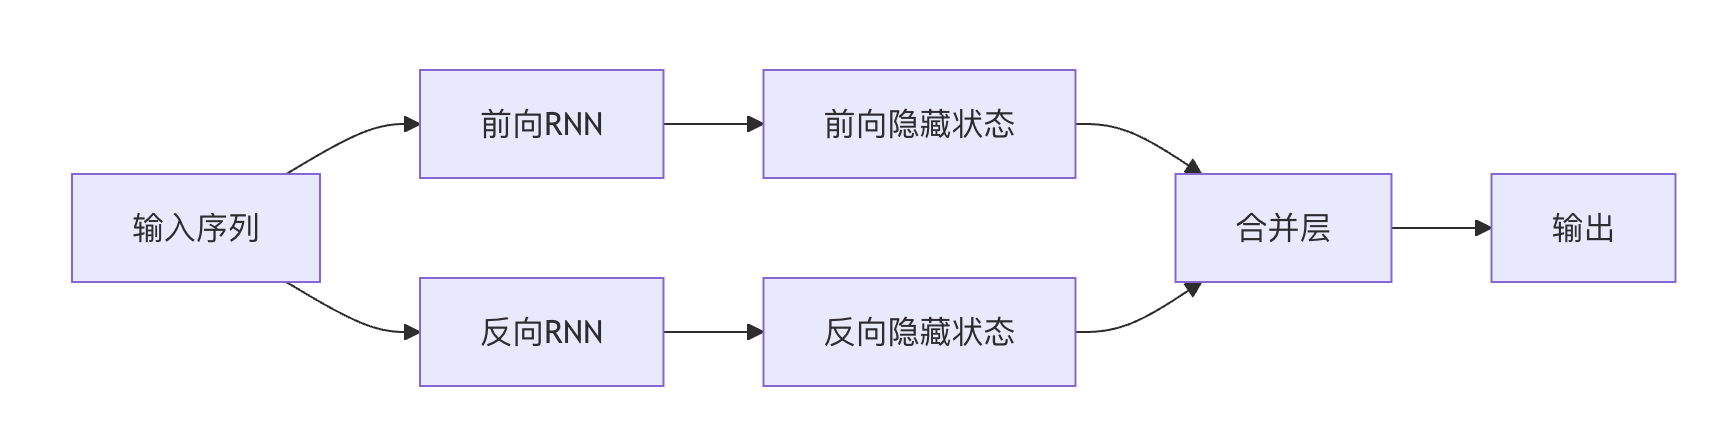
Двунаправленная RNN расширяет возможности моделирования последовательностей, одновременно учитывая информацию о прошлом и будущем контексте.
Архитектура двунаправленной RNN
Bi-RNN состоит из двух независимых слоёв RNN:
- Прямой слой: обрабатывает последовательность в хронологическом порядке
- Обратный слой: обрабатывает последовательность в обратном хронологическом порядке
Итоговый вывод представляет собой комбинацию выходов обоих направлений (обычно конкатенацию или суммирование).
Сценарии применения двунаправленной RNN
- Обработка естественного языка: разметка частей речи, распознавание именованных сущностей
- Распознавание речи: использует окружающий контекст для повышения точности
- Биоинформатика: предсказание структуры белков
- Прогнозирование временных рядов: учитывает исторические и будущие тенденции
Двунаправленная LSTM/GRU
В современных приложениях двунаправленные RNN обычно используют LSTM или GRU в качестве базового блока:
Пример
model.add(Bidirectional(LSTM(64))) # Создать двунаправленный слой LSTM
Практические упражнения
Упражнение 1: Реализуйте простую RNN
Используйте Python и NumPy для реализации простой RNN, способной к посимвольной генерации текста.
Упражнение 2: анализ тональности с помощью LSTM
Используйте Keras для построения классификатора тональности отзывов на фильмы на основе LSTM.
Упражнение 3: Распознавание именованных сущностей с помощью двунаправленной GRU
Реализуйте модель двунаправленной GRU для распознавания сущностей, таких как имена людей и местоположения, в тексте.
Упражнение 4: Сравнительный эксперимент
Сравните различия в производительности Vanilla RNN, LSTM и GRU на одном и том же наборе данных.
Итоги и дальнейшее обучение
RNN и её варианты — мощные инструменты для обработки последовательных данных. Чтобы глубоко их освоить:
- Понять, как распространяются градиенты в RNN
- Узнать, как механизм внимания улучшает RNN
- Исследовать связь между архитектурой Transformer и RNN
- Практиковать различные задачи моделирования последовательностей (машинный перевод, синтез речи и т. д.)