Clasificación de texto
La clasificación de texto (Text Classification) es una de las tareas más básicas e importantes en el procesamiento del lenguaje natural (NLP). Su objetivo es clasificar automáticamente un documento de texto dado en una o más categorías predefinidas.
Conceptos básicos
La clasificación de texto es como el bibliotecario de una biblioteca: necesita clasificar los libros y colocarlos en los estantes correctos según su contenido. En el ámbito de la informática, tenemos que enseñar a la máquina a comprender el contenido del texto y tomar decisiones de clasificación correctas.
Escenarios de aplicación
La clasificación de texto tiene una amplia gama de aplicaciones en la sociedad moderna:
- Análisis de sentimientos: determinar si un comentario es positivo o negativo
- Filtrado de spam: distinguir entre correos normales y spam
- Clasificación de noticias: clasificar noticias en secciones como deportes, finanzas, tecnología, etc.
- Reconocimiento de intenciones: comprender la intención real de las consultas de los usuarios
- Diagnóstico médico: clasificar tipos de enfermedades según la descripción de los síntomas
Flujo básico de la clasificación de texto
Un sistema completo de clasificación de texto generalmente incluye los siguientes pasos:
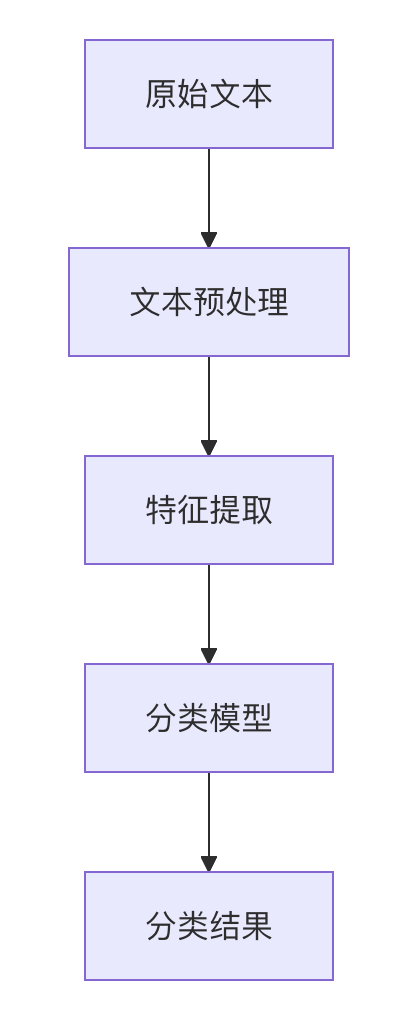
1. Preprocesamiento de texto
El preprocesamiento de texto consiste en convertir el texto original en un formato adecuado para que lo procesen los modelos de aprendizaje automático:
Ejemplo
import nltk
from nltk.corpus import stopwords
from nltk.stem import PorterStemmer
def preprocess_text(text):
# Convertir a minúsculas
text = text.lower()
# Eliminar caracteres especiales y números
text = re.sub(r'[^a-zA-Z\s]', '', text)
# Tokenización
words = text.split()
# Eliminar palabras vacías (stopwords)
stop_words = set(stopwords.words('english'))
words = [word for word in words if word not in stop_words]
# Stemming (derivación de palabras)
stemmer = PorterStemmer()
words = [stemmer.stem(word) for word in words]
return ' '.join(words)
2. Extracción de características
Convertir el texto en una representación numérica de características. Los métodos comunes incluyen:
| Método | Descripción | Ventajas | Desventajas |
|---|---|---|---|
| Modelo de bolsa de palabras (BoW) | Contar la frecuencia de palabras | Simple e intuitivo | Ignora el orden de las palabras y la semántica |
| TF-IDF | Considera la importancia de las palabras | Más preciso que BoW | Aún ignora el contexto |
| Word2Vec | Representación mediante vectores de palabras (word embeddings) | Captura relaciones semánticas | No puede manejar palabras polisémicas |
| BERT | Embeddings contextuales | La representación más avanzada | Requiere altos recursos computacionales |
3. Selección del modelo de clasificación
Elige un algoritmo de clasificación adecuado según los requisitos de la tarea y las características de los datos:
Métodos tradicionales de aprendizaje automático:
- Naive Bayes
- Máquina de vectores de soporte (SVM)
- Regresión logística
- Bosque aleatorio (Random Forest)
Métodos de aprendizaje profundo:
- Red neuronal convolucional (CNN)
- Red neuronal recurrente (RNN/LSTM)
- Modelos Transformer (BERT, etc.)
Ejemplo práctico: Clasificación de noticias
Demostremos cómo implementar la clasificación de texto usando Python con un ejemplo real. Utilizaremos el conjunto de datos 20 Newsgroups, un conjunto de datos clásico para la clasificación de noticias.
1. Preparación de datos
Ejemplo
# Seleccionar 4 categorías como ejemplo
categories = ['alt.atheism', 'soc.religion.christian', 'comp.graphics', 'sci.med']
# Cargar el conjunto de entrenamiento y el de prueba
newsgroups_train = fetch_20newsgroups(subset='train', categories=categories)
newsgroups_test = fetch_20newsgroups(subset='test', categories=categories)
print(f"Número de muestras del conjunto de entrenamiento: {len(newsgroups_train.data)}")
print(f"Número de muestras del conjunto de prueba: {len(newsgroups_test.data)}")
2. Extracción de características (TF-IDF)
Ejemplo
# Crear el vectorizador TF-IDF
vectorizer = TfidfVectorizer(max_features=5000)
# Transformar el conjunto de entrenamiento y el de prueba
X_train = vectorizer.fit_transform(newsgroups_train.data)
X_test = vectorizer.transform(newsgroups_test.data)
y_train = newsgroups_train.target
y_test = newsgroups_test.target
3. Entrenamiento del modelo (Regresión logística)
Ejemplo
from sklearn.metrics import accuracy_score, classification_report
# Crear y entrenar el modelo
model = LogisticRegression(max_iter=1000)
model.fit(X_train, y_train)
# Predecir el conjunto de prueba
y_pred = model.predict(X_test)
# Evaluar el modelo
print(f"Exactitud: {accuracy_score(y_test, y_pred):.2f}")
print("\n"Informe de clasificación:")
print(classification_report(y_test, y_pred, target_names=newsgroups_test.target_names))
4. Análisis de resultados
La salida típica podría ser la siguiente:
准确率: 0.91

分类报告:
                        precision    recall  f1-score   support

           alt.atheism       0.90      0.87      0.89       319
soc.religion.christian       0.93      0.95      0.94       389
         comp.graphics       0.89      0.90      0.90       396
               sci.med       0.92      0.91      0.92       398

              accuracy                           0.91      1502
             macro avg       0.91      0.91      0.91      1502
          weighted avg       0.91      0.91      0.91      1502
Técnicas avanzadas y desafíos
Manejo de clases desbalanceadas
Cuando la cantidad de muestras de algunas categorías es mucho mayor que la de otras, puedes intentar:
- Remuestreo (sobremuestreo de la clase minoritaria o submuestreo de la clase mayoritaria)
- Usar pesos de clase
- Probar diferentes métricas de evaluación (como F1-score en lugar de exactitud)
Métodos para mejorar el rendimiento del modelo
Ingeniería de características:
- Probar diferentes rangos de n-gramas
- Agregar características de etiquetado gramatical (POS)
- Usar word embeddings más avanzados
Optimización del modelo:
- Ajuste de hiperparámetros
- Ensamblaje de modelos (model ensemble)
- Probar modelos de aprendizaje profundo
Aumento de datos:
- Retrotraducción (Back Translation)
- Reemplazo de sinónimos
- Redes generativas antagónicas (GAN)
Desafíos comunes
- Clasificación multi-etiqueta: un documento puede pertenecer a múltiples categorías
- Adaptación al dominio: el rendimiento del modelo disminuye en dominios nuevos
- Aprendizaje con pocas muestras (few-shot learning): situaciones con datos etiquetados limitados
- Interpretabilidad: comprender por qué el modelo toma una decisión de clasificación específica
Resumen y ruta de aprendizaje
La clasificación de texto es una tarea fundamental del NLP; dominarla es esencial para comprender aplicaciones de NLP más complejas. Ruta de aprendizaje sugerida:
- Comenzar con métodos tradicionales de aprendizaje automático (como TF-IDF + SVM)
- Comprender los conceptos y aplicaciones de los word embeddings (Word2Vec, GloVe)
- Aprender la aplicación de modelos de aprendizaje profundo (CNN, LSTM) en la clasificación de texto
- Explorar el aprendizaje por transferencia de modelos de lenguaje preentrenados (BERT, GPT)
Mediante la práctica constante y la experimentación con diferentes métodos, podrás construir sistemas de clasificación de texto potentes y prácticos.
Otras extensiones