Механизм внимания
Механизм внимания — важная техника в глубоком обучении, которая имитирует способ распределения внимания в процессах человеческого зрительного и когнитивного восприятия. Так же как при чтении вы неосознанно сосредотачиваетесь на ключевых словах, механизм внимания позволяет нейронным сетям динамически сосредотачиваться на наиболее релевантных частях входных данных.
Базовые понятия
Основная идея механизма внимания такова:динамически назначать разные веса в зависимости от важности разных частей входных данных для текущей задачиЭто распределение весов не является фиксированным, а вычисляется динамически на основе контекста.
Математическое выражение
Механизм внимания в общем случае можно выразить так:
Attention(Q, K, V) = softmax(QK^T/√d_k)V
где:
- Q (Query): элемент запроса, для которого в данный момент нужно вычислить выход
- K (Key): ключ, используемый для сопоставления с элементом запроса
- V (Value): фактическое значение, соответствующее ключу
- d_k: размерность ключа, используемая для масштабирования результата скалярного произведения
Зачем нужен механизм внимания?
- Решение проблемы дальних зависимостей: традиционные RNN с трудом улавливают связи между удалёнными словами
- Возможность параллельных вычислений: по сравнению с последовательной обработкой RNN внимание можно вычислять параллельно
- Интерпретируемость: веса внимания могут наглядно показывать, на чём фокусируется модель
Механизм самовнимания
Самовнимание — это особая форма механизма внимания, которая позволяет каждому элементу входной последовательности устанавливать связи со всеми другими элементами последовательности.
Как это работает
- Для каждого элемента входной последовательности вычислите его оценку сходства со всеми элементами
- Используйте функцию softmax, чтобы преобразовать эти оценки в веса (от 0 до 1)
- Используйте эти веса, чтобы выполнить взвешенную сумму соответствующих значений и получить выход
Пример
import torch
import torch.nn.functional as F
def self_attention(query, key, value):
scores = torch.matmul(query, key.transpose(-2, -1)) / (query.size(-1) ** 0.5)
weights = F.softmax(scores, dim=-1)
return torch.matmul(weights, value)
Преимущества самовнимания
- Осведомлённость о глобальном контексте: каждая позиция может напрямую получать информацию из всех позиций последовательности
- Инвариантность к позиции: не зависит от порядка последовательности, подходит для обработки различных типов структурированных данных
- Эффективные вычисления: по сравнению со сложностью O(n) у RNN, самовнимание можно вычислять параллельно
Многоголовое внимание
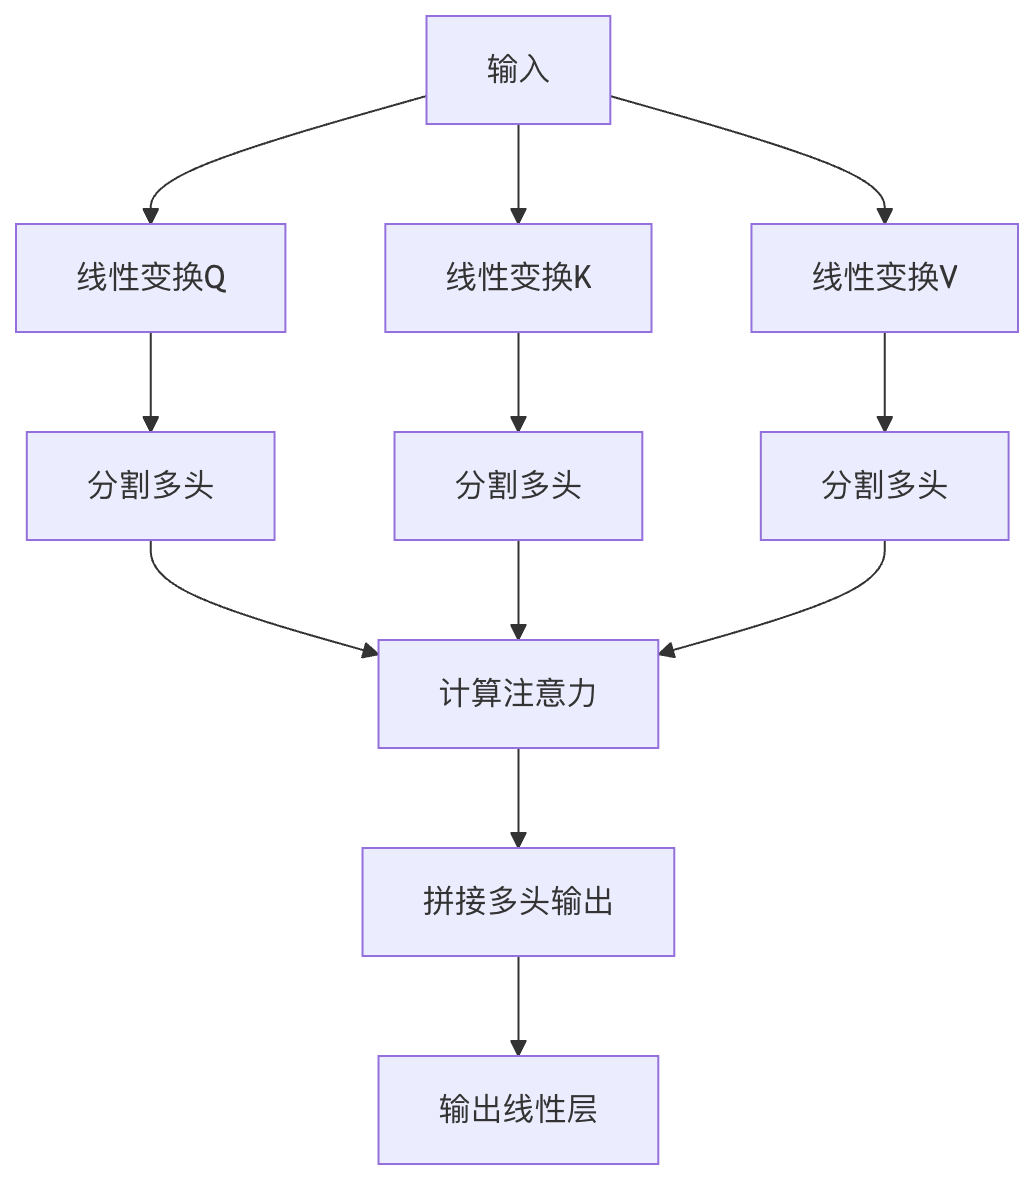
Многоголовое внимание — это расширение самовнимания. Оно выполняет механизм внимания несколько раз параллельно, а затем объединяет результаты.
Структура
- Несколько голов внимания: обычно использует 8 или более параллельных голов внимания
- Слои линейного преобразования: каждая голова имеет собственные матрицы преобразования Q, K, V
- Конкатенация и выход: объединить выходы всех голов и пропустить их через линейный слой
Преимущества многоголового внимания
- Улавливание различных связей: каждая голова может научиться фокусироваться на связях с разных точек зрения
- Усиленная выразительная способность: более сильная способность извлечения признаков, чем у одноголового внимания
- Стабильное обучение: комбинация нескольких голов может снизить зависимость модели от конкретных паттернов
Пример
class MultiHeadAttention(nn.Module):
def __init__(self, d_model, num_heads):
super().__init__()
self.d_model = d_model
self.num_heads = num_heads
self.d_k = d_model // num_heads
self.W_q = nn.Linear(d_model, d_model)
self.W_k = nn.Linear(d_model, d_model)
self.W_v = nn.Linear(d_model, d_model)
self.W_o = nn.Linear(d_model, d_model)
def forward(self, query, key, value):
batch_size = query.size(0)
# Линейное преобразование и разделение на несколько голов
Q = self.W_q(query).view(batch_size, -1, self.num_heads, self.d_k)
K = self.W_k(key).view(batch_size, -1, self.num_heads, self.d_k)
V = self.W_v(value).view(batch_size, -1, self.num_heads, self.d_k)
# Вычисление внимания
scores = torch.matmul(Q, K.transpose(-2, -1)) / (self.d_k ** 0.5)
weights = F.softmax(scores, dim=-1)
output = torch.matmul(weights, V)
# Объединить головы и выход
output = output.transpose(1, 2).contiguous().view(batch_size, -1, self.d_model)
return self.W_o(output)
Применение механизма внимания в NLP
Механизм внимания стал ключевым компонентом современных систем NLP, особенно в архитектуре Transformer.
Основные сценарии применения
Машинный перевод:
- Классическая модель Seq2Seq с механизмом внимания
- Позволяет модели сосредоточиться на наиболее релевантных частях исходного предложения при генерации каждого целевого слова
Суммаризация текста:
- Определение ключевой информации в исходном тексте с помощью весов внимания
- Генеративные модели суммаризации используют самовнимание для захвата глобальных связей в длинных документах
Системы ответов на вопросы:
- Перекрёстное внимание между вопросом и документом
- Помогает модели находить текстовые фрагменты, релевантные вопросу
Языковые модели:
- Модели серии GPT используют маскированное самовнимание
- Позволяет каждому слову обращать внимание на все предшествующие слова
Тематическое исследование: внимание в BERT
BERT (Bidirectional Encoder Representations from Transformers) — типичный представитель моделей, использующих механизм внимания:
- Двунаправленное самовнимание: учитывает одновременно левый и правый контекст
- 12/24 слоя Transformer: стекированные слои многоголового внимания
- Задачи предварительного обучения: изучает общие представления с помощью задач маскированного языкового моделирования и предсказания следующего предложения
Пример
from transformers import BertModel, BertTokenizer
tokenizer = BertTokenizer.from_pretrained('bert-base-uncased')
model = BertModel.from_pretrained('bert-base-uncased')
inputs = tokenizer("Привет, моя собака милая", return_tensors="pt")
outputs = model(**inputs)
# Получить веса внимания
attention = outputs.attentions # Содержит веса внимания для всех слоёв
Варианты и расширения механизма внимания
1. Масштабированное внимание на основе скалярного произведения
- Вводит коэффициент масштабирования (√d_k) для предотвращения насыщения softmax
- Высокая вычислительная эффективность, подходит для крупномасштабных приложений
2. Аддитивное внимание
- Использует однослойную сеть прямого распространения для вычисления функции совместимости
- Подходит для случаев, когда размерности запроса и ключа различаются
3. Локальное внимание
- Обращает внимание только на подмножество входных данных, снижая вычислительную сложность
- Балансирует глобальное внимание и вычислительную эффективность
4. Разреженное внимание
- Вычисляет веса внимания только для некоторых позиций
- Например, внимание со скользящим окном, используемое в Longformer
Практические упражнения
Упражнение 1: Реализация базового механизма внимания
Пример
import torch.nn as nn
import torch.nn.functional as F
class SimpleAttention(nn.Module):
def __init__(self, hidden_size):
super(SimpleAttention, self).__init__()
self.attention = nn.Linear(hidden_size, 1)
def forward(self, encoder_outputs):
# encoder_outputs: [batch_size, seq_len, hidden_size]
attention_scores = self.attention(encoder_outputs).squeeze(2) # [batch_size, seq_len]
attention_weights = F.softmax(attention_scores, dim=1)
context_vector = torch.bmm(attention_weights.unsqueeze(1), encoder_outputs) # [batch_size, 1, hidden_size]
return context_vector.squeeze(1), attention_weights
Упражнение 2: Визуализация весов внимания
Пример
import seaborn as sns
def plot_attention(attention_weights, source_tokens, target_tokens):
plt.figure(figsize=(10, 8))
sns.heatmap(attention_weights,
xticklabels=source_tokens,
yticklabels=target_tokens,
cmap="YlGnBu")
plt.xlabel("Токены источника")
plt.ylabel("Целевые токены")
plt.title("Визуализация весов внимания")
plt.show()
# Пример использования
source = ["The", "cat", "sat", "on", "the", "mat"]
target = ["Le", "chat", "s'est", "assis", "sur", "le", "tapis"]
attention = torch.rand(7, 6) # Смоделированные веса внимания
plot_attention(attention, source, target)
Итоги и дальнейшее обучение
Механизм внимания стал краеугольной технологией современного глубокого обучения, особенно в области NLP. Чтобы изучить его глубже:
Читайте оригинальные статьи:
- "Внимание — это всё, что вам нужно" (Vaswani et al., 2017)
- "Нейронный машинный перевод путём совместного обучения выравниванию и переводу" (Bahdanau et al., 2015)
Предлагаемые практические проекты:
- Реализовать полную модель Transformer
- Использовать механизм внимания для улучшения существующих моделей
- Анализировать влияние различных вариантов механизма внимания на производительность
Расширенные области применения:
- Визуальное внимание в компьютерном зрении
- Кросс-модальное внимание в мультимодальном обучении
- Механизм графового внимания в графовых нейронных сетях
Разработка механизма внимания всё ещё продолжается. Понимание его основных принципов поможет вам лучше освоить современные методы глубокого обучения.
Другие расширения