Генеративные предобученные модели
Генеративные предобученные модели — это класс моделей глубокого обучения, которые приобретают общие языковые знания из текстовых данных посредством крупномасштабного обучения без учителя и способны генерировать связный и разумный текст. Основными характеристиками таких моделей являются:
- Способность к генерации: может автоматически генерировать новый текст на основе входных данных (подсказки или контекста).
- Парадигма предварительного обучения + тонкой настройки: сначала предварительное обучение на больших объёмах данных, затем тонкая настройка под конкретные задачи.
- Авторегрессионная или автоэнкодирующая архитектура: изучает языковые закономерности с помощью различных целей обучения.

I. История развития моделей серии GPT
1.1 GPT-1: Пионерская отправная точка
GPT-1 (Generative Pre-trained Transformer) был выпущен OpenAI в 2018 году и впервые продемонстрировал эффективность крупномасштабного предварительного обучения без учителя плюс тонкой настройки с учителем.
Основные возможности:
- Архитектура декодера Transformer с 12 слоями
- 117 миллионов параметров
- Использовался набор данных BooksCorpus (примерно 7,000 книг)
- Стал пионером двухэтапной парадигмы «предварительное обучение + тонкая настройка»
1.2 GPT-2: Прорыв в масштабировании
GPT-2, выпущенный в 2019 году, продемонстрировал положительную корреляцию между масштабом модели и производительностью.
Ключевые улучшения:
- Масштаб параметров: 1.5 млрд (в 10 раз больше, чем у GPT-1)
- Обучающие данные: WebText (8 миллионов веб-страниц, 40GB текста)
- Убрана стадия дообучения, продемонстрирована способность к обучению без примеров
- Введено более длинное контекстное окно (1024 токена)
1.3 GPT-3: от количественного к качественному изменению
GPT-3, запущенная в 2020 году, достигла способности к обучению по нескольким примерам при масштабе параметров 175 млрд.
Революционный прогресс:
- Архитектура модели: 96-слойный Transformer
- Обучающие данные: Common Crawl + отобранные наборы данных (примерно 570GB)
- Продемонстрирована сильная способность к обучению в контексте
- Впервые достигнута способность выполнять множество задач NLP без дообучения
1.4 GPT-4 и последующие разработки
GPT-4, выпущенный в 2023 году, ещё больше расширил границы возможностей модели.
Последние разработки:
- Возможность мультимодальной обработки (текст + изображения)
- Более длинная контекстная память (32k токенов)
- Улучшенные возможности рассуждения и следования инструкциям
- Коммерческий API и экосистема плагинов
II. Принципы авторегрессионных языковых моделей
2.1 Основные понятия
Авторегрессионные языковые модели предсказывают распределение вероятностей следующего слова на основе предшествующего контекста:
P(x_t | x_<t) = P(x_t | x_1, x_2, ..., x_{t-1})
2.2 Математические принципы
Для последовательности слов x = (x₁, ..., xₙ) совместная вероятность факторизуется как:
P(x) = ∏ P(x_t | x_<t)
При обучении используется оценка максимального правдоподобия:
L(θ) = ∑ log P(x_t | x_<t; θ)
2.3 Архитектура декодера Transformer
Ключевые компоненты:
- Маскированное самовнимание: предотвращает утечку информации
# PyTorch 伪代码
attn_mask = torch.triu(torch.ones(seq_len, seq_len), diagonal=1)
- Позиционное кодирование: внедряет информацию о порядке последовательности
- Сеть прямого распространения: поэлементное преобразование признаков
III. Подробное объяснение методов генерации текста
3.1 Процесс генерации
Типичный процесс генерации текста:
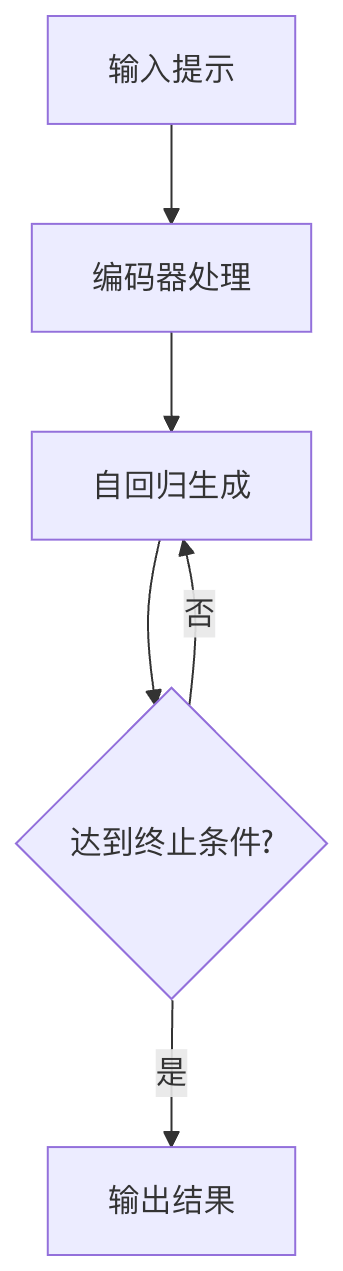
3.2 Сравнение стратегий декодирования
| Стратегия | Температура | Top-k | Top-p | Характеристики |
|---|---|---|---|---|
| Жадный поиск | - | - | - | Высокая детерминированность, но недостаточное разнообразие |
| Случайная выборка | Настраиваемый | Optional | Optional | Хорошая креативность, но может быть бессвязным |
| Лучевой поиск | - | - | - | Балансирует качество и разнообразие |
3.3 Параметры управления генерацией
Примеры ключевых параметров:
Пример
"max_length": 100, # Максимальная длина генерации
"temperature": 0.7, # Управляет случайностью (0-1)
"top_k": 50, # Количество токенов-кандидатов
"top_p": 0.9, # Порог ядерной выборки
"repetition_penalty": 1.2 # Коэффициент штрафа за повторение
}
IV. Основы промпт-инжиниринга
4.1 Основные принципы
- Ясность: Чётко выражайте намерение
- Контекст: Предоставляйте достаточно фоновой информации
- Структура: Используйте разделители и форматирование
- Ориентированность на примеры: Включайте few-shot примеры
4.2 Практические советы
- Ролевая установка:
You are a senior machine learning engineer, please explain in plain language...
- Декомпозиция шагов:
请按以下步骤解决问题:
1. 首先分析...
2. 然后计算...
3. 最后输出...
- Спецификация формата:
请用JSON格式输出,包含字段:summary, keywords, confidence
4.3 Типичные паттерны
- Шаблон инструкции:
任务:文本分类 输入:{text} 选项:positive, neutral, negative 输出: - **Цепочка рассуждений (CoT)**:
Please reason step by step: First... Second... Therefore the conclusion is...
V. Практические упражнения
5.1 Базовая генерация
Пример
generator = pipeline('text-generation', model='gpt2')
prompt = "Будущее развитие искусственного интеллекта"
output = generator(prompt, max_length=100)
print(output[0]['generated_text'])
5.2 Эксперименты по настройке параметров
Разработайте сравнительные эксперименты, чтобы наблюдать влияние различных параметров:
- Зафиксируйте prompt, варьируйте temperature (0.3 vs 0.7 vs 1.2)
- Сравните различия между top_k=10 и top_k=50
- Проверьте влияние разных max_length на согласованность генерации
5.3 Задача оптимизации промптов
Дан базовый промпт:
Write an article about climate change.
Направления оптимизации:
- Добавить настройку роли
- Указать структуру статьи
- Включить требования к ключевым словам
- Задать ограничения стиля
Систематически изучая историю развития моделей GPT, авторегрессионные принципы, методы генерации и промпт-инжиниринг, разработчики могут лучше использовать возможности современных больших языковых моделей. Рекомендуется начинать с простых промптов, постепенно экспериментировать с различными параметрами генерации, наблюдать изменения в поведении модели и в конечном итоге освоить методологию эффективного использования генеративного ИИ.
Другие расширения