Экосистема Python для NLP
Обработка естественного языка (NLP) — важная ветвь искусственного интеллекта. Благодаря богатой экосистеме библиотек Python стал предпочтительным языком для разработки в области NLP.
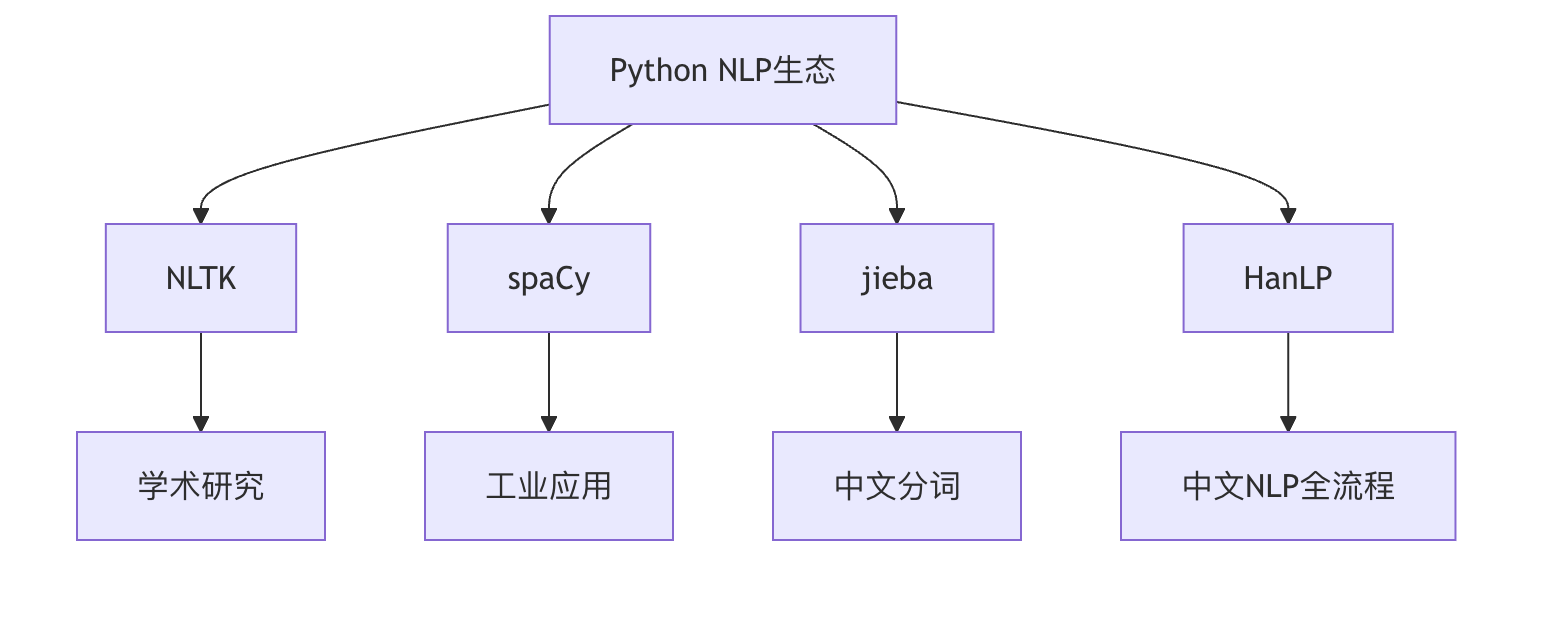
В этой статье дается всестороннее введение в основные инструменты экосистемы NLP в Python, включая:
- NLTK- предпочтительный инструмент обработки естественного языка для академических исследований
- spaCy- эффективный NLP-фреймворк промышленного уровня
- jieba- самый популярный инструмент сегментации китайских слов
- HanLP- полнофункциональная библиотека для NLP-обработки китайского языка
NLTK: швейцарский армейский нож для обработки естественного языка
Базовое введение
NLTK (Natural Language Toolkit) — одна из самых известных библиотек Python для NLP. Разработана Пенсильванским университетом; особенно подходит для учебных и исследовательских целей.
Основные возможности
- Токенизация текста
- Разметка частей речи (POS-теггинг)
- Распознавание именованных сущностей (NER)
- Анализ тональности
- Стемминг и лемматизация
Установка и базовое использование
Пример
nltk.download('punkt') # Загрузить необходимые пакеты данных
# Пример: токенизация текста
from nltk.tokenize import word_tokenize
text = "Обработка естественного языка увлекательна."
tokens = word_tokenize(text)
print(tokens) # Вывод: ['Обработка', 'естественного', 'языка', 'увлекательна', '.']
Анализ преимуществ и недостатков
| Преимущества | Недостатки |
|---|---|
| Комплексная функциональность, охватывающая основные задачи NLP | Более низкая эффективность выполнения |
| Хорошая документация и множество обучающих ресурсов | Требуется загрузка дополнительных пакетов данных |
| Подходит для обучения и исследований | Ограниченная поддержка китайского языка |
spaCy: NLP-фреймворк промышленного уровня
Базовое введение
spaCy — современная библиотека NLP, ориентированная на промышленные приложения и известная своей эффективностью и простотой использования.
Основные возможности
- Поддержка предобученных моделей
- Механизм обработки на основе конвейера
- Высокопроизводительная реализация нейронных сетей
- Многоязычная поддержка (включая китайский)
Установка и базовое использование
Пример
# Установка китайской модели: python -m spacy download zh_core_web_sm
import spacy
# Загрузить английскую модель
nlp = spacy.load("en_core_web_sm")
doc = nlp("Apple is looking at buying U.K. startup for $1 billion")
# Извлечение именованных сущностей
for ent in doc.ents:
print(ent.text, ent.label_)
# Вывод: Apple ORG
# U.K. GPE
# $1 billion MONEY
Сравнение производительности
Пример
title Сравнение скорости обработки библиотек NLP (слов/секунду)
x-axis Библиотека
y-axis Скорость
bar NLTK: 10,000
bar spaCy: 100,000
jieba: мощный инструмент для сегментации китайских слов
Базовое введение
jieba — это инструмент сегментации слов, специально разработанный для китайского языка, известный своей простотой использования, эффективностью и точностью.
Три режима сегментации слов
- Точный режим: наиболее точный результат сегментации
- Полный режим: сканирует все возможные варианты слов
- Режим поисковой системы: дополнительно сегментирует длинные слова
Примеры базового использования
Пример
# Токенизация в точном режиме
seg_list = jieba.cut("I love natural language processing", cut_all=False)
print("Точный режим: " + "/".join(seg_list))
# Вывод: Точный режим: I/love/natural language/processing
# Добавить пользовательский словарь
jieba.load_userdict("userdict.txt") # Пользовательский файл словаря
Расширенные функции
- Извлечение ключевых слов
- Разметка частей речи
- Параллельная сегментация слов (повышает скорость обработки больших текстов)
HanLP: комплексное решение для NLP на китайском языке
Базовое введение
HanLP — это набор инструментов NLP, состоящий из серии моделей и алгоритмов, цель которого — содействовать применению обработки естественного языка в производственных средах.
Функции и характеристики
- Поддерживает несколько режимов сегментации слов
- Распознавание именованных сущностей
- Анализ зависимостей
- Классификация текста
- Анализ тональности
Примеры базового использования
Пример
# Пример сегментации слов
print(HanLP.segment('Привет, добро пожаловать в HanLP!'))
# Вывод: [hello/vl, ,/w, welcome/v, use/v, HanLP/nx, !/w]
# Синтаксический анализ зависимостей
sentence = HanLP.parseDependency("Я люблю обработку естественного языка")
print(sentence)
Многоязычная поддержка
HanLP поддерживает не только китайский, но и:
- Английский
- Японская
- Корейский
- и многие другие языки
Руководство по выбору инструментов
Сравнение сценариев применения
| Инструмент | Наиболее подходящие сценарии использования | Поддержка китайского языка | Кривая обучения |
|---|---|---|---|
| NLTK | Академические исследования, преподавание | Ограниченно | Умеренный |
| spaCy | Промышленные применения, производственные среды | Хороший | Gentle |
| jieba | Задачи сегментации китайских слов | Отличный | Простая |
| HanLP | Сложные задачи обработки естественного языка на китайском | Отличный | Более крутая |
Соображения производительности
- Скорость обработки:spaCy > jieba > HanLP > NLTK
- Использование памяти:HanLP > spaCy > NLTK > jieba
- Точность(для китайского): HanLP ≈ jieba > spaCy > NLTK
Комплексный практический пример: конвейер анализа китайского текста
Пример
import jieba
from hanlp import HanLP
import spacy
text = "Обработка естественного языка — важная отрасль искусственного интеллекта, бурно развивающаяся в последние годы."
# 1. Использование jieba для сегментации слов
words = list(jieba.cut(text))
print("результат токенизации:", words)
# 2. Использование HanLP для разметки частей речи
print("\nРазметка частей речи:")
print(HanLP.segment(text))
# 3. Использование английской модели spaCy для обработки английской части
nlp = spacy.load("en_core_web_sm")
doc = nlp("Обработка естественного языка впечатляет.")
print("\nРаспознавание английских сущностей:")
for ent in doc.ents:
print(ent.text, ent.label_)
Рекомендуемые учебные ресурсы
Официальная документация
- NLTK: https://www.nltk.org/
- spaCy: https://spacy.io/
- jieba: https://github.com/fxsjy/jieba
- HanLP: https://hanlp.hankcs.com/
Итоги и перспективы
Экосистема Python NLP предоставляет полный набор инструментов, охватывающий от академических исследований до промышленных приложений. Для обработки китайского текста jieba и HanLP являются незаменимыми инструментами, тогда как spaCy превосходит в многоязычной поддержке и промышленном развёртывании. Будущее развитие NLP будет уделять больше внимания:
- Применение предобученных языковых моделей (таких как BERT, GPT)
- Возможности мультимодальной обработки
- Поддержка малоресурсных языков
- Интерпретируемость и справедливость