Text-Klassifizierung
Die Textklassifikation ist eine der grundlegendsten und wichtigsten Aufgaben im Bereich der Verarbeitung natürlicher Sprache (NLP). Ihr Ziel ist es, ein gegebenes Textdokument automatisch in eine oder mehrere vordefinierte Kategorien einzuordnen.
Grundlegende Konzepte
Die Textklassifikation ist wie ein Bibliothekar, der Bücher anhand ihres Inhalts kategorisieren und in die richtigen Regale stellen muss. Im Bereich der Informatik müssen wir Maschinen beibringen, Textinhalte zu verstehen und korrekte Klassifizierungsentscheidungen zu treffen.
Anwendungsszenarien
Die Textklassifikation hat in der modernen Gesellschaft ein breites Anwendungsspektrum:
- Sentimentanalyse: Bestimmen, ob eine Bewertung positiv oder negativ ist
- Spam-Filterung: Zwischen normalen E-Mails und Spam unterscheiden
- Nachrichtenklassifikation: Nachrichten in Rubriken wie Sport, Finanzen und Technologie einordnen
- Absichtserkennung: die wahre Absicht von Benutzeranfragen verstehen
- Medizinische Diagnose: Krankheitstypen anhand von Symptombeschreibungen klassifizieren
Grundlegender Workflow der Textklassifikation
Ein vollständiges Textklassifikationssystem umfasst typischerweise die folgenden Schritte:
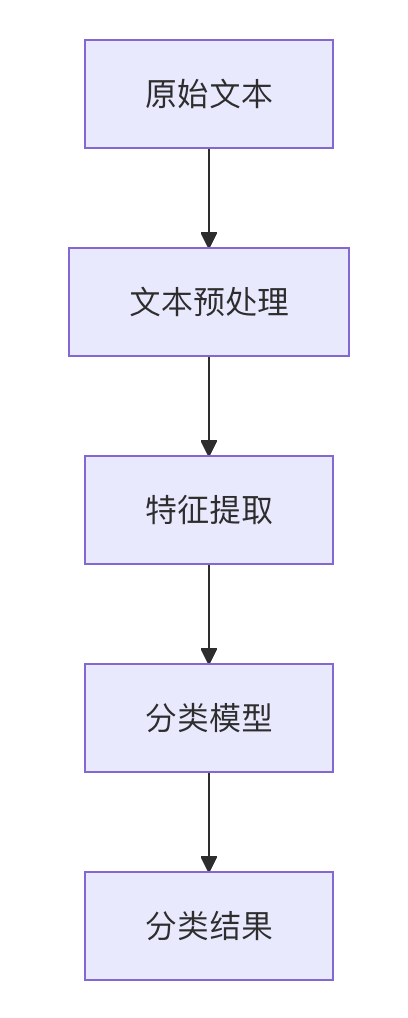
1. Textvorverarbeitung
Die Textvorverarbeitung wandelt Rohtext in eine Form um, die für maschinelle Lernmodelle zur Verarbeitung geeignet ist:
Beispiel
import nltk
from nltk.corpus import stopwords
from nltk.stem import PorterStemmer
def preprocess_text(text):
# In Kleinbuchstaben umwandeln
text = text.lower()
# Sonderzeichen und Zahlen entfernen
text = re.sub(r'[^a-zA-Z\s]', '', text)
# Tokenisierung
words = text.split()
# Stoppwörter entfernen
stop_words = set(stopwords.words('english'))
words = [word for word in words if word not in stop_words]
# Wortstammbildung
stemmer = PorterStemmer()
words = [stemmer.stem(word) for word in words]
return ' '.join(words)
2. Merkmalsextraktion
Text in numerische Merkmalsrepräsentationen umwandeln. Gängige Methoden sind:
| Methode | Beschreibung | Vorteile | Nachteile |
|---|---|---|---|
| Bag of Words (BoW) | Zählt Worthäufigkeit | Einfach und intuitiv | Ignoriert Wortreihenfolge und Semantik |
| TF-IDF | Berücksichtigt Wortwichtigkeit | Genauer als BoW | Ignoriert weiterhin den Kontext |
| Word2Vec | Wortvektor-Repräsentationen | Erfasst semantische Beziehungen | Kann mehrdeutige Wörter nicht verarbeiten |
| BERT | Kontextuelle Embeddings | Modernste Repräsentation | Hohe Anforderungen an Rechenressourcen |
3. Auswahl des Klassifikationsmodells
Wählen Sie einen geeigneten Klassifikationsalgorithmus basierend auf den Aufgabenanforderungen und Datenmerkmalen:
Traditionelle Methoden des maschinellen Lernens:
- Naive Bayes
- Support-Vektor-Maschine (SVM)
- Logistische Regression
- Random Forest
Deep-Learning-Methoden:
- Faltungsneuronales Netz (CNN)
- Rekurrentes neuronales Netz (RNN/LSTM)
- Transformer-Modelle (BERT usw.)
Praktisches Beispiel: Nachrichtenklassifikation
Lassen Sie uns anhand eines praktischen Beispiels zeigen, wie man Textklassifikation mit Python implementiert. Wir verwenden den 20 Newsgroups-Datensatz, einen klassischen Datensatz zur Nachrichtenklassifikation.
1. Datenvorbereitung
Beispiel
# Wählen Sie 4 Kategorien als Beispiel
categories = ['alt.atheism', 'soc.religion.christian', 'comp.graphics', 'sci.med']
# Trainings- und Testsets laden
newsgroups_train = fetch_20newsgroups(subset='train', categories=categories)
newsgroups_test = fetch_20newsgroups(subset='test', categories=categories)
print(f"Anzahl der Trainingsbeispiele: {len(newsgroups_train.data)}")
print(f"Anzahl der Testbeispiele: {len(newsgroups_test.data)}")
2. Merkmalsextraktion (TF-IDF)
Beispiel
# TF-IDF-Vektorisierer erstellen
vectorizer = TfidfVectorizer(max_features=5000)
# Trainings- und Testsets transformieren
X_train = vectorizer.fit_transform(newsgroups_train.data)
X_test = vectorizer.transform(newsgroups_test.data)
y_train = newsgroups_train.target
y_test = newsgroups_test.target
3. Modelltraining (Logistische Regression)
Beispiel
from sklearn.metrics import accuracy_score, classification_report
# Modell erstellen und trainieren
model = LogisticRegression(max_iter=1000)
model.fit(X_train, y_train)
# Vorhersage auf dem Testset
y_pred = model.predict(X_test)
# Modell bewerten
print(f"Genauigkeit: {accuracy_score(y_test, y_pred):.2f}")
print("\nKlassifikationsbericht:)
print(classification_report(y_test, y_pred, target_names=newsgroups_test.target_names))
4. Ergebnisanalyse
Eine typische Ausgabe könnte so aussehen:
准确率: 0.91

分类报告:
                        precision    recall  f1-score   support

           alt.atheism       0.90      0.87      0.89       319
soc.religion.christian       0.93      0.95      0.94       389
         comp.graphics       0.89      0.90      0.90       396
               sci.med       0.92      0.91      0.92       398

              accuracy                           0.91      1502
             macro avg       0.91      0.91      0.91      1502
          weighted avg       0.91      0.91      0.91      1502
Fortgeschrittene Techniken und Herausforderungen
Umgang mit Klassenungleichgewicht
Wenn einige Kategorien deutlich mehr Beispiele als andere haben, können Sie versuchen:
- Resampling (Überabtastung der Minderheitsklasse oder Unterabtastung der Mehrheitsklasse)
- Verwendung von Klassengewichten
- Verschiedene Evaluierungsmetriken ausprobieren (wie F1-Score statt Genauigkeit)
Methoden zur Verbesserung der Modellleistung
Feature-Engineering:
- Verschiedene n-gram-Bereiche ausprobieren
- Part-of-Speech-Merkmale hinzufügen
- Fortgeschrittenere Word-Embeddings verwenden
Modelloptimierung:
- Hyperparameter-Tuning
- Modell-Ensembling
- Deep-Learning-Modelle ausprobieren
Datenaugmentierung:
- Rückübersetzung
- Synonymersetzung
- Generatives adversarisches Netzwerk (GAN)
Häufige Herausforderungen
- Multi-Label-Klassifikation: Ein Dokument kann zu mehreren Kategorien gehören
- Domänenanpassung: Die Modellleistung verschlechtert sich in neuen Domänen
- Few-Shot-Learning: Situationen mit begrenzten annotierten Daten
- Interpretierbarkeit: Verstehen, warum das Modell eine bestimmte Klassifikationsentscheidung trifft
Zusammenfassung und Lernpfad
Textklassifikation ist eine grundlegende NLP-Aufgabe, und ihre Beherrschung ist entscheidend für das Verständnis komplexerer NLP-Anwendungen. Empfohlener Lernpfad:
- Beginnen Sie mit traditionellen Machine-Learning-Methoden (wie TF-IDF + SVM)
- Verstehen Sie die Konzepte und Anwendungen von Word Embeddings (Word2Vec, GloVe)
- Erfahren Sie mehr über die Anwendung von Deep-Learning-Modellen (CNN, LSTM) in der Textklassifikation
- Erkunden Sie Transfer Learning mit vortrainierten Sprachmodellen (BERT, GPT)
Durch kontinuierliche Übung und das Ausprobieren verschiedener Methoden werden Sie in der Lage sein, leistungsstarke und praktische Textklassifikationssysteme zu erstellen.
Andere Erweiterungen