Архитектура Transformer
Архитектура Transformer — это модель глубокого обучения, основанная на механизме самовнимания, предложенная командой Google в статье 2017 года《Attention Is All You Need》, в которой она была впервые предложена.
Transformer полностью преобразил область обработки естественного языка (NLP) и стал ключевой основой современных больших языковых моделей (таких как GPT, BERT и т. д.).
Подобно рекуррентным нейронным сетям (RNN), Transformer предназначен для обработки последовательных входных данных, таких как естественный язык, и подходит для таких задач, как машинный перевод и суммирование текста. Однако, в отличие от RNN, Transformer не нуждается в пошаговой обработке последовательностей; вместо этого он может обрабатывать весь входной сигнал параллельно за один раз.
Эта глава глубоко погрузит вас в основные идеи, архитектуру и принципы работы Transformer, помогая вам освоить основы этой революционной технологии.
Схема архитектуры Transformer
Слева находится энкодер, а справа — декодер.
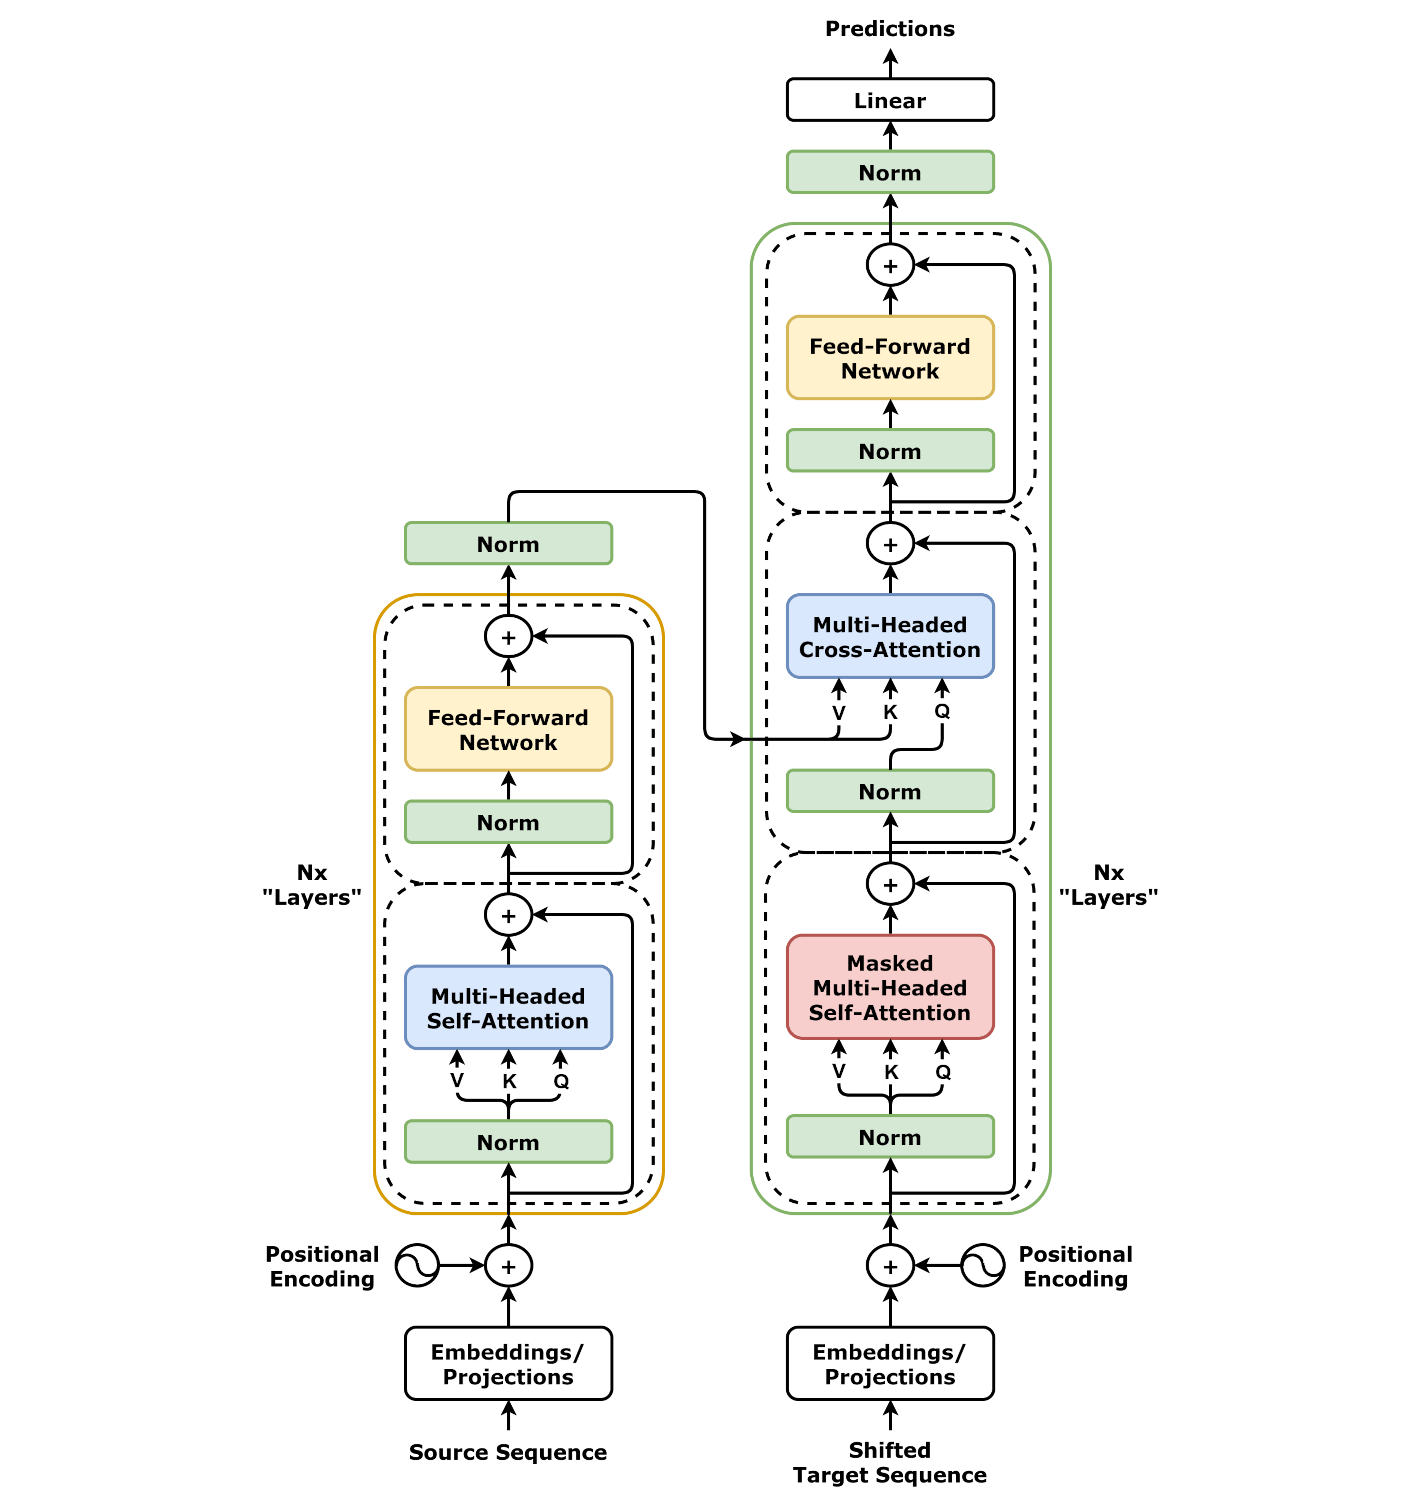
1. Обработка входных данных (внизу)
- Эмбеддинги/проекции (слой эмбеддингов/проекций)
- Функция: преобразует входные слова (или токены) в числовые векторы (например, «кошка» → [0.2, -0.5, 0.7…]).
- Аналогия: это как присвоить каждому слову уникальный «ID-номер», но умнее (он содержит семантическую информацию).
2. Энкодер (слева)
-
Многоголовое самовнимание (multi-head self-attention)
- Функция: позволяет модели одновременно учитывать все слова во входе и вычислять их взаимосвязи.
- Пример: в предложении «кошка преследует мышь» модель узнаёт, что «кошка» и «мышь» связаны сильнее, чем «кошка» и «преследует».
- Ключевой момент:Обрабатывает все слова параллельно, в отличие от RNN, которая должна вычислять их по одному.
-
Норма (нормализация слоя)
- Функция: стабилизирует процесс обучения и не даёт значениям становиться слишком большими или слишком маленькими (похоже на настройку «громкости» до подходящего диапазона).
-
Сеть прямого распространения
- Функция: дополнительно обрабатывает представление каждого слова (например, извлекает более сложные признаки).
- Аналогия: это как выполнить углублённую интерпретацию вектора для «cat» и добавить детали (например, «кошка — млекопитающее»).
3. Декодер (справа)
-
Маскированное многоголовое самовнимание
- Функция: не позволяет модели «жульничать» во время обучения (она может видеть только текущее и предыдущие слова, но не будущие).
- Пример: при генерации «Я люблю __» модель может предсказать следующее слово только на основе «Я» и «люблю» и не может заранее знать, что ответ — «ты».
-
Многоголовое кросс-внимание
- Функция: позволяет декодеру спросить у энкодера: «На что мне следует обратить внимание во входных данных?»
- Сценарий: в задачах перевода, когда декодер генерирует английский текст, он обращается к китайскому входному тексту, обработанному энкодером.
-
Нормализация и сеть прямого распространения
- Подобно энкодеру, она нормализует и глубоко обрабатывает представления декодера.
4. Выход (сверху)
- Линейный слой (Linear Layer)
- Функция: отображает выход декодера в словарь (например, предсказывает, что следующее слово — «you», с наибольшей вероятностью).
- Пример: при входе «I love,» модель может выдать вероятность 80% для «you» и 10% для «eat»...
Основная идея Transformer
Механизм самовнимания
Основная идея Transformer — полностью полагаться на механизм внимания (без рекуррентных или свёрточных структур) для захвата глобальных зависимостей во входной последовательности, что обеспечивает эффективные параллельные вычисления и более сильное моделирование дальних зависимостей.
Пример
def self_attention(query, key, value):
scores = torch.matmul(query, key.transpose(-2, -1)) # Вычисление сходства
weights = torch.softmax(scores, dim=-1) # Преобразовать в распределение вероятностей
output = torch.matmul(weights, value) # Взвешенная сумма
return output
Формула:
\[ \text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V \]
- \(Q\) (Query), \(K\) (Key) и \(V\) (Value) — это матрицы, полученные линейными преобразованиями входа.
- \(\sqrt{d_k}\) — это масштабирующий коэффициент, который предотвращает слишком большое скалярное произведение, что приводило бы к исчезновению градиента.
Многоголовое внимание
- Запускает механизм самовнимания несколько раз параллельно (несколько «голов»), каждая голова изучает свой паттерн внимания, и в конце результаты конкатенируются.
- Преимущество: захват более богатой контекстной информации (например, локальных/глобальных зависимостей, синтаксических/семантических признаков).
Позиционное кодирование
- Сам Transformer не имеет рекуррентной или свёрточной структуры и не может напрямую воспринимать порядок последовательности, поэтому позиционную информацию необходимо явно внедрять.
- Используйте синусоидальные/косинусоидальные функции или обучаемое позиционное кодирование:
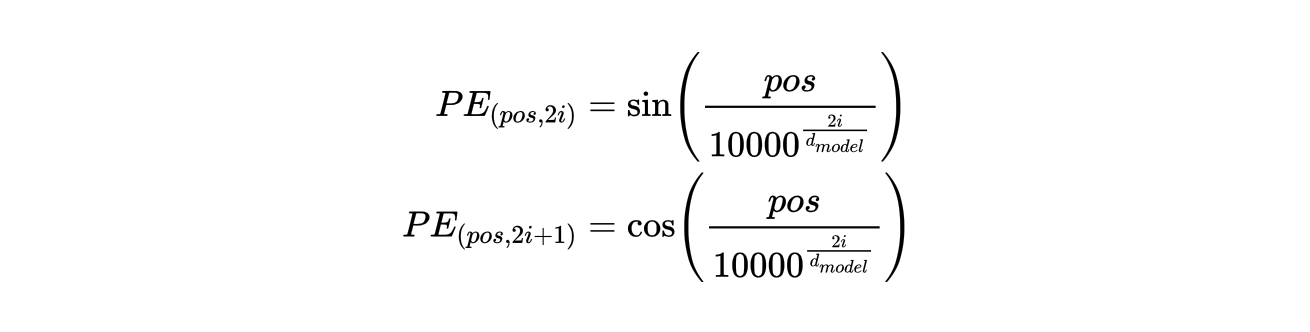
Сеть прямого распространения (FFN)
- Представление в каждой позиции дополнительно преобразуется двухслойной полносвязной сетью (с нелинейной активацией, например ReLU).
- Формула: \( \text{FFN}(x) = \max(0, xW_1 + b_1)W_2 + b_2 \).
Остаточное соединение и нормализация слоя
- Остаточное соединение: добавляет вход напрямую к выходу (например, \( x + \text{Sublayer}(x) \)), чтобы ослабить исчезновение градиента.
- Нормализация слоя: нормализует выход каждого слоя, чтобы ускорить обучение.
Возможность параллельной обработки
В отличие от традиционных RNN/LSTM, Transformer может обрабатывать всю последовательность параллельно, значительно повышая эффективность обучения.
Моделирование глобальных зависимостей
Независимо от того, насколько далеко расположены слова, Transformer может напрямую устанавливать зависимости между ними, решая проблему дальних зависимостей.
Архитектура энкодер-декодер
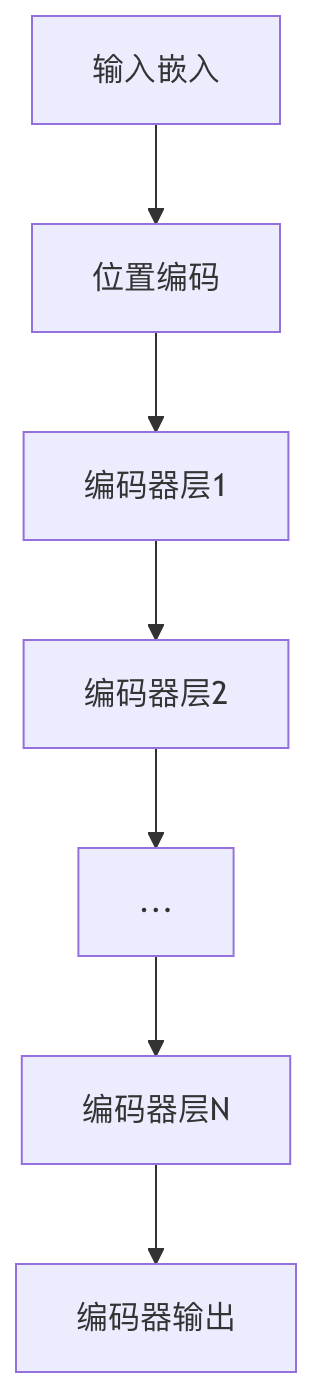
Transformer использует классическую архитектуру энкодер-декодер, но каждая часть состоит из нескольких составленных в стек одинаковых модулей.
Энкодер
| Компонент | Описание функций | Важность |
|---|---|---|
| Многоголовое внимание | Захватывает семантическую информацию из разных подпространств | ★★★★★ |
| Сеть прямого распространения | Нелинейное преобразование и извлечение признаков | ★★★★ |
| Остаточное соединение | Смягчает проблему исчезающего градиента | ★★★★ |
| Нормализация слоя | Стабилизирует процесс обучения | ★★★★ |
Декодер
Декодер добавляет следующее поверх энкодера:
- Маскированное многоголовое внимание: не позволяет текущей позиции обращать внимание на будущую информацию
- Внимание энкодер-декодер: интегрирует информацию исходного языка
Позиционное кодирование
Поскольку Transformer не имеет рекуррентной структуры, позиционную информацию необходимо явно внедрять.
Формула синусоидального позиционного кодирования
Формула делится на две части, соответствующие чётным и нечётным размерностям вектора позиционного кодирования:Чётные размерности (2i),Нечётные размерности (2i+1)。
Описание параметра:
pos: Позиция слова в последовательности (например, 1-е слово, 2-е слово и т. д.).i: Индекс размерности вектора позиционного кодирования (0 ≤ i < d_model/2)。d_model: Размерность позиционного кодирования (обычно совпадает с размерностью вектора слова, например 512, 768 и т. д.).
Характеристики позиционного кодирования
- Чувствительность к относительной позиции: Может изучать относительные позиционные связи
- Расширяемая длина: Может обрабатывать последовательности длиннее, чем те, что встречались при обучении
- Детерминированность: Не требует обучения, вычисляется напрямую
Пример
class PositionalEncoding(nn.Module):
def __init__(self, d_model, max_len=5000):
super().__init__()
position = torch.arange(max_len).unsqueeze(1)
div_term = torch.exp(torch.arange(0, d_model, 2) * (-math.log(10000.0) / d_model))
pe = torch.zeros(max_len, d_model)
pe[:, 0::2] = torch.sin(position * div_term)
pe[:, 1::2] = torch.cos(position * div_term)
self.register_buffer('pe', pe)
Преимущества трансформера
Сравнение с традиционными архитектурами
| Характеристики | Трансформер | RNN/LSTM | CNN |
|---|---|---|---|
| Параллелизм | Полная параллельность | Обработка последовательностей | Локальная параллельность |
| Дальние зависимости | Прямое моделирование | Пошаговая передача | Ограниченное рецептивное поле |
| Скорость обучения | Высокая | Медленная | Средняя |
| Потребление памяти | Относительно высокая | Средняя | Низкая |
Преимущества практического применения
- Выдающаяся производительность: Достигает передовых результатов в большинстве задач NLP
- Масштабируемость: Масштаб модели можно легко увеличить (например, GPT-3)
- Мультимодальная адаптация: Может применяться к различным типам данных, таким как текст, изображения и речь
- Дружественный к transfer learning: Парадигма предварительного обучения + тонкой настройки очень эффективна
Практические упражнения
Упражнение 1: Реализуйте базовый механизм самовнимания
Пример
import torch.nn.functional as F
def scaled_dot_product_attention(Q, K, V, mask=None):
d_k = Q.size(-1)
scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(d_k)
if mask is not None:
scores = scores.masked_fill(mask == 0, -1e9)
weights = F.softmax(scores, dim=-1)
return torch.matmul(weights, V)
Упражнение 2: Понимание позиционного кодирования
- Визуализируйте векторы позиционного кодирования в разных позициях
- Вычислите сходство между позиционными кодировками и наблюдайте позиционные связи
Часто задаваемые вопросы
Вопрос: Почему Transformer лучше подходит для длинного текста, чем RNN?Ответ: RNN должен передавать информацию шаг за шагом, и дальние зависимости легко теряются; Transformer же может напрямую устанавливать связи между любыми двумя словами.
Вопрос: Почему для позиционного кодирования выбрана функция синуса?Ответ: Функция синуса периодична, может представлять относительные позиционные связи и может быть расширена на длины последовательностей, не встречавшиеся при обучении.
Вопрос: Где находится основное вычислительное узкое место Transformer?Ответ: Пространственная сложность механизма самовнимания составляет O(n²), что потребляет большой объём памяти при обработке длинных последовательностей.
Итог
Архитектура Transformer коренным образом преобразила моделирование последовательностей благодаря механизму самовнимания. Её ключевые преимущества:
- Мощная способность к параллельным вычислениям
- Эффективное моделирование долгосрочных зависимостей
- Гибкая масштабируемость
- Отличная производительность
Освоение основ Transformer — важная база для изучения современных технологий NLP и ключ к пониманию передовых моделей, таких как BERT и GPT.
Другие расширения