Вычисление сходства текстов в NLP
Вычисление сходства текстов — это фундаментальная задача в обработке естественного языка (NLP), направленная на количественную оценку степени сходства между двумя текстовыми фрагментами. Эта технология широко применяется в различных областях, таких как информационный поиск, системы вопросов и ответов, обнаружение плагиата и рекомендательные системы.
Основные концепции
- Семантическое сходство: измеряет, насколько близки тексты по смыслу
- Буквальное сходство: измеряет степень пересечения поверхностной лексики текстов
- Модель векторного пространства: представляет тексты как векторы в многомерном пространстве
- Метрики расстояния: вычисляет расстояние или сходство между векторами
Распространённые методы вычисления сходства текстов
1. Методы на основе частоты слов
Модель мешка слов
Пример
from sklearn.feature_extraction.text import CountVectorizer
корпус = [
'Мне нравится обработка естественного языка',
'Я люблю изучать технологии NLP',
'Вычисление сходства текстов очень интересно'
]
vectorizer = CountVectorizer()
X = vectorizer.fit_transform(corpus)
print(X.toarray())
корпус = [
'Мне нравится обработка естественного языка',
'Я люблю изучать технологии NLP',
'Вычисление сходства текстов очень интересно'
]
vectorizer = CountVectorizer()
X = vectorizer.fit_transform(corpus)
print(X.toarray())
Метод TF-IDF
Пример
from sklearn.feature_extraction.text import TfidfVectorizer
tfidf = TfidfVectorizer()
tfidf_matrix = tfidf.fit_transform(corpus)
print(tfidf_matrix.toarray())
tfidf = TfidfVectorizer()
tfidf_matrix = tfidf.fit_transform(corpus)
print(tfidf_matrix.toarray())
2. Методы на основе векторных представлений слов
Сходство Word2Vec
Пример
from gensim.models import Word2Vec
sentences = [
['I','like','natural language processing'],
['I','love','learning','NLP','technology'],
['text','similarity','calculation','very','interesting']
]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1, workers=4)
vector = model.wv['natural language processing'] # Получить векторы слов
sentences = [
['I','like','natural language processing'],
['I','love','learning','NLP','technology'],
['text','similarity','calculation','very','interesting']
]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1, workers=4)
vector = model.wv['natural language processing'] # Получить векторы слов
Вычисление вектора предложения
Пример
import numpy as np
def sentence_vector(sentence, model):
vectors = [model.wv[word] for word in sentence if word in model.wv]
return np.mean(vectors, axis=0) if vectors⟧ else np.zeros(model⟧vector_sizevector_size)
sentence_vec = sentence_vector(['I','like','natural language processing'], model)
sentence_vec2 = sentence_vector(['I','love','NLP'], model)
def sentence_vector(sentence, model):
vectors = [model.wv[word] for word in sentence if word in model.wv]
return np.mean(vectors, axis=0) if vectors⟧ else np.zeros(model⟧vector_sizevector_size)
sentence_vec = sentence_vector(['I','like','natural language processing'], model)
sentence_vec2 = sentence_vector(['I','love','NLP'], model)
3. Методы на основе предобученных моделей
Вычисление схожести BERT
Пример
from transformers import BertTokenizer, BertModel
import torch
tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')
model = BertModel.from_pretrained('bert-base-chinese')
inputs = tokenizer("This is an example sentence", return_tensors="pt")
outputs = model(**inputs)
last_hidden_states = outputs.last_hidden_state
import torch
tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')
model = BertModel.from_pretrained('bert-base-chinese')
inputs = tokenizer("This is an example sentence", return_tensors="pt")
outputs = model(**inputs)
last_hidden_states = outputs.last_hidden_state
Метрики сходства
Общие метрики расстояния
| Название метода | Формула | Характеристики |
|---|---|---|
| Косинусное сходство | cos(θ) = (A·B)/(|A||B|) | Игнорирует длину вектора, фокусируется на направлении |
| Евклидово расстояние | √Σ(Ai-Bi)² | Учитывает абсолютное положение векторов |
| Манхэттенское расстояние | Σ|Ai-Bi| | Не чувствительно к выбросам |
| Сходство Жаккара | |A∩B|/|A∪B| | Подходит для оценки сходства множеств |
Примеры реализации кода
Пример
from sklearn.metrics.pairwise import cosine_similarity
# Вычислить косинусное сходство
similarity = cosine_similarity(tfidf_matrix[0:1], tfidf_matrix[1:2])
print(f"Text similarity: {similarity)
# Вычислить косинусное сходство
similarity = cosine_similarity(tfidf_matrix[0:1], tfidf_matrix[1:2])
print(f"Text similarity: {similarity)
Примеры практического применения
Обнаружение сходства новостных заголовков
Пример
import pandas as pd
from sklearn.metrics.pairwise import cosine_similarity
# Пример данных
titles = [
"Apple выпускает новый iPhone",
"Apple Inc. выпускает новейший смартфон",
"Microsoft объявляет квартальный отчет о прибыли",
"Google объявляет новый план по искусственному интеллекту"
]
# Вычислить матрицу сходства
tfidf = TfidfVectorizer()
tfidf_matrix = tfidf.fit_transform(titles)
similarities = cosine_similarity(tfidf_matrix)
# Показать результаты
df = pd.DataFrame(similarities, columns=titles, index=titles)
print(df)
from sklearn.metrics.pairwise import cosine_similarity
# Пример данных
titles = [
"Apple выпускает новый iPhone",
"Apple Inc. выпускает новейший смартфон",
"Microsoft объявляет квартальный отчет о прибыли",
"Google объявляет новый план по искусственному интеллекту"
]
# Вычислить матрицу сходства
tfidf = TfidfVectorizer()
tfidf_matrix = tfidf.fit_transform(titles)
similarities = cosine_similarity(tfidf_matrix)
# Показать результаты
df = pd.DataFrame(similarities, columns=titles, index=titles)
print(df)
Анализ результатов
                         苹果发布新款iPhone手机  苹果公司推出最新智能手机  微软公布季度财报  谷歌宣布新的人工智能计划
苹果发布新款iPhone手机           1.000000         0.723417     0.000000         0.000000
苹果公司推出最新智能手机         0.723417         1.000000     0.000000         0.000000
微软公布季度财报               0.000000         0.000000     1.000000         0.204598
谷歌宣布新的人工智能计划         0.000000         0.000000     0.204598         1.000000
Продвинутые методы и проблемы
1. Обработка текстов со схожей семантикой, но разной лексикой
Пример
text1 = "Я люблю кошек"
text2 = "Я ненавижу собак"
# Поверхностное сходство низкое, но оба семантически выражают отношение к животным
text2 = "Я ненавижу собак"
# Поверхностное сходство низкое, но оба семантически выражают отношение к животным
2. Решение проблемы многозначности
Пример
# "Apple" может означать фрукт или компанию
text1 = "Яблоко очень сладкое"
text2 = "Рыночная стоимость Apple достигает нового максимума"
text1 = "Яблоко очень сладкое"
text2 = "Рыночная стоимость Apple достигает нового максимума"
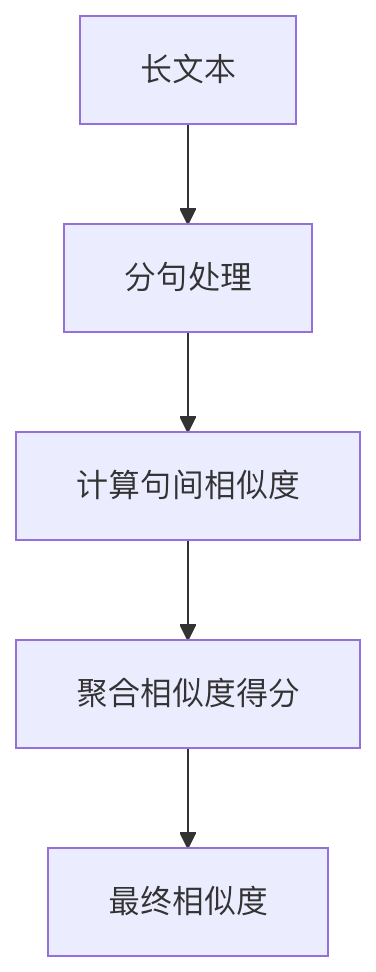
3. Вычисление сходства длинных текстов
Рекомендации по лучшим практикам
Предварительная обработка данных важна
- Нормализация регистра
- Удаление стоп-слов
- Стемминг / Лемматизация
Выбирайте методы в зависимости от сценария
- Короткие тексты: предобученные модели, такие как BERT
- Длинные документы: TF-IDF + косинусное сходство
- Системы реального времени: лёгкие модели, такие как Word2Vec
Учитывайте вычислительную эффективность
- Используйте алгоритмы приближённого поиска ближайших соседей (ANN) для крупномасштабных данных
- Рассмотрите использование эффективных библиотек поиска сходства, таких как Faiss
Непрерывная оценка и оптимизация
- Создайте набор для ручной оценки
- Отслеживайте производительность в продуктивных средах
- Регулярно обновляйте модели