Анализ тональности
Анализ тональности — одна из самых классических и широко применяемых задач в области обработки естественного языка (NLP). В нём используются вычислительные методы для автоматического выявления, извлечения и анализа субъективной информации в тексте, определения того, является ли отношение автора к конкретной теме, продукту или услуге положительным, отрицательным или нейтральным.
Основные типы анализа тональности
Классификация по гранулярности анализа
- Анализ тональности на уровне документа: Определяет тональную направленность всего документа как единого целого
- Анализ тональности на уровне предложения: Анализирует тональную полярность отдельного предложения
- Аспектный анализ тональности: Выносит тональные суждения о конкретных аспектах, упомянутых в тексте
Классификация по измерению тональности
- Бинарная классификация: Позитивная/Негативная
- Трёхклассовая классификация: Позитивная/Нейтральная/Негативная
- Многоклассовая классификация: Более детальная классификация тональности (например, гнев, радость, грусть и т. д.)
- Анализ интенсивности тональности: Количественно оценивает интенсивность тональности
Словарный метод анализа тональности
Словарный метод — это наиболее традиционная техника анализа тональности, основанная главным образом на заранее созданных словарях тональности.
Основные компоненты
Словарь тональности: набор слов с тональной полярностью и интенсивностью
- Распространённые английские словари: SentiWordNet, AFINN, VADER
- Распространённые китайские словари: словарь тональности HowNet, онтологическая база данных тональной лексики Даляньского технологического университета
Модификатор интенсивности: учитывает влияние наречий степени и слов отрицания
- Наречия степени: очень (1.5), довольно (1.3), немного (0.8) и т. д.
- Слова отрицания: не, нет, абсолютно не и т. д.
Базовый рабочий процесс
Пример
def lexicon_based_sentiment(text):
sentiment_score = 0
words = tokenize(text) # Сегментация слов
for word in words:
if word in positive_lexicon:
sentiment_score += positive_lexicon[word]
elif word negative_lexicon: negative_lexicon:
score -= negative_lexicon[word]
# Обработка отрицания и модификации степени
sentiment_score = apply(negation, sentiment_score)
sentiment_score = apply(intensifier, sentiment_score)
return normalize(sentiment_score)
Анализ преимуществ и недостатков
Преимущества:
- Не требует обучающих данных
- Высокая вычислительная эффективность
- Высокая интерпретируемость
Недостатки:
- Трудно обрабатывать сложные языковые явления (такие как сарказм, ирония)
- Зависит от покрытия и качества словаря
- Не может улавливать контекстную семантику
Метод анализа тональности на основе машинного обучения
Методы машинного обучения выполняют анализ тональности, изучая закономерности по размеченным данным.
Типичное конструирование признаков
- Модель мешка слов (BOW): представляет текст как вектор частот встречаемости слов
- TF-IDF: учитывает важность слов в документе
- N-граммные признаки: фиксируют локальные шаблоны последовательностей слов
- Признаки на основе словаря тональности: объединяют преимущества словарных методов
Основные алгоритмы
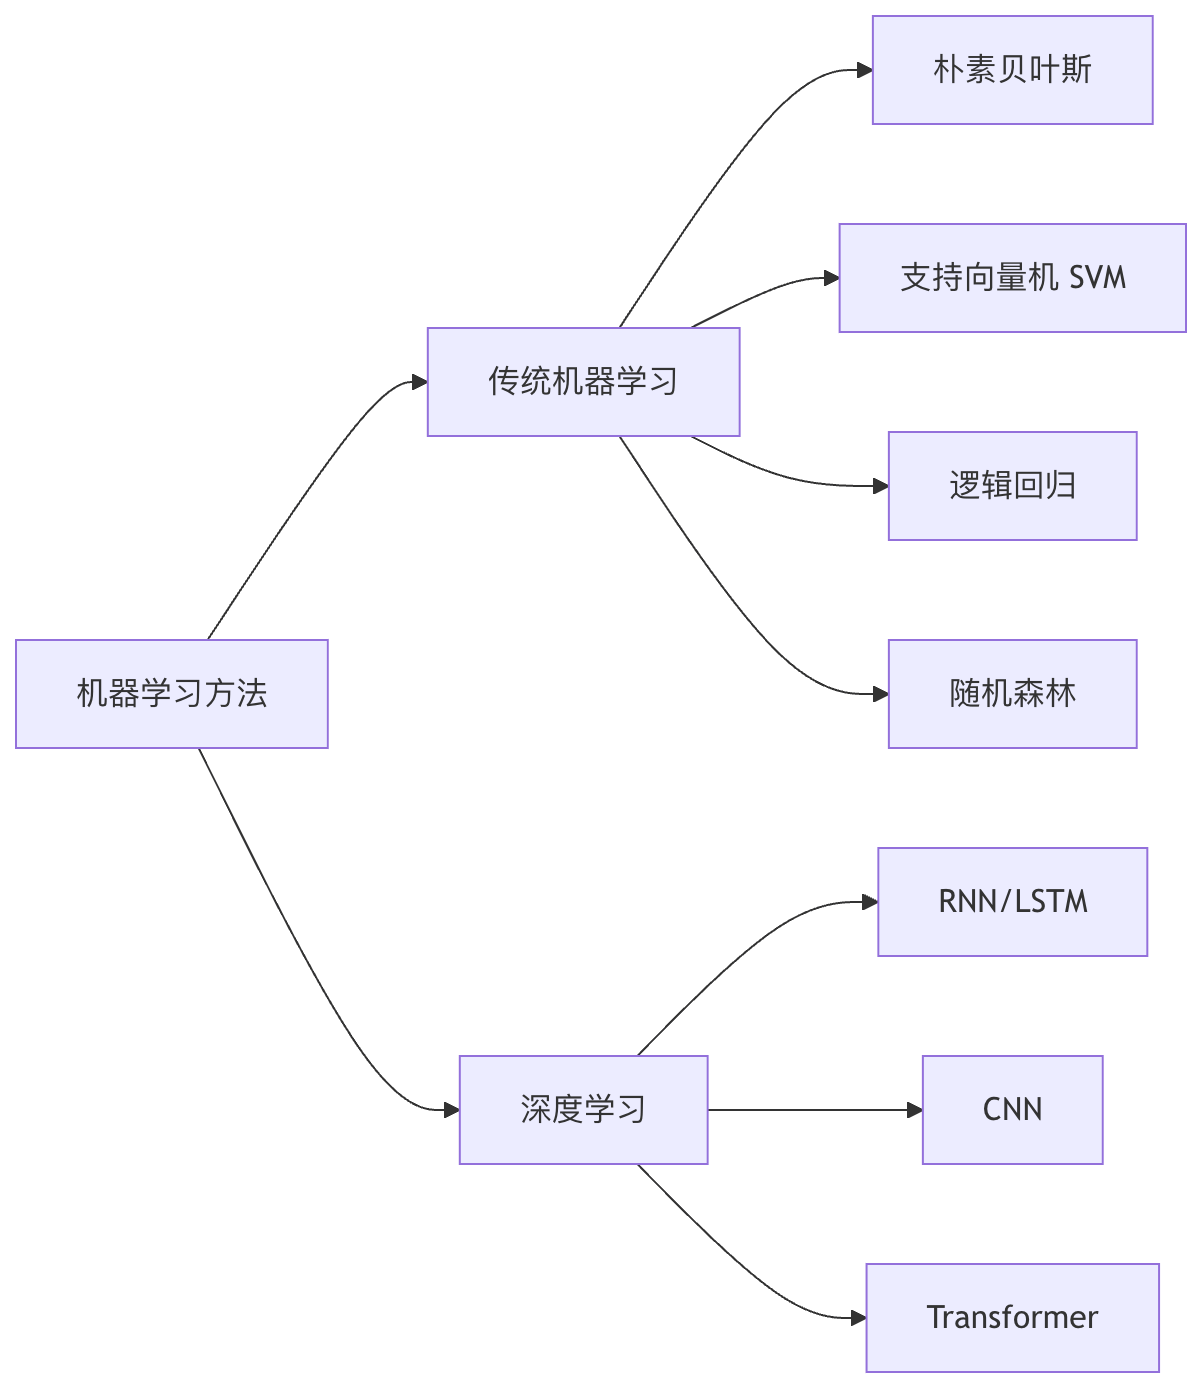
Пример кода: классификация тональности с помощью Scikit-learn
Пример
from sklearn.svm import LinearSVC
from sklearn.pipeline import Pipeline
# Построение конвейера классификации
sentiment_clf = Pipeline([
('tfidf', TfidfVectorizer(ngram_range=(1, 2))),
('clf', LinearSVC())
])
# Обучаем модель
sentiment_clf.fit(train_texts, train_labels)
# Предсказать новый текст
prediction = sentiment_clf.predict(["Этот продукт чрезвычайно прост в использовании, настоятельно рекомендую!"])
print(prediction) # Вывод: 'positive'
Детализированный анализ тональности
Аспектно-ориентированный анализ тональности (ABSA) — это более продвинутая задача анализа тональности, целью которой является выявление конкретных аспектов, упомянутых в тексте, и соответствующих им тональностей.
Основные подзадачи ABSA
Извлечение аспектов: Определяет сущности или атрибуты, обсуждаемые в тексте
- Явный аспект: "Время работы батареи телефона очень хорошее" → "батарея"
- Неявный аспект: "Сделанные фотографии очень четкие" → "камера"
Классификация тональности: Выносит суждения о тональности для каждого выявленного аспекта
Сравнение методов реализации
| Тип метода | Репрезентативная модель | Применимый сценарий | Преимущества | Недостатки |
|---|---|---|---|---|
| Конвейерный метод | Сначала используйте CRF для извлечения аспектов, затем используйте классификатор для определения тональности | Сценарии с ограниченными ресурсами | Понятные модули, легко отлаживать | Распространение ошибок |
| Сквозной метод | BERT-ABSA、AOA-LSTM | Высокие требования к точности | Совместная оптимизация, лучшая производительность | Требуется больше данных |
| Многозадачное обучение | MT-DNN, Multi-Task BERT | Помощь в связанных задачах | Обмен знаниями | Сложность балансировки задач |
Пример кода: аспектный анализ тональности на основе BERT
Пример
import torch
# Загрузить предварительно обученную модель
model = BertForSequenceClassification.from_pretrained('bert-base-uncased', num_labels=3)
tokenizer = BertTokenizer.from_pretrained('bert-base-uncased')
# Подготовить входные данные
text = "Обстановка в ресторане отличная, но обслуживание слишком медленное."
aspect = "обслуживание"
inputs = tokenizer(f"[CLS] {aspect} [SEP] {text} [SEP]", return_tensors="pt")
# Предсказание тональности
outputs = model(**inputs)
predictions = torch.argmax(outputs.logits, dim=1)
print(predictions) # Возможный вывод: 1 (негативный)
Проблемы и направления развития анализа тональности
Основные текущие проблемы
- Зависимость от контекста: одно и то же слово может иметь разную тональность в разных контекстах
- Адаптируемость к предметной области: модели, обученные в одной предметной области, работают хуже в других предметных областях
- Многоязычная обработка: выражение тональности сильно различается в разных языках
- Обнаружение сарказма и иронии: случаи, когда буквальный текст противоположен фактической тональности
Передовые направления развития
- Мультимодальный анализ тональности: объединяет несколько типов информации, таких как текст, изображения и речь
- Межъязыковой анализ тональности: использует сходства между языками для повышения производительности на малоресурсных языках
- Извлечение причин тональности: не только определяет тональность, но и анализирует причины
- Персонализированный анализ тональности: учитывает личные характеристики и историческое поведение пользователя
Практические упражнения
Упражнение 1: создание базового анализатора тональности
- Реализуйте простой анализатор тональности с использованием словаря VADER из NLTK
- Проверьте его точность на наборе данных с отзывами о фильмах
Упражнение 2: сравнение различных методов машинного обучения
- Обучите классификаторы тональности с использованием наивного байесовского классификатора, SVM и логистической регрессии соответственно
- Используйте перекрестную проверку для сравнения различий в их производительности
Упражнение 3: практика аспектно-ориентированного анализа тональности
- Дообучите предварительно обученную модель BERT на наборе данных отзывов о ресторанах SemEval 2014
- Реализуйте сквозную систему, которая может одновременно извлекать аспекты и определять тональность
Прочитав эту статью, вы должны были освоить основные концепции, главные методы и приемы реализации анализа тональности. Как фундаментальная задача NLP, технология анализа тональности продолжает развиваться и имеет широкую ценность в практических приложениях, играя важную роль от анализа отзывов о продуктах до мониторинга социальных сетей.
Другие расширения