Classification de texte
La classification de texte est l'une des tâches les plus fondamentales et importantes du traitement du langage naturel (NLP). Son objectif est de catégoriser automatiquement un document texte donné dans une ou plusieurs catégories prédéfinies.
Concepts de base
La classification de texte est comme un bibliothécaire qui doit catégoriser des livres et les placer sur les bonnes étagères en fonction de leur contenu. Dans le domaine de l'informatique, nous devons apprendre aux machines à comprendre le contenu textuel et à prendre des décisions de classification correctes.
Scénarios d'application
La classification de texte a un large éventail d'applications dans la société moderne :
- Analyse des sentiments: Déterminer si un avis est positif ou négatif
- Filtrage du spam: Distinguer les e-mails normaux des spams
- Classification des actualités: Catégoriser les actualités en rubriques telles que le sport, la finance et la technologie
- Reconnaissance d'intention: Comprendre la véritable intention des requêtes des utilisateurs
- Diagnostic médical: Classifier les types de maladies en fonction des descriptions des symptômes
Flux de travail de base de la classification de texte
Un système complet de classification de texte comprend généralement les étapes suivantes :
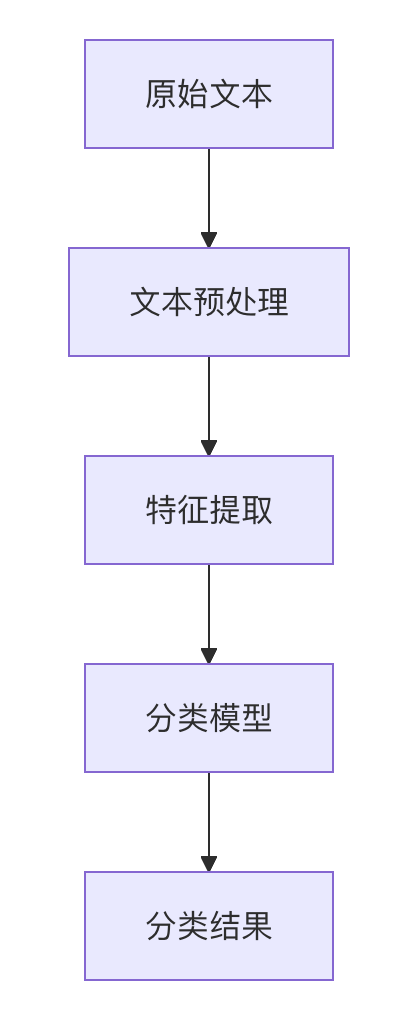
1. Prétraitement du texte
Le prétraitement du texte transforme le texte brut en une forme adaptée au traitement par les modèles d'apprentissage automatique :
Exemple
import nltk
from nltk.corpus import stopwords
from nltk.stem import PorterStemmer
def preprocess_text(text):
# Convertir en minuscules
text = text.lower()
# Supprimer les caractères spéciaux et les nombres
text = re.sub(r'[^a-zA-Z\s]', '', text)
# Tokenisation
words = text.split()
# Supprimer les mots vides
stop_words = set(stopwords.words('english'))
words = [word for word in words if word not in stop_words]
# Racinisation
stemmer = PorterStemmer()
words = [stemmer.stem(word) for word in words]
return ' '.join(words)
2. Extraction de caractéristiques
Convertir le texte en représentations numériques de caractéristiques. Les méthodes courantes incluent :
| Méthode | Description | Avantages | Inconvénients |
|---|---|---|---|
| Sac de mots (BoW) | Compte la fréquence des mots | Simple et intuitif | Ignore l'ordre des mots et la sémantique |
| TF-IDF | Tient compte de l'importance des mots | Plus précis que BoW | Ignore toujours le contexte |
| Word2Vec | Représentations vectorielles de mots | Capture les relations sémantiques | Ne gère pas les mots polysémiques |
| BERT | Plongements contextuels | Représentation de pointe | Exigences élevées en ressources de calcul |
3. Sélection du modèle de classification
Choisissez un algorithme de classification approprié en fonction des exigences de la tâche et des caractéristiques des données :
Méthodes traditionnelles d'apprentissage automatique:
- Bayes naïf
- Machine à vecteurs de support (SVM)
- Régression logistique
- Forêt aléatoire
Méthodes d'apprentissage profond:
- Réseau de neurones convolutif (CNN)
- Réseau de neurones récurrent (RNN/LSTM)
- Modèles Transformer (BERT, etc.)
Exemple pratique : classification d'actualités
Montrons comment implémenter la classification de textes en Python à l'aide d'un exemple pratique. Nous utiliserons le jeu de données 20 Newsgroups, un jeu de données classique de classification d'actualités.
1. Préparation des données
Exemple
# Sélectionner 4 catégories à titre d'exemple
categories = ['alt.atheism', 'soc.religion.christian', 'comp.graphics', 'sci.med']
# Charger les ensembles d'entraînement et de test
newsgroups_train = fetch_20newsgroups(subset='train', categories=categories)
newsgroups_test = fetch_20newsgroups(subset='test', categories=categories)
print(f"Nombre d'échantillons de l'ensemble d'entraînement: {len(newsgroups_train.data)}")
print(f"Nombre d'échantillons de l'ensemble de test: {len(newsgroups_test.data)}")
2. Extraction de caractéristiques (TF-IDF)
Exemple
# Créer un vectoriseur TF-IDF
vectorizer = TfidfVectorizer(max_features=5000)
# Transformer les ensembles d'entraînement et de test
X_train = vectorizer.fit_transform(newsgroups_train.data)
X_test = vectorizer.transform(newsgroups_test.data)
y_train = newsgroups_train.target
y_test = newsgroups_test.target
3. Entraînement du modèle (régression logistique)
Exemple
from sklearn.metrics import accuracy_score, classification_report
# Créer et entraîner le modèle
model = LogisticRegression(max_iter=1000)
model.fit(X_train, y_train)
# Prédire sur l'ensemble de test
y_pred = model.predict(X_test)
# Évaluer le modèle
print(f"Précision : {accuracy_score(y_test, y_pred):.2f}")
print("\nRapport de classification :)
print(classification_report(y_test, y_pred, target_names=newsgroups_test.target_names))
4. Analyse des résultats
Une sortie typique pourrait ressembler à ceci :
准确率: 0.91

分类报告:
                        precision    recall  f1-score   support

           alt.atheism       0.90      0.87      0.89       319
soc.religion.christian       0.93      0.95      0.94       389
         comp.graphics       0.89      0.90      0.90       396
               sci.med       0.92      0.91      0.92       398

              accuracy                           0.91      1502
             macro avg       0.91      0.91      0.91      1502
          weighted avg       0.91      0.91      0.91      1502
Techniques avancées et défis
Gestion du déséquilibre des classes
Lorsque certaines catégories ont beaucoup plus d'échantillons que d'autres, vous pouvez essayer :
- Rééchantillonnage (suréchantillonnage de la classe minoritaire ou sous-échantillonnage de la classe majoritaire)
- Utilisation des poids de classe
- Essayer différentes métriques d'évaluation (comme le score F1 au lieu de l'exactitude)
Méthodes pour améliorer les performances du modèle
Ingénierie des fonctionnalités:
- Essayer différentes plages de n-grammes
- Ajouter des caractéristiques morphosyntaxiques
- Utiliser des plongements de mots plus avancés
Optimisation du modèle:
- Réglage des hyperparamètres
- Assemblage de modèles
- Essayer des modèles d'apprentissage profond
Augmentation de données:
- Rétro-traduction
- Remplacement par synonymes
- Réseau antagoniste génératif (GAN)
Défis courants
- Classification multi-étiquettes: Un document peut appartenir à plusieurs catégories
- Adaptation de domaine: Les performances du modèle se dégradent dans de nouveaux domaines
- Apprentissage few-shot: Situations avec des données étiquetées limitées
- Interprétabilité: Comprendre pourquoi le modèle prend une décision de classification particulière
Résumé et parcours d'apprentissage
La classification de texte est une tâche fondamentale du TAL, et sa maîtrise est cruciale pour comprendre des applications du TAL plus complexes. Parcours d'apprentissage recommandé :
- Commencez par les méthodes traditionnelles d'apprentissage automatique (telles que TF-IDF + SVM)
- Comprenez les concepts et les applications des plongements de mots (Word2Vec, GloVe)
- Apprenez l'application des modèles d'apprentissage profond (CNN, LSTM) à la classification de texte
- Explorez l'apprentissage par transfert avec des modèles de langage pré-entraînés (BERT, GPT)
Grâce à une pratique continue et à l'essai de différentes méthodes, vous serez en mesure de construire des systèmes de classification de texte puissants et pratiques.
Autres extensions