Предобученные модели
Предобученные модели — одно из важнейших технологических достижений в области обработки естественного языка (NLP) за последние годы. Такие модели предварительно обучаются на крупномасштабных текстовых данных, чтобы освоить общие возможности представления языка, а затем их можно дообучить для конкретных задач.
Ключевая идея
- Двухэтапное обучение: сначала обучение на крупномасштабных общих данных, затем тонкая настройка на маломасштабных данных, специфичных для задачи
- Трансферное обучение: перенос общих языковых знаний на конкретные задачи
- Совместное использование параметров: один и тот же набор параметров модели может использоваться для нескольких нижестоящих задач
Сравнение с традиционными методами
| Характеристика | Традиционные модели NLP | Предобученные модели |
|---|---|---|
| Требования к данным | Требует большого количества размеченных данных | Требует лишь небольшого количества размеченных данных |
| Метод обучения | Обучение с нуля | Предварительное обучение + тонкая настройка |
| Способность к обобщению | Специфичный для задачи | Кросс-задачная обобщённость |
| Эффективность разработки | Низкая | Высокая |
История развития предобученных моделей
1. Эпоха словных эмбеддингов (2013-2017)
- Представительные модели:Word2Vec、GloVe、FastText
- Характеристики:
- Статическое векторное представление слов
- Не может обрабатывать многозначность
- Не зависит от контекста
Пример
# Пример Word2Vec
from gensim.models import Word2Vec
sentences = [["natural", "language", "processing"], ["pre-trained", "model", "is very powerful"]]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1)
print(model.wv["natural"]) # Вывод вектора слова
from gensim.models import Word2Vec
sentences = [["natural", "language", "processing"], ["pre-trained", "model", "is very powerful"]]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1)
print(model.wv["natural"]) # Вывод вектора слова
2. Эра контекстно-зависимых моделей (2018-2019)
- Репрезентативные модели:ELMo、ULMFiT
- Прорыв:
- Динамическое векторное представление слов
- Может обрабатывать многозначность
- Двунаправленная языковая модель
3. Эра Transformer (2019-настоящее время)
- Ключевые модели:BERT、GPT、T5
- Революционные улучшения:
- Основано на архитектуре Transformer
- Крупномасштабное предварительное обучение
- Сильная способность к переносу обучения
Основные архитектуры предварительно обученных моделей
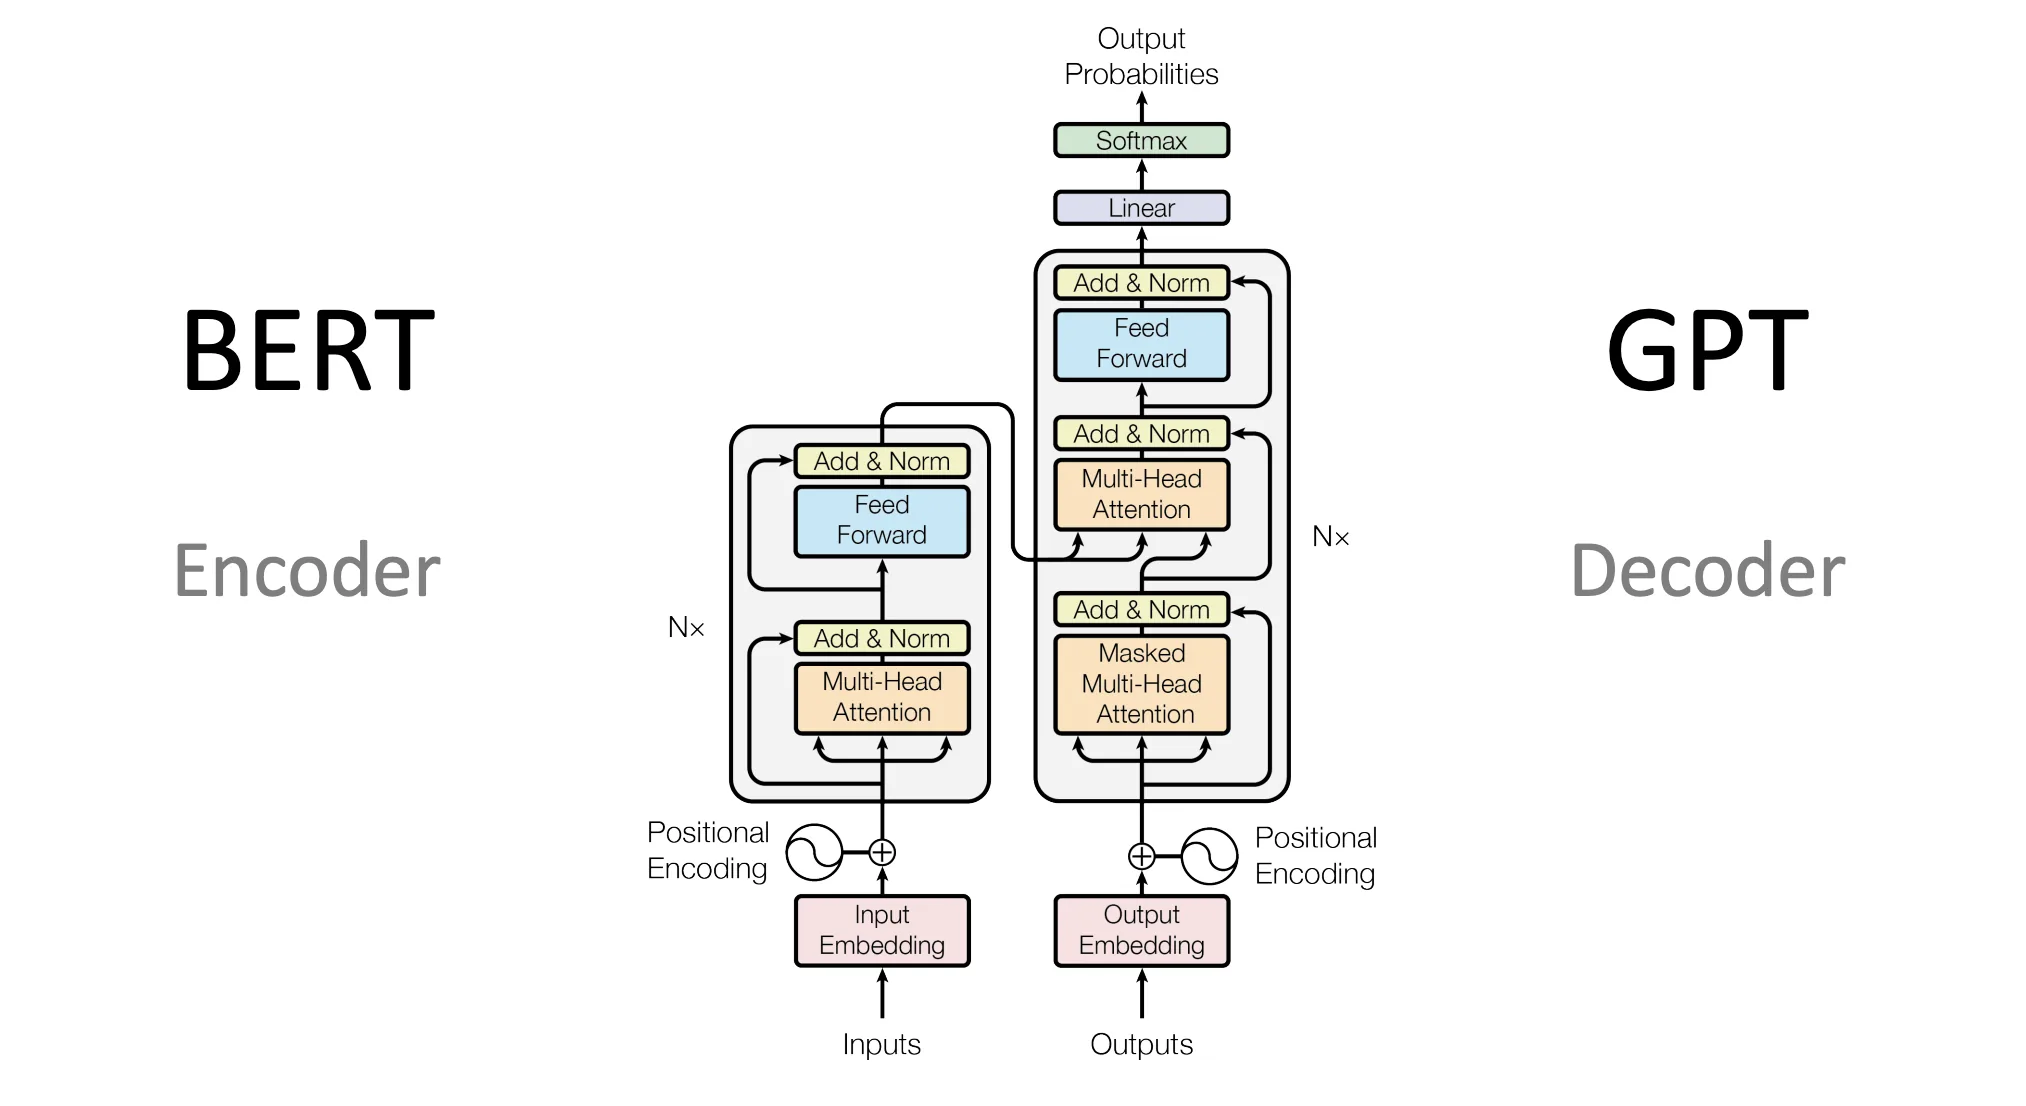
1. Архитектура энкодера (семейство BERT)
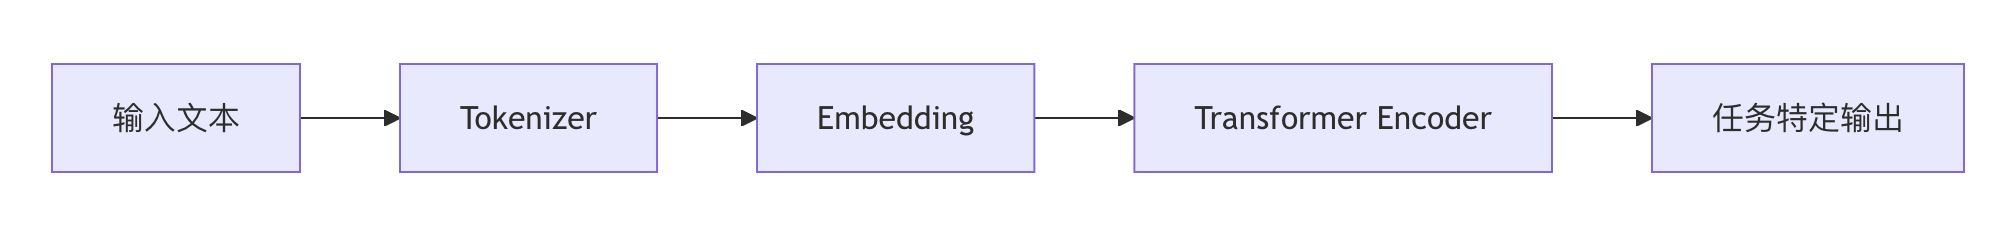
- Характеристики:
- Двунаправленное понимание контекста
- Подходит для классификации, ответов на вопросы и других задач
- Типичные модели: BERT, RoBERTa, ALBERT
2. Архитектура декодера (семейство GPT)
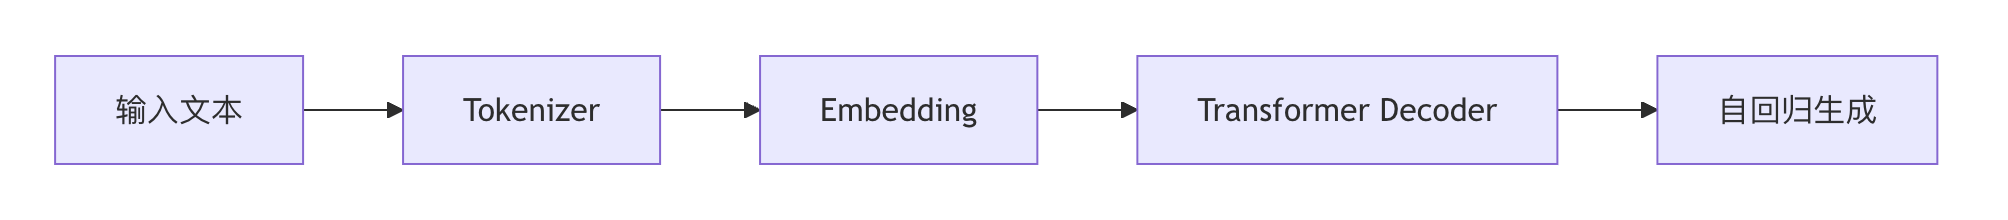
- Характеристики:
- Однонаправленный контекст (слева направо)
- Хорошо справляется с генерацией текста
- Типичные модели: GPT-3, GPT-4
3. Архитектура энкодер-декодер
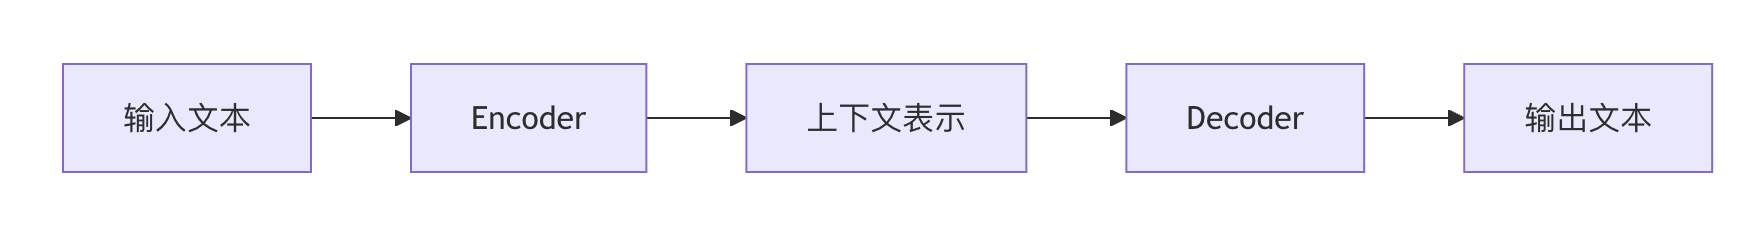
- Характеристики:
- Подходит для задач «последовательность-в-последовательность»
- Типичные модели: T5, BART
Типы задач предварительного обучения
1. Языковая модель (LM)
- Цель: предсказать следующее слово
- Формула:P(w_t | w_1, ..., w_{t-1})
2. Маскированная языковая модель (MLM)
- Пример:
- Исходное предложение: "Предварительно обученная модель очень мощная"
- После маскирования: "Предварительно обученная [MASK] очень мощная"
- Предсказание модели: "модель"
3. Предсказание следующего предложения (NSP)
- Определить, являются ли два предложения последовательными
- Положительный пример:
- Предложение A: "Предварительно обученная модель очень мощная"
- Предложение B: "Они могут справляться с несколькими задачами NLP"
- Негативный пример:
- Предложение A: "Предварительно обученная модель очень мощная"
- Предложение B: "Сегодня погода действительно отличная"
- Положительный пример:
4. Другие задачи
- Обнаружение заменённых токенов (RTD)
- Предсказание порядка предложений (SOP)
Как использовать предобученные модели
1. Использование Hugging Face Transformers
Пример
from transformers import pipeline
# Пример анализа тональности
classifier = pipeline("sentiment-analysis")
result = classifier("Предобученные модели действительно потрясающие!")
print(result) # [{'label': 'POSITIVE', 'score': 0.9998}]
# Пример анализа тональности
classifier = pipeline("sentiment-analysis")
result = classifier("Предобученные модели действительно потрясающие!")
print(result) # [{'label': 'POSITIVE', 'score': 0.9998}]
2. Процесс тонкой настройки модели
- Загрузить предобученную модель
- Подготовить набор данных для конкретной задачи
- Добавьте выходной слой для конкретной задачи
- Тонкая настройка обучения
Пример
from transformers import BertForSequenceClassification, Trainer
model = BertForSequenceClassification.from_pretrained("bert-base-chinese")
# Подготовка данных для обучения...
trainer = Trainer(model=model, args=training_args, train_dataset=train_dataset)
trainer.train()
model = BertForSequenceClassification.from_pretrained("bert-base-chinese")
# Подготовка данных для обучения...
trainer = Trainer(model=model, args=training_args, train_dataset=train_dataset)
trainer.train()
3. Описания ключевых параметров
| Параметр | Описание | Типичное значение |
|---|---|---|
| learning_rate | Скорость обучения | 2e-5 |
| batch_size | Размер батча | 16/32 |
| num_train_epochs | Количество эпох обучения | 3-5 |
| max_length | Максимальная длина последовательности | 512 |
Сценарии применения предобученных моделей
1. Классификация текста
- Анализ тональности
- Обнаружение спама
- Классификация тем
2. Системы ответов на вопросы
- Экстрактивный QA
- QA открытого домена
3. Генерация текста
- Суммаризация
- Диалоговые системы
- Создание контента
4. Другие применения
- Распознавание именованных сущностей (NER)
- Машинный перевод
- Вычисление сходства текстов
Практические рекомендации
Выбор модели:
- Для задач классификации отдавайте приоритет моделям типа BERT
- Для задач генерации выбирайте модели типа GPT
- Когда ресурсы ограничены, рассмотрите дистиллированные модели (например, DistilBERT)
Управление ресурсами:
- Уменьшите batch_size, когда памяти GPU недостаточно
- Обратите внимание на ограничения max_length при обработке длинных текстов
- Рассмотрите использование методов квантования модели
Оптимизация производительности:
- Скорость обучения требует тонкой настройки
- Ранняя остановка предотвращает переобучение
- Попробуйте разные оптимизаторы (AdamW и т. д.)
Непрерывное обучение:
- Следите за сообществом Hugging Face
- Отслеживайте последние статьи на arXiv
- Участвуйте в практике проектов с открытым исходным кодом
Направления дальнейшего развития
- Более крупный масштаб: параметры модели продолжают расти (например, триллион параметров GPT-4)
- Мультимодальное объединение: сочетание текста с изображениями и речью
- Оптимизация энергоэффективности: более эффективные методы обучения и инференса
- Адаптация к предметной области: предобученные модели для специализированных областей
- Этика и безопасность: решение таких проблем, как предвзятость и токсичность
Предобученные модели меняют технологический ландшафт в области NLP. Понимание их ключевых принципов и освоение методов применения станут необходимыми навыками для NLP-инженеров.
Другие расширения Справочник команд Linux